AMD opísalo DFlash vo vLLM na MI355X: na Qwen3.5 porovnáva vyšší výkon než MTP a ďalší zisk s mxfp4
AMD vo firemnom technickom blogu z 16. septembra 2026 popisuje nasadenie DFlash speculative decoding vo vLLM na ROCm pre GPU Instinct MI355X. Podľa benchmarkov výrobcu na modeloch Qwen3.5 DFlash pri nízkej konkurencii prekonáva natívne MTP a pri mxfp4 kvantizácii target modelu sa výkon ďalej zvyšuje, no bez nezávislého overenia a len pre uvedený softvérový stack, workloady a jednu GPU konfiguráciu.
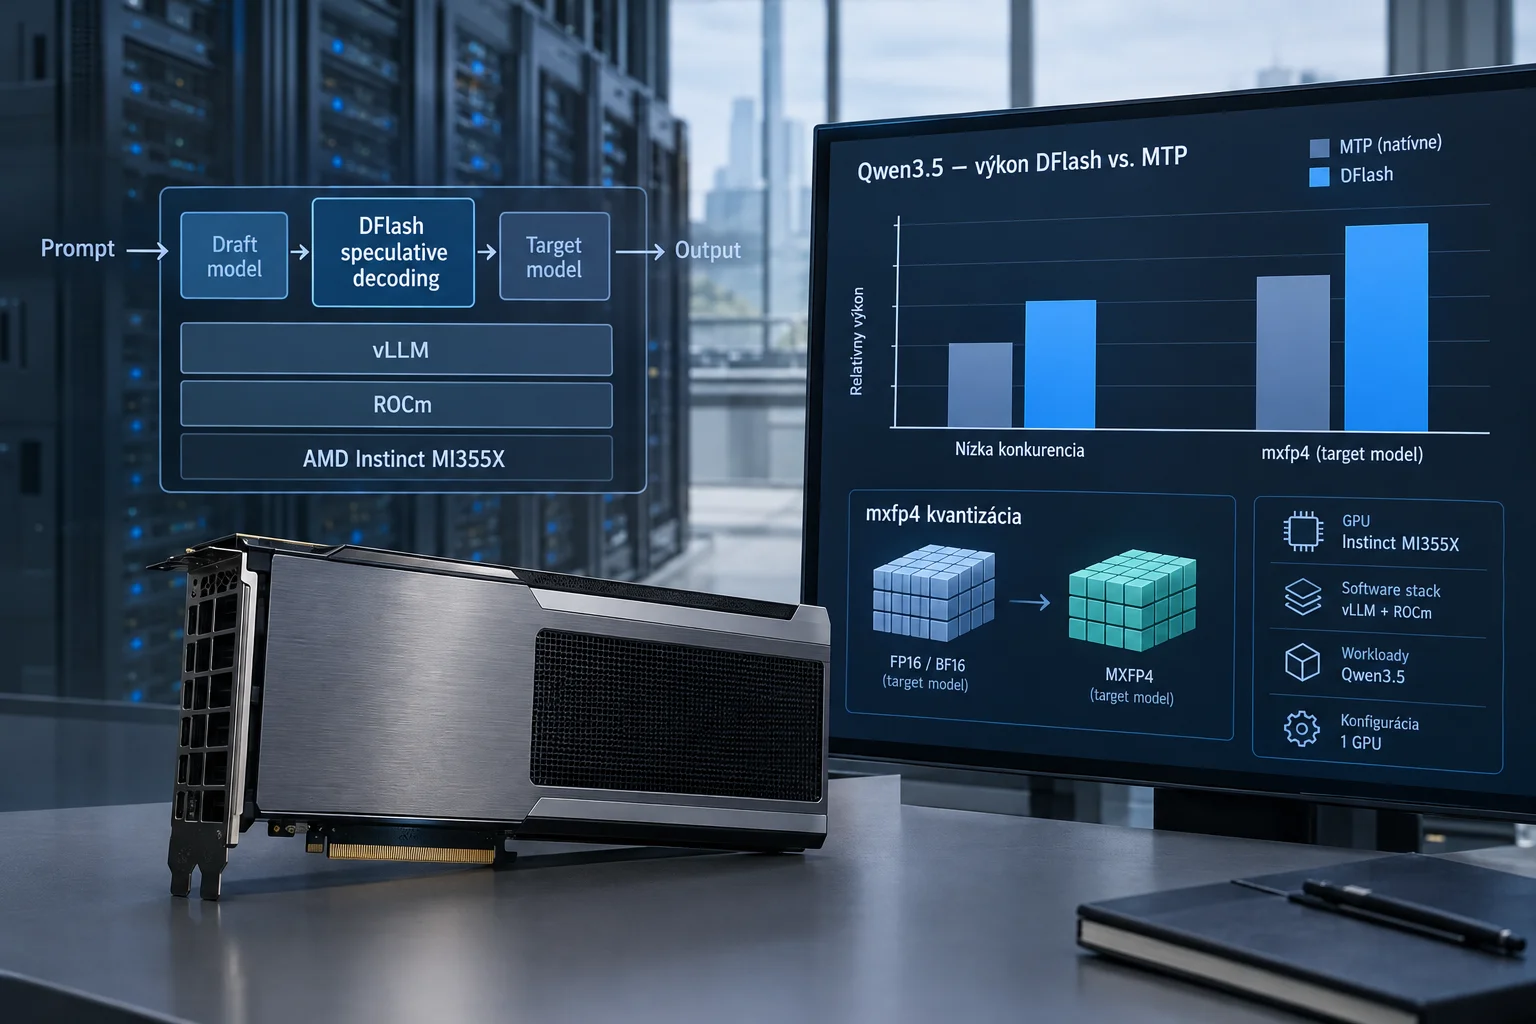
AMD v blogu ROCm z 16. septembra 2026 opisuje, ako nasadilo DFlash speculative decoding cez vLLM na ROCm pre AMD Instinct MI355X a porovnalo ho s natívnym MTP v modeloch Qwen3.5. Nejde o nezávislý test, ale o technický materiál výrobcu s explicitne uvedeným prostredím, príkazmi a benchmarkovou metodikou, takže je zaujímavý najmä ako reprodukovateľný podklad pre inference inžinierov. 1
Čo sa mení v mechanizme draftovania
Blog vysvetľuje, že bežné autoregresívne draftovanie generuje špekulatívne tokeny po jednom, takže cena draftovania rastie s dĺžkou návrhu. DFlash to mení dvoma krokmi: používa block-diffusion drafter, ktorý denoizuje celý blok dĺžky k v jednom priechode, a KV injection, kde sa hidden states cieľového modelu zapisujú priamo do KV cache draft modelu namiesto opätovného kódovania kontextu. Praktický dôsledok podľa AMD je, že väčší draft blok má podstatne menší dodatočný náklad než pri autoregresívnom draftovaní, takže sa môže zvýšiť počet prijatých tokenov na jeden verifikačný krok cieľového modelu. 1
Čo ukazujú benchmarky AMD
AMD testovalo na jednom GPU MI355X s prostredím ROCm 7.2.3, vLLM 0.22.1rc1.dev43, PyTorch 2.10.0 a modeloch Qwen3.5-27B a Qwen3.5-35B-A3B, cez workloady GSM8K, MATH500, HumanEval, MBPP a MT-Bench pri konkurencii 1 aj 32. 1
Podľa týchto meraní bol pri single-request inferencii DFlash na 27B modeli lepšou konfiguráciou než MTP na každom uvádzanom workloade a celkové zrýchlenie dosiahlo až 5,02× oproti autoregresívnemu baseline; pri 35B-A3B AMD uvádza zrýchlenie až 3,27×. Zároveň zdroj tvrdí, že prínos speculative decoding je väčší pri nízkej konkurencii, kým pri vysokej konkurencii rastie cena verifikačného kroku a zisky sa zmenšujú. To je dôležité prevádzkovo: nejde o univerzálne „zrýchlenie modelu“, ale o optimalizáciu pre konkrétny režim obsluhy. 1
Prijímanie tokenov a skladanie s kvantizáciou
Najsilnejší technický argument v texte je rast acceptance length. Na Qwen3.5-27B / HumanEval / concurrency 1 AMD uvádza pri najvyššom nastavení 10,377 prijatého tokenu na krok pre DFlash block=16 oproti 8,022 pri MTP steps=15. To podporuje tvrdenie, že block-diffusion lepšie škáluje s veľkosťou draftu než autoregresívny drafter. 1
AMD zároveň tvrdí, že mxfp4 kvantizácia target modelu sa s DFlash „skladá čisto“: acceptance sa podľa ich tabuliek mení len minimálne, zatiaľ čo absolútny throughput pri single-request inferencii stúpa približne o 10–20 %. Blog však zároveň upozorňuje, že cesta mxfp4 vo vLLM ešte nie je plne optimalizovaná a pri modeli 35B-A3B je nutné zapnúť VLLM_ROCM_USE_AITER=1 a mať AITER ≥ 0.1.16.post2, inak sa výkonový zisk stratí pri fallbacku na dequant-to-bf16. 1
Čo si z toho odniesť
Pre vývojárov AI inferencie je podstatné, že AMD nedodáva len výkonové čísla, ale aj konkrétny postup spustenia a podmienky, za ktorých ich nameralo. Zároveň však ide o vendor benchmark na jednom GPU, dvoch rodinách modelov a konkrétnom ROCm/vLLM stacku. Rozumné čítanie preto nie je „DFlash je všeobecne rýchlejší“, ale skôr: na MI355X v uvedenom stacku a pri latency-bound obsluhe AMD doložilo konzistentne lepšie výsledky než MTP a ukázalo, že tento prístup môže fungovať aj spolu s kvantizáciou target modelu. 1
Technický kontext
Stav overenia: Spracované podľa zdroja; redakcia postup nereprodukovala.
Verzie: ROCm 7.2.3, vLLM 0.22.1rc1.dev43+g8c3cc98cf, PyTorch 2.10.0, AITER 0.1.13, AITER 0.1.16.post2
Dátum pôvodného zdroja: 16. septembra 2026
Podmienky použitia: AMD Instinct MI355X v konfigurácii s jedným GPU, vLLM na ROCm, modely Qwen/Qwen3.5-27B alebo Qwen/Qwen3.5-35B-A3B, draft modely z-lab/Qwen3.5-27B-DFlash alebo z-lab/Qwen3.5-35B-A3B-DFlash. Pri mxfp4 pre 35B-A3B treba nastaviť VLLM_ROCM_USE_AITER=1 a použiť AITER aspoň 0.1.16.post2.
Obmedzenia: Jediným zdrojom je technický blog AMD, teda tvrdenia výrobcu bez nezávislého overenia. Výsledky sa vzťahujú na jednu GPU konfiguráciu MI355X, konkrétne verzie ROCm/vLLM/PyTorch/AITER, modely Qwen3.5 a uvedené workloady a úrovne konkurencie. Zdroj sám uvádza, že mxfp4 cesta vo vLLM ešte nie je plne optimalizovaná.
Claims → evidence
Tvrdenia a ich podklady
Percentá vyjadrujú redakčný odhad modelu, nie nezávisle nameranú pravdepodobnosť pravdivosti. Tvrdenia môžete porovnať s uvedenými zdrojmi.
Zdroje a atribúcie
Na ďalšie overenie
- AMD ROCm Blogs ↗DFlash Speculative Decoding on AMD Instinct MI355X: Up to 5× Faster Qwen3.5 Inference — ROCm Blogs · podklad načítaný 17. septembra 2026