AMD sprístupnilo veRL na ROCm pre Instinct GPU a ukázalo firemné merania na MI300 a MI350/MI355
AMD vo firemnom blogu z 8. septembra 2026 opisuje podporu frameworku veRL pre RL post-training na ROCm a GPU Instinct. Novinkou je pripravený kontajner, podpora rollout backendov vLLM a SGLang s AITER a séria výrobcom nameraných validačných behov na MI300 a MI350/MI355. Ide o odborný rozbor primárneho zdroja výrobcu, nie o nezávislé potvrdenie výkonu ani „production-ready“ tvrdení.
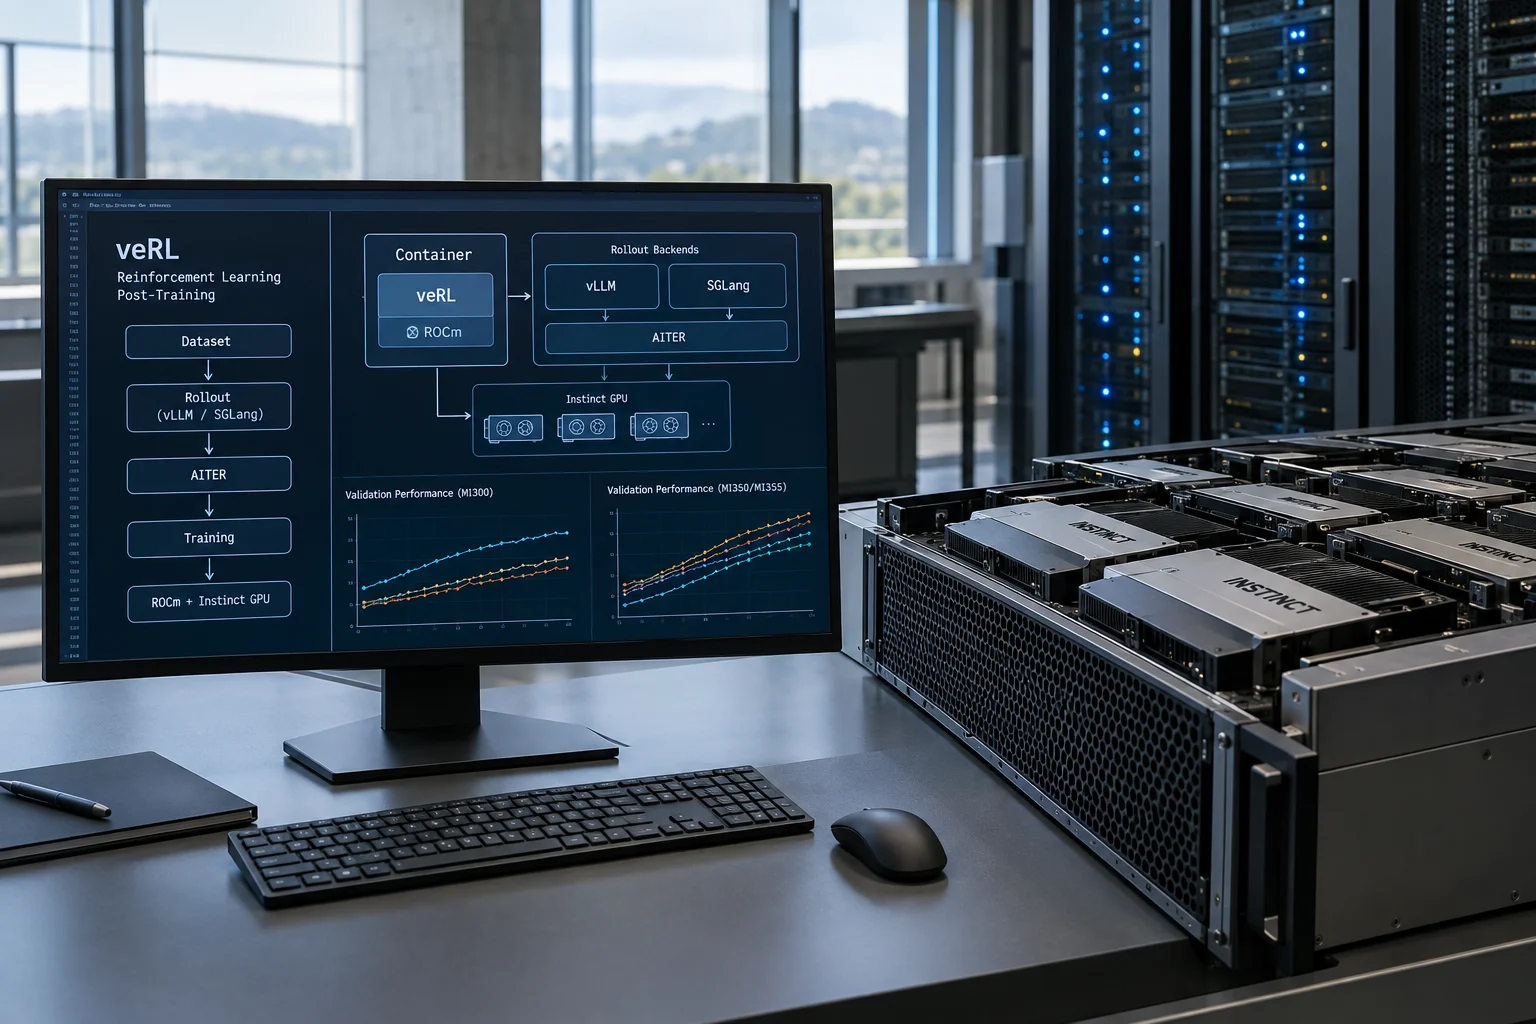
Čo AMD konkrétne oznámilo
AMD vo svojom blogu tvrdí, že open-source framework veRL je pripravený na RL post-training na platforme ROCm pre GPU AMD Instinct. Praktická zmena podľa zdroja spočíva v tom, že tím nemá skladať prostredie ručne: AMD uvádza pripravený kontajner verlai/verl:rocm7.14_torch2.12_release_0724, v ktorom sú spolu pribalené ROCm, PyTorch, Triton, vLLM, SGLang, AITER, TransformerEngine a Megatron-core. Zdroj zároveň uvádza podporu architektúr gfx942 pre radu MI300 a gfx950 pre radu MI350. 1
Mechanizmus: kontajner, rollout backendy a dva režimy behu
Pre vývojárov je podstatné, že nejde len o jednorazový príklad, ale o opísaný stack pre tréningové workflow. AMD uvádza dva rollout backendy na ROCm: vLLM a SGLang. Obe cesty majú podľa blogu využívať knižnicu AITER pre akceleráciu kernelov, napríklad pre attention, RMSNorm, RoPE, MoE a kvantizáciu. 1
Zdroj ďalej rozlišuje dva prevádzkové režimy, ktoré sú pri RL post-training dôležité aj prevádzkovo. V colocated režime zdieľajú rollout a tréning tie isté GPU. Vo fully-async režime bežia rollout a tréning súbežne na oddelených GPU a parametre sa priebežne synchronizujú späť k rollout workerom. To je konkrétna zmena s praktickým významom: AMD sa nesnaží hovoriť len o kompatibilite s jedným backendom, ale o celej prevádzkovej schéme, ktorú tímy bežne riešia pri RL fine-tuningu väčších modelov. 1
Čo výrobca doložil meraniami
Najsilnejšou časťou blogu sú konkrétne výrobcom zverejnené behové konfigurácie. Pri Qwen3-8B GRPO so SGLang na jednom uzle s 8 GPU AMD uvádza rast validačnej presnosti na GSM8K približne z 0,82 na 0,955 až 0,956 a na MATH z 0,37 na približne 0,835 až 0,839. 1
Pri Qwen2.5-Math-7B DAPO v fully-async režime na MI300 s 32 GPU blog uvádza maximum validačnej presnosti 0,34 a porovnanie s referenčným upstream výsledkom 0,33 pre rovnaké nastavenie. V tom istom experimente AMD píše, že fully-async režim mal medián času na tréningový krok približne 219 s oproti 394 s pri colocated baseline, teda asi 1,8× zrýchlenie na krok pri rovnakej 32-GPU stope. 1
Pri Qwen3.5-35B-A3B MoE na MI350 zdroj uvádza stabilnú konvergenciu v colocated aj fully-async režime a throughput približne 310 tok/s/GPU vo fully-async oproti 216 tok/s/GPU v colocated režime, teda asi 1,4× vyšší priechod na GPU. 1
Praktický význam a hranice poznania
Pre infraštruktúrne tímy je prínos tohto oznámenia zrejmý: ak už používajú veRL alebo hodnotia RL post-training mimo CUDA stacku, blog dáva konkrétny obraz o podporovaných backendoch, integračných režimoch a príkladových konfiguráciách na AMD hardvéri. Zdroj tiež uvádza, že zmeny vo veRL sa pred zlúčením validujú v CI na reálnom AMD hardvéri, hoci pokrytie označuje za rozpracované. 1
Treba však jasne oddeliť doložené fakty od marketingu. Označenie „production-ready“ je tvrdenie výrobcu, nie nezávisle overený záver. Rovnako výsledky pre MI355 sú v blogu čiastočne odvodené z behov na MI350 s argumentom, že obe karty zdieľajú gfx950 a líšia sa najmä napájaním a chladením; nejde teda o samostatne predvedený kompletný súbor meraní pre každé nasadenie na MI355. Blog je preto užitočný ako technický rozbor podporovaného stacku a zverejnených konfigurácií, nie ako nezávislé potvrdenie všeobecnej parity s inými platformami alebo bezproblémovej produkčnej prevádzky. 1
Technický kontext
Stav overenia: Spracované podľa zdroja; redakcia postup nereprodukovala.
Verzie: verlai/verl:rocm7.14_torch2.12_release_0724, gfx942, gfx950
Dátum pôvodného zdroja: 8. septembra 2026
Podmienky použitia: Podľa zdroja ide o nasadenie frameworku veRL na ROCm s GPU AMD Instinct. Blog opisuje pripravený kontajner, rollout backendy vLLM a SGLang, akceleráciu AITER a príkladové tréningové režimy colocated a fully-async.
Obmedzenia: K dispozícii je jediný primárny zdroj výrobcu AMD. Tvrdenia o „production-ready“, kvalite a výkone nie sú nezávisle overené. Merania sú viazané na konkrétne modely, datasety, backendy a konfigurácie uvedené v blogu. Zdroj výslovne uvádza, že pokrytie CI na AMD je ešte rozpracované. Výsledky pre MI355 sú v texte čiastočne odvodzované z MI350 pri rovnakom gfx950, nie samostatne plne doložené pre všetky scenáre.
Claims → evidence
Tvrdenia a ich podklady
Percentá vyjadrujú redakčný odhad modelu, nie nezávisle nameranú pravdepodobnosť pravdivosti. Tvrdenia môžete porovnať s uvedenými zdrojmi.
Zdroje a atribúcie
Na ďalšie overenie
- AMD ROCm Blogs ↗veRL on AMD: Production-Ready RL Post-Training on ROCm — ROCm Blogs · podklad načítaný 15. septembra 2026