Anthropic opísal auto mode v Claude Code: delegované povoľovanie akcií pre agenta
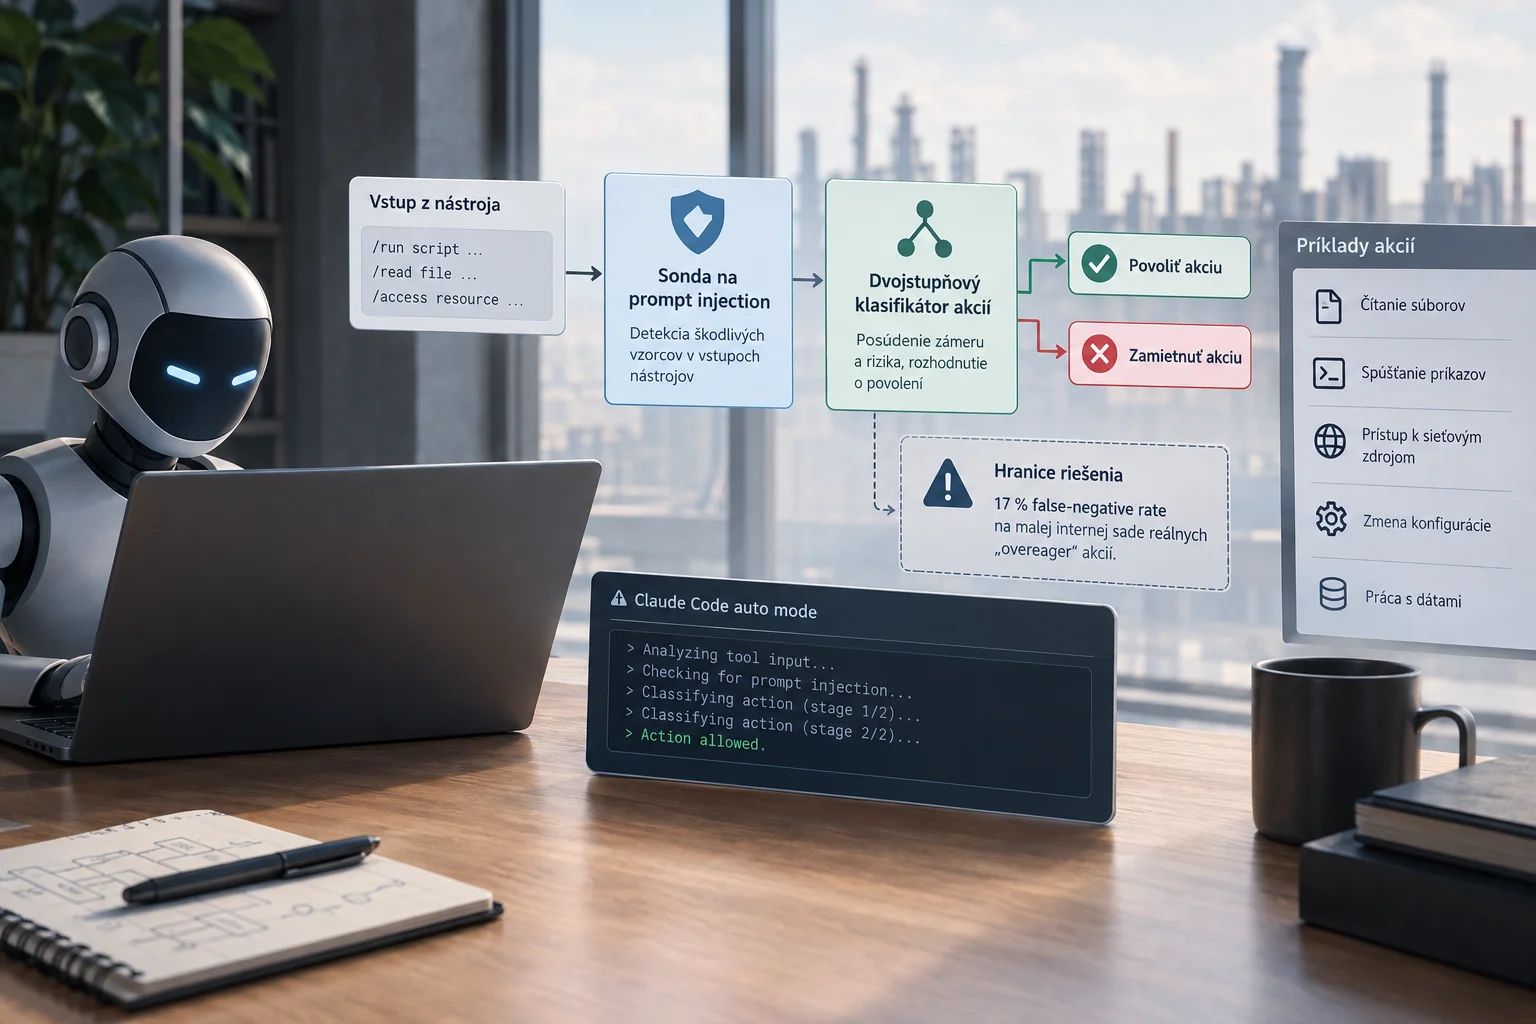
Anthropic 25. marca 2026 zverejnil technický rozbor funkcie Claude Code auto mode. Podľa výrobcu ide o režim, ktorý nahrádza časť ručných povolení dvojvrstvovou kontrolou: sondou na prompt injection vo vstupoch nástrojov a dvojstupňovým klasifikátorom akcií. Text je zaujímavý najmä tým, že priznáva aj hranice riešenia vrátane 17 % false-negative rate na malej internej sade reálnych „overeager“ akcií.
Hlavné poznatky
- Anthropic opisuje auto mode v Claude Code ako dostupnú funkciu, nie len plán, no dôkazy o jej vlastnostiach pochádzajú výlučne od výrobcu. [ev-3524ff856fa9d444831c]
- Architektúra kombinuje dve vrstvy: prompt-injection sondu na vstupe a dvojstupňový klasifikátor akcií na výstupe. [ev-3524ff856fa9d444831c]
- Výrobca uvádza 0,4 % FPR na internej prevádzke, ale aj 17 % FNR na malej sade reálnych nebezpečných akcií, takže nejde o náhradu starostlivej ľudskej kontroly. [ev-3524ff856fa9d444831c]
Čo Anthropic zmenil
Anthropic vo svojom technickom článku z 25. marca 2026 predstavil auto mode pre Claude Code ako stred medzi ručným schvaľovaním akcií a úplným vypnutím povolení cez --dangerously-skip-permissions. Podľa firmy má režim znížiť „approval fatigue“, keďže používatelia vraj schvaľujú 93 % permission promptov, no zároveň nemá ponechať agenta bez zábran. 1
Dôležité je, že nejde o nezávisle overený benchmark bezpečnosti, ale o opis architektúry a interných meraní priamo od výrobcu. Napriek tomu je podklad prakticky užitočný pre tímy, ktoré navrhujú guardrails pre agentov a povoľovanie nástrojov. 1
Ako mechanizmus funguje
Anthropic opisuje dve vrstvy obrany. Na vstupe je server-side prompt-injection probe, ktorá prezerá výstupy nástrojov ešte predtým, než sa dostanú do kontextu agenta. Keď obsah vyzerá ako pokus presmerovať správanie modelu, sonda pridá varovanie, aby agent považoval takýto obsah za podozrivý a držal sa pôvodnej požiadavky používateľa. 1
Na výstupe stojí transcript classifier bežiaci na Sonnet 4.6. Ten hodnotí akcie pred vykonaním a má nahrádzať ľudského schvaľovateľa. Klasifikácia je dvojstupňová: najprv rýchly filter s odpoveďou áno/nie, ktorý je nastavený opatrne smerom k blokovaniu, a až pri podozrivých prípadoch sa spúšťa druhý krok s chain-of-thought uvažovaním. Výrobca tvrdí, že takto šetrí latenciu a náklady, pretože väčšina akcií druhý stupeň vôbec nepotrebuje. 1
Zaujímavé je aj to, čo klasifikátor nevidí. Anthropic z neho zámerne odstraňuje vlastné správy asistenta aj výstupy nástrojov; zostávajú len používateľské správy a samotné tool cally. Cieľom je, aby agent klasifikátor „neukecal“ vlastným vysvetlením a aby sa znížil priestor pre prompt injection cez tool output. 1
Praktický význam pre návrh agentov
Auto mode podľa článku pracuje s tromi úrovňami povolení. Bez klasifikátora prejdú bezpečné nástroje na allowliste a tiež zápisy či úpravy súborov v rámci projektu; naopak shell príkazy, web fetch, externé integrácie, operácie mimo projektového adresára a subagenti idú do klasifikátora. Pri vstupe do auto mode sa navyše zahadzujú široké always-allow pravidlá, ktoré by inak povoľovali arbitrárne spustenie kódu, napríklad blanket shell access alebo wildcard pravidlá pre interpretre. 1
Pre vývojárov agentických systémov je to použiteľný návrhový vzor: bezpečné operácie sa snaží vybaviť lacno, rizikové akcie posiela do samostatnej politiky a prompt injection nerieši jednou kontrolou, ale kombináciou vstupnej a výstupnej vrstvy. 1
Čo hovoria čísla a kde sú hranice
Anthropic zverejnil interné výsledky na troch datasetoch: 10 000 reálnych interných tool callov, 52 reálnych „overeager“ akcií a 1 000 syntetických úloh zameraných na exfiltráciu dát. Pri nasadenom dvojstupňovom pipeline firma uvádza false positive rate 0,4 % na reálnej prevádzke, false-negative rate 17 % na sade reálnych nebezpečných akcií a 5,7 % false-negative rate na syntetickej exfiltrácii. 1
Najdôležitejšia časť článku je možno tá najtriezvejšia: Anthropic výslovne píše, že 17 % false-negative rate je „honest number“ a že auto mode nie je náhradou za starostlivé ľudské schvaľovanie pri high-stakes infraštruktúre. Firma ho rámcuje skôr ako bezpečnejšiu alternatívu k režimu bez povolení než ako plnohodnotnú náhradu manuálnej kontroly. To je pre čitateľa prakticky podstatnejšie než samotný marketing okolo autonómie. 1
Technický kontext
Stav overenia: Spracované podľa zdroja; redakcia postup nereprodukovala.
Verzie: Claude Code auto mode, Sonnet 4.6
Dátum pôvodného zdroja: 25. marca 2026
Podmienky použitia: Základná znalosť agentov, shell nástrojov, povolení akcií a obrany proti prompt injection.
Obmedzenia: Opis aj výsledky pochádzajú od výrobcu; nejde o nezávislý test. Článok priznáva zvyškové riziko a nevhodnosť ako náhrady ľudského schvaľovania pri high-stakes infraštruktúre.
Claims → evidence
Tvrdenia a ich podklady
Percentá vyjadrujú redakčný odhad modelu, nie nezávisle nameranú pravdepodobnosť pravdivosti. Tvrdenia môžete porovnať s uvedenými zdrojmi.
Zdroje a atribúcie
Na ďalšie overenie
- Anthropic Engineering ↗How we built Claude Code auto mode: a safer way to skip permissions \ Anthropic · podklad načítaný 17. septembra 2026