Google opísal autofinetune na Cloud TPU: agentické post-training slučky pre SFT a GRPO
Google Developers Blog 11. septembra 2026 predstavil projekt autofinetune: agentický workflow pre post-training LLM na Cloud TPU s Tunix, Gemma a pomocnými nástrojmi. Podklad ukazuje mechanizmus automatizovaných experimentov pre SFT aj GRPO, no výkonové zlepšenia sú doložené len ako tvrdenia pôvodcu v ukážkových behoch.
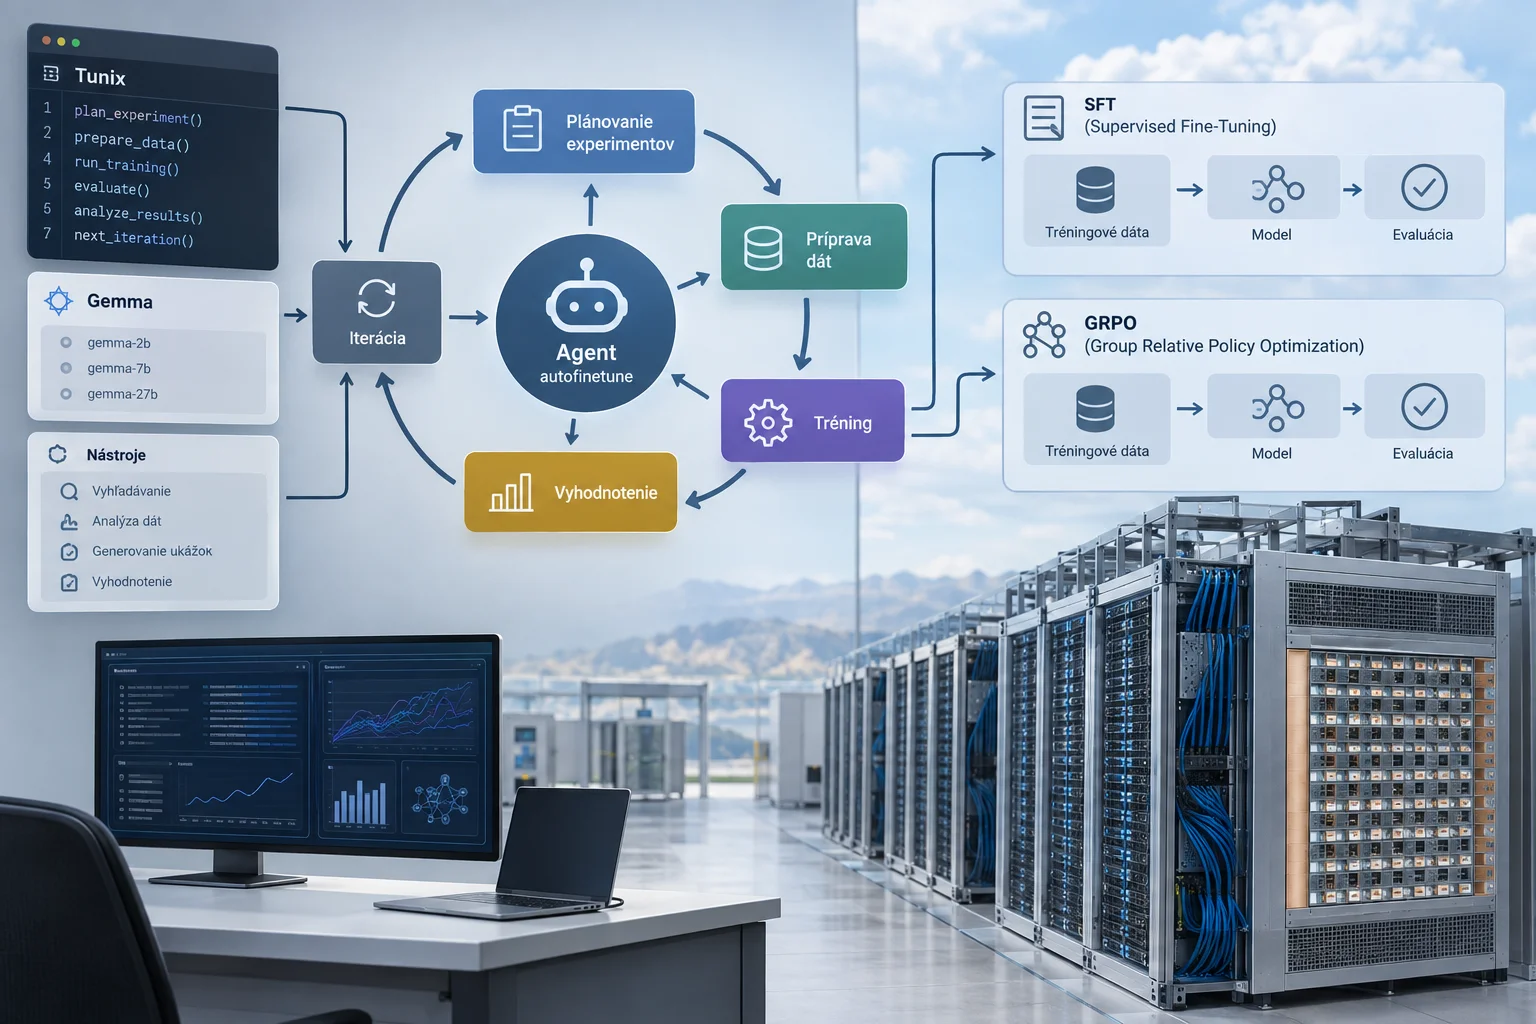
Google vo svojom technickom blogu 11. septembra 2026 predstavil projekt autofinetune, ktorým prenáša agentické „autoresearch“ slučky z oblasti pre-trainingu do LLM post-trainingu. Podľa textu ide o workflow postavený na nástrojoch Tunix, Gemma, Cloud TPU, orchestrace cez Antigravity CLI a modeli Gemini Flash 3.7 ako agentovi, ktorý iteruje nad tréningovým skriptom a vyhodnocuje výsledky.1
Čo sa mení oproti ručnému ladeniu
Blog opisuje pomerne konkrétny mechanizmus. Človek najprv pripraví súbor program.md, kde určí hranice experimentu, metriky a obmedzenia. Druhým vstupom je run.py, teda samostatný finetuning skript. Agent potom podľa Google opakovane upravuje run.py, spúšťa tréningové joby, meria cieľovú metriku, zachováva víťazné commity, regresie vracia späť a výsledky zapisuje do results.tsv.1
Praktický význam tejto zmeny je v tom, že blog nehovorí len o jednom „AI pomocníkovi“, ale o uzavretej slučke pre sériu experimentov. Pre tímy, ktoré dnes manuálne skúšajú LoRA rank, learning rate, batch size či plán warmupu, je dôležité najmä to, že Google opisuje automatizáciu celého cyklu od zmeny konfigurácie po vyhodnotenie a správu verzií.1
Dve ukážky: SFT a GRPO
Prvá prípadová štúdia sa týka supervised fine-tuningu modelu google/functiongemma-270m-it na datasete google/mobile-actions. Google uvádza hardvér Cloud TPU v5e-1, približne niekoľkominútové iterácie, spolu 20 automatizovaných experimentov počas niekoľkých hodín a cieľovú metriku presnosti generovania function callov. Zároveň boli v program.md povolené zásahy do parametrov ako LoRA rank/alpha, cieľové projekčné vrstvy, learning rate, warmup/decay, optimizer, gradient clipping, batch size a seed; zmeny datasetu, počtu epoch a architektúry modelu naopak povolené neboli.1
Druhá ukážka posúva workflow do reinforcement learningu cez GRPO. Blog hovorí o oficiálnom príklade z repozitára Tunix, kde sa trénuje Gemma 3 1B na úlohách matematického uvažovania s datasetom GSM8K. Tu Google uvádza Cloud TPU v6e-1, iterácie v rozsahu niekoľkých hodín a 40 experimentov počas 2 až 3 dní. Vonkajšia optimalizácia bola podľa zdroja zjednodušená na umelú metriku Post_RL_metric = numerical_accuracy + format_accuracy.1
Čo je doložené a čo nie
Najsilnejšou časťou podkladu je opis mechanizmu: vstupy, hranice zásahov, typy parametrov aj evidencia výsledkov sú pomenované konkrétne. To je užitočné pre inžinierov, ktorí chcú podobný workflow postaviť nad vlastným tréningovým skriptom.1
Opatrnejšie treba čítať výkonové tvrdenia. Google pri RL ukážke píše, že agent našiel lepšie LoRA konfigurácie, rollout temperature, KL penalty či system prompt a zlepšil celkovú odmenu asi o 10 %. V tomto balíku však ide len o tvrdenie pôvodcu z ukážkového behu; podklad neposkytuje nezávislé overenie, rozptyl medzi behmi ani porovnanie mimo Google stacku.1
Rovnako dôležité je nepliesť si tento blog s oznámením široko dostupného produktu. Zdroj spoľahlivo dokladá technický opis projektu a dvoch demonštračných scenárov na Cloud TPU, nie všeobecne overený štandard pre post-training LLM naprieč infraštruktúrami.1
Technický kontext
Stav overenia: Spracované podľa zdroja; redakcia postup nereprodukovala.
Verzie: Gemini Flash 3.7, Gemma 3 1B, Cloud TPU v5e-1, Cloud TPU v6e-1
Dátum pôvodného zdroja: 11. septembra 2026
Podmienky použitia: Podklad predpokladá workflow pre LLM post-training so súborom program.md na definovanie hraníc experimentu, samostatným tréningovým skriptom run.py a prístupom ku Cloud TPU. Opisované príklady používajú Tunix a modely Gemma.
Obmedzenia: K dispozícii je jediný primárny vendorový zdroj. Výsledky v SFT a GRPO sú opísané ako ukážkové behy bez nezávislej validácie, bez štatistiky variability a bez potvrdenia reprodukovateľnosti mimo Google stacku. RL príklad používa umelú metriku Post_RL_metric, takže nejde o všeobecný benchmark odvetvia. Dostupnosť sľubovaného kódu a repozitára nie je v tomto balíku samostatne overená.
Claims → evidence
Tvrdenia a ich podklady
Percentá vyjadrujú redakčný odhad modelu, nie nezávisle nameranú pravdepodobnosť pravdivosti. Tvrdenia môžete porovnať s uvedenými zdrojmi.
Zdroje a atribúcie
Na ďalšie overenie
- Google Developers Blog ↗Autonomous LLM post-training with Tunix on TPUs - Google Developers Blog · podklad načítaný 15. septembra 2026