KInIT opísal prototyp sémantického vyhľadávania pre SVOP na Slovensku
Kempelen Institute of Intelligent Technologies zverejnil opis trojmesačného projektu pre partnera SVOP, v ktorom nahradil čisto slovné fulltextové vyhľadávanie prototypom sémantického vyhľadávania. Podklad ukazuje konkrétnu architektúru s embeddingmi dokumentov, vektorovou databázou Milvus a prevodom dotazu do rovnakého vektorového priestoru, no bez zverejnených metrík presnosti či latencie.
Čo KInIT zverejnil
Kempelen Institute of Intelligent Technologies (KInIT) publikoval 17. júla 2026 opis projektu SVOP semantic search, ktorý podľa zdroja prebiehal približne od októbra do decembra 2024 a trval tri mesiace. Cieľom bolo zlepšiť fulltextové vyhľadávanie tak, aby nevracalo výsledky len podľa zhody slov, ale podľa významovej podobnosti textu. Podklad treba čítať ako firemný odborný rozbor prototypu, nie ako nezávisle overený benchmark ani ako oznámenie všeobecne dostupného produktu. 1
Ako bolo riešenie postavené
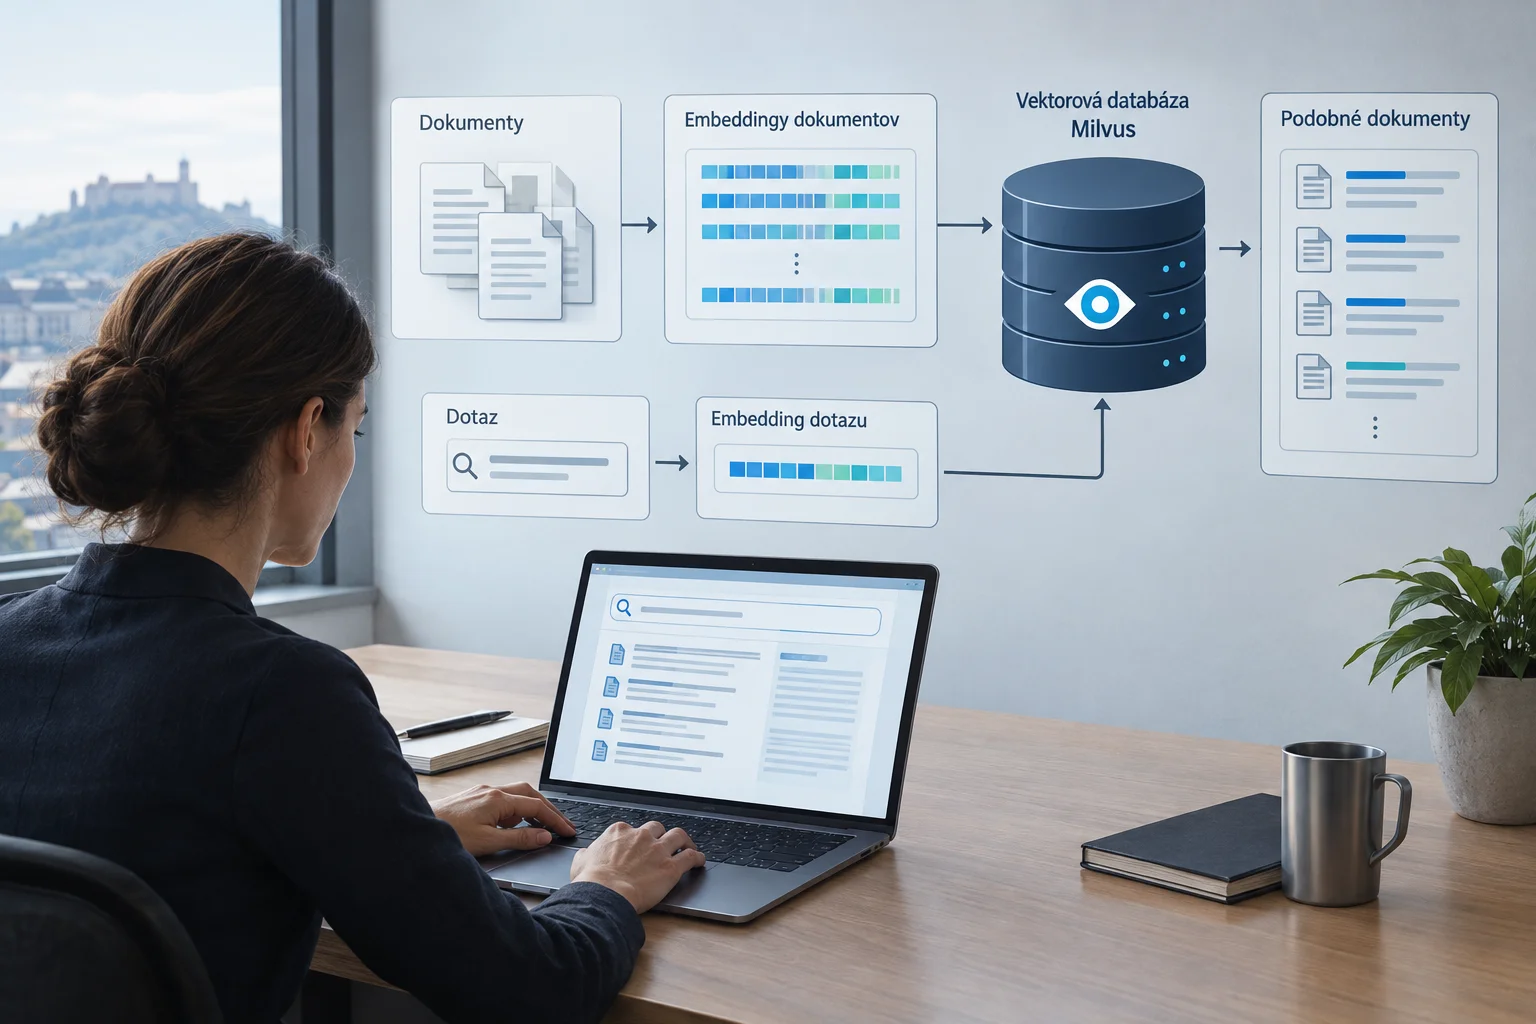
KInIT opisuje architektúru postavenú okolo vektorovej databázy Milvus. Celé dokumenty sa najprv prevádzali na vektory pomocou embedding modelu od OpenAI a tieto reprezentácie sa ukladali do databázy Milvus. Pri dotaze sa používateľský vstup previedol tým istým embedding modelom do rovnakého vektorového priestoru a systém potom vyhľadával dokumenty s najpodobnejšími vektormi. Z technického hľadiska ide o typický postup pre sémantické vyhľadávanie: namiesto presnej textovej zhody porovnáva významové reprezentácie dokumentov a dotazov. 1
Zdroj zároveň uvádza, že riešenie testovali viacerými prístupmi s cieľom overiť kvalitu a presnosť vracaných výsledkov. Tým je doložené, že nešlo len o statickú ukážku architektúry, ale o prototyp, ktorý prešiel aspoň interným testovaním. KInIT však nezverejnil použitý dataset, baseline, konkrétne metriky, latenciu ani náklady prevádzky, takže z podkladu nemožno vyvodiť mieru zlepšenia ani porovnávať riešenie s inými implementáciami. 1
Praktický význam pre tímy
Najpraktickejšia časť podkladu nie je marketingové tvrdenie o „lepšom AI“, ale prenositeľný návrh architektúry. Pre tímy, ktoré riešia enterprise search, interné znalostné bázy alebo vyhľadávanie podobných dokumentov, je užitočné, že zdroj jasne opisuje tri kroky: embedding dokumentov, embedding dotazov a porovnanie vo vektorovej databáze. Tento mechanizmus je použiteľný aj ako základ pre vyhľadávaciu vrstvu nad firemnými dokumentmi, kde býva problémom variabilná slovná zásoba používateľov. 1
Ďalší praktický bod je uvedený pri odovzdaní výsledku. KInIT píše, že partner následne použil dodané riešenie ako referenciu na implementáciu vlastného systému sémantického vyhľadávania postaveného na ElasticSearch. To naznačuje, že hodnota projektu nebola iba v jednorazovom prototype na Milvus, ale aj v overení smeru, ktorý sa dal preniesť do iného technologického stacku. Podklad však neuvádza, do akej miery sa finálny systém zhodoval s pôvodným prototypom ani aké výsledky dosahoval po prenose. 1
Hranice toho, čo vieme
KInIT aj partner v citáciách hovoria o zlepšení a o nových poznatkoch, ale bez zverejnených metrík zostávajú tieto hodnotenia tvrdeniami zúčastnených strán. Doložené je, že projekt existoval, akú mal architektúru, že bol testovaný a že partner naň nadviazal vlastnou implementáciou v ElasticSearch. Nedoložené sú presné prínosy v kvalite vyhľadávania, robustnosti či prevádzkových parametroch. Preto je najpresnejšie tento prípad označiť ako zdokumentovaný slovenský prototyp s jasne opísaným mechanizmom a obmedzenou dôkaznosťou výsledkov. 1
Technický kontext
Stav overenia: Spracované podľa zdroja; redakcia postup nereprodukovala.
Verzie: Zdroj neuvádza konkrétne verzie.
Dátum pôvodného zdroja: 17. júla 2026
Podmienky použitia: Znalosť základov fulltextového a sémantického vyhľadávania, embeddingov, vektorových databáz a práce s dokumentovými korpusmi. Zdroj výslovne spomína Milvus, OpenAI embedding model a následnú implementačnú referenciu pre ElasticSearch.
Obmedzenia: K dispozícii je jediný primárny zdroj od KInIT. Zdroj neuvádza konkrétny model OpenAI, dataset, baseline, metriky presnosti, latenciu, náklady ani test report. Citácie KInIT a partnera nemožno považovať za nezávislé overenie výkonu. Podklad opisuje prototyp a následnú referenčnú implementáciu partnera, nie všeobecne dostupný produkt.
Claims → evidence
Tvrdenia a ich podklady
Percentá vyjadrujú redakčný odhad modelu, nie nezávisle nameranú pravdepodobnosť pravdivosti. Tvrdenia môžete porovnať s uvedenými zdrojmi.
Zdroje a atribúcie
Na ďalšie overenie
- Kempelen Institute of Intelligent Technologies ↗SVOP: Improving document retrieval accuracy through semantic search - KInIT · podklad načítaný 15. septembra 2026