Malý ColGrep-Agent hľadá kód za veľký model. Úspora tokenov má časovú cenu
LightOn ukazuje dvojmiliardový model na orientáciu v repozitári. Výsledky oddeľujú nájdenie súborov od samotnej opravy programu.
Vyhľadávanie je samostatná práca
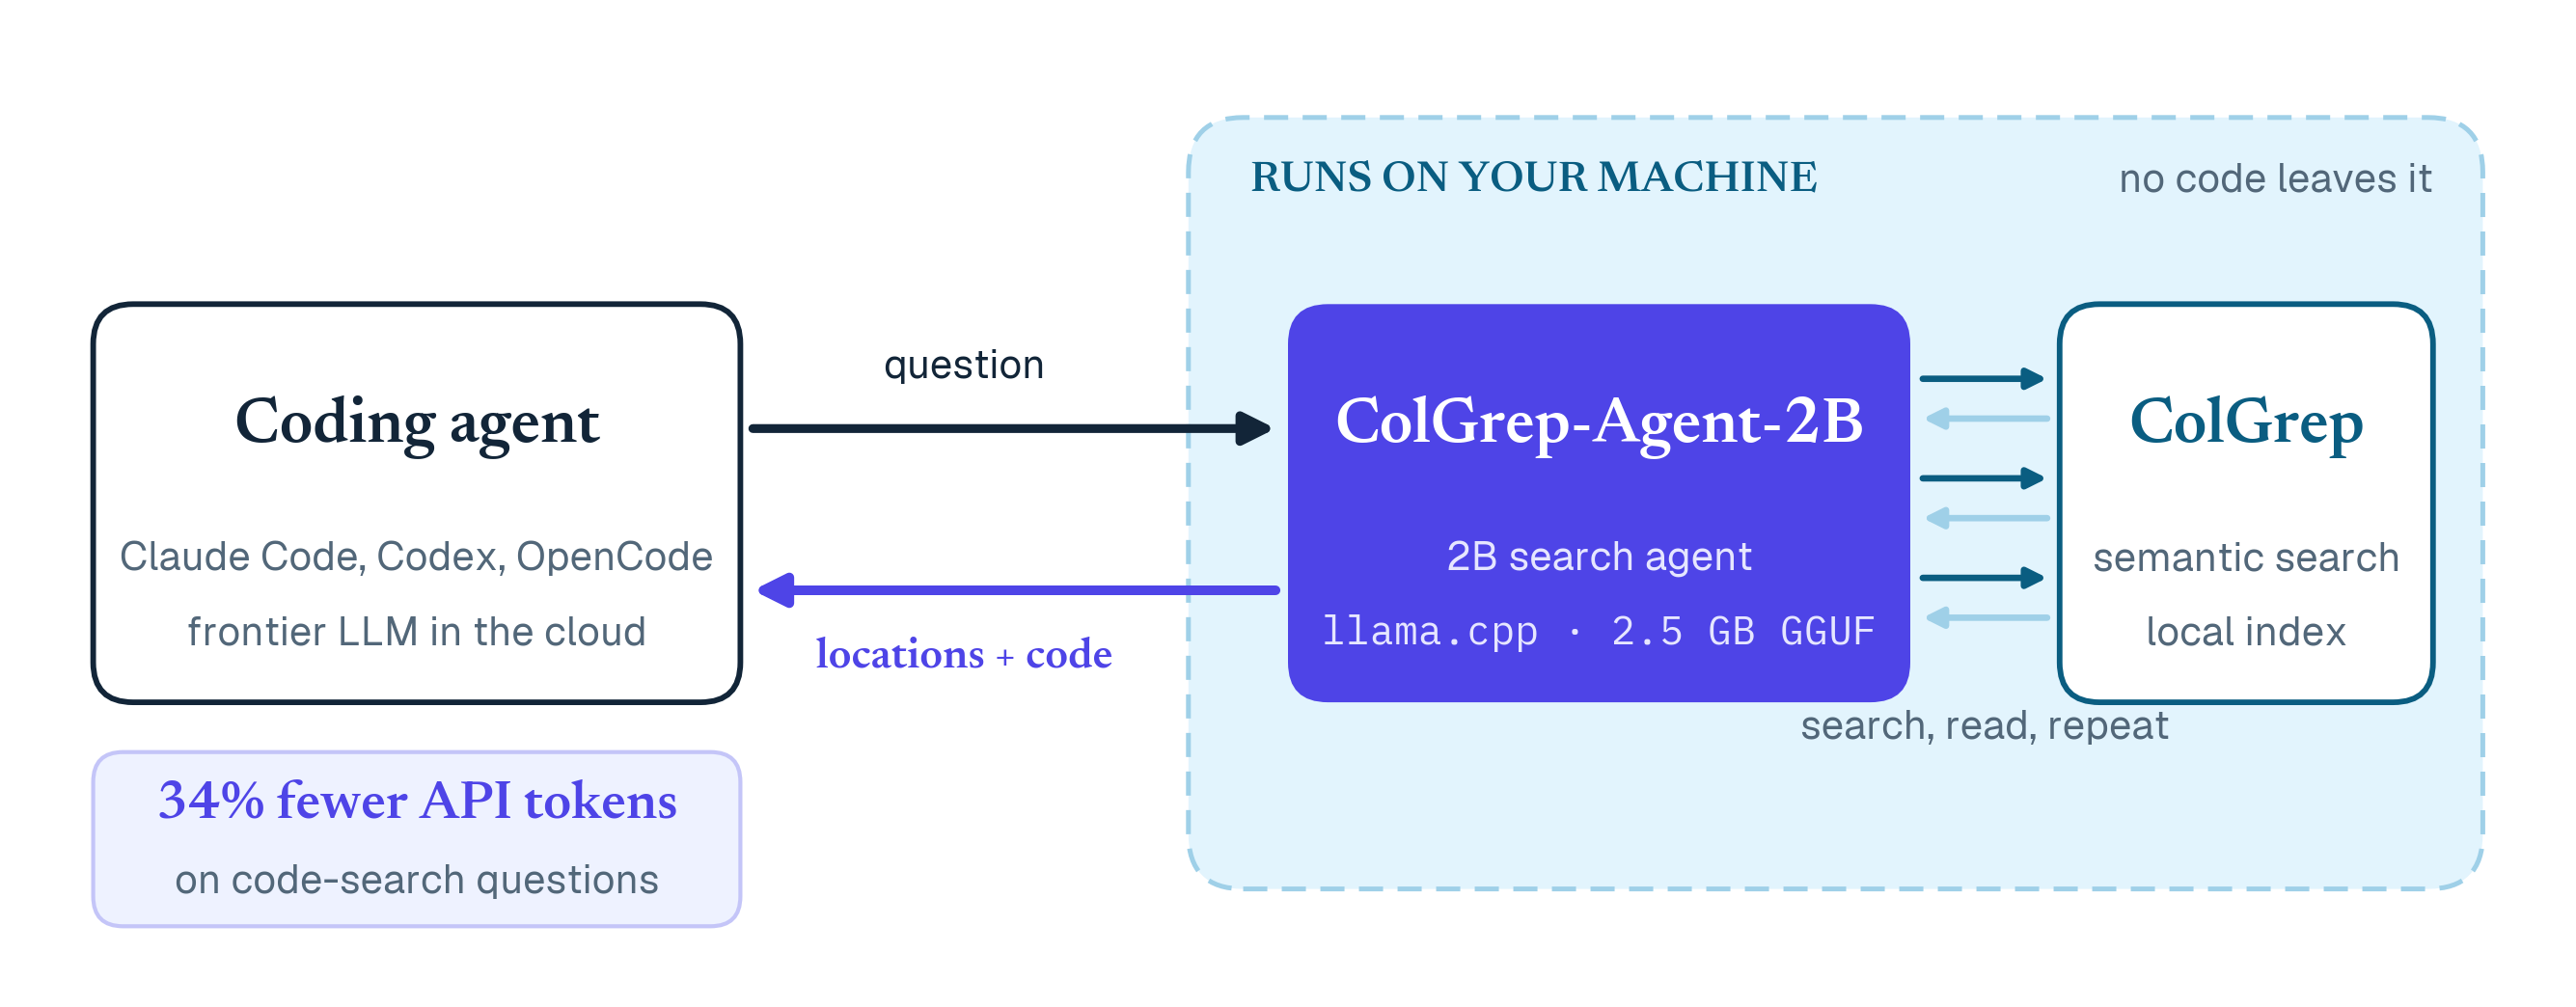
Keď programovací agent nepozná názvy funkcií v projekte, môže minúť veľa krokov na odhadovanie správnych výrazov. LightOn predstavil ColGrep-Agent ako menšieho pomocníka, ktorý má nájsť relevantné súbory a riadky skôr, než hlavný model začne pripravovať zmenu. Podklady tvorí autorský príspevok LightOn na Hugging Face a modelová karta; nejde o nezávislé hodnotenie platformy Hugging Face.
Model má dve miliardy parametrov a pracuje nad nástrojom ColGrep. Výstupom sú konkrétne miesta v kóde. Úspešná lokalizácia však ešte nie je vyriešená chyba ani otestovaný patch.
Opis správania sa nemusí zhodovať s názvom funkcie
ColGrep kombinuje sémantické hľadanie s filtrami podľa ciest a regulárnymi výrazmi. Pomocný agent môže preskúmať nájdený súbor, sledovať odkaz a zopakovať vyhľadávanie. Má obmedzený počet krokov a vracia lokácie, ktoré si hlavný programovací agent ďalej overuje.
Autori ilustrujú problém na otázke o vlastných atribútoch záznamu: projekt ich interne označuje ako polia. Vyhľadávanie podľa významu môže preklenúť rozdiel slovníka bez série slepých pokusov. Index aj inferencia pomocného modelu môžu bežať lokálne, čo oddeľuje vyhľadanie kódu od odosielania kontextu hlavnej službe.
Menej tokenov nemusí znamenať kratšie čakanie
V meraní autorov klesol priemerný počet kôl hlavného agenta z 5,5 na 3,9. Celkový čas otázky však na ich GPU serveri vzrástol z 13 na 21,6 sekundy. Pomocník teda spotrebuje vlastný čas, hoci znižuje množstvo kontextu opakovane spracúvaného veľkým modelom.
Pre vývojový tím je rozhodujúce, či platí viac za tokeny, alebo za čakanie a infraštruktúru. Pilot má používať skutočné otázky z vlastného repozitára a posudzovať správnosť nájdených miest, nie iba nižší účet. Zaujímavé sú najmä úlohy prechádzajúce viacerými priečinkami. Pri presnom známom symbole môže jednoduché textové hľadanie zostať rýchlejšou cestou.
Užitočné je oddeliť dve hodnotenia: či pomocník našiel správny súbor a či následný agent vytvoril správnu úpravu. Vyhľadávač môže zúžiť kontext výborne, ale hlavný model môže stále nesprávne pochopiť logiku programu. Naopak, dlhšia odpoveď vyhľadávača nemusí byť lepšia, ak len pridáva nesúvisiace súbory. Preto má tím pri pilote zaznamenať relevantné lokácie, počet otvorených súborov a konečný výsledok testov.
Technický kontext
Stav overenia: Spracované podľa zdroja; redakcia postup nereprodukovala.
Verzie: Zdroj neuvádza konkrétne verzie.
Podmienky použitia: Použitie závisí od konkrétnej konfigurácie a dokumentácie uvedenej v zdrojoch.
Obmedzenia: Redakcia nereprodukovala testy dodávateľov; staršie udalosti sú v texte datované.
Zdroje
Súvisiace
Ďalšie články k téme
LangChain vysvetlil retrieval pre Deep Agents: veľké výsledky majú ísť do súborov a čítanie na subagentov
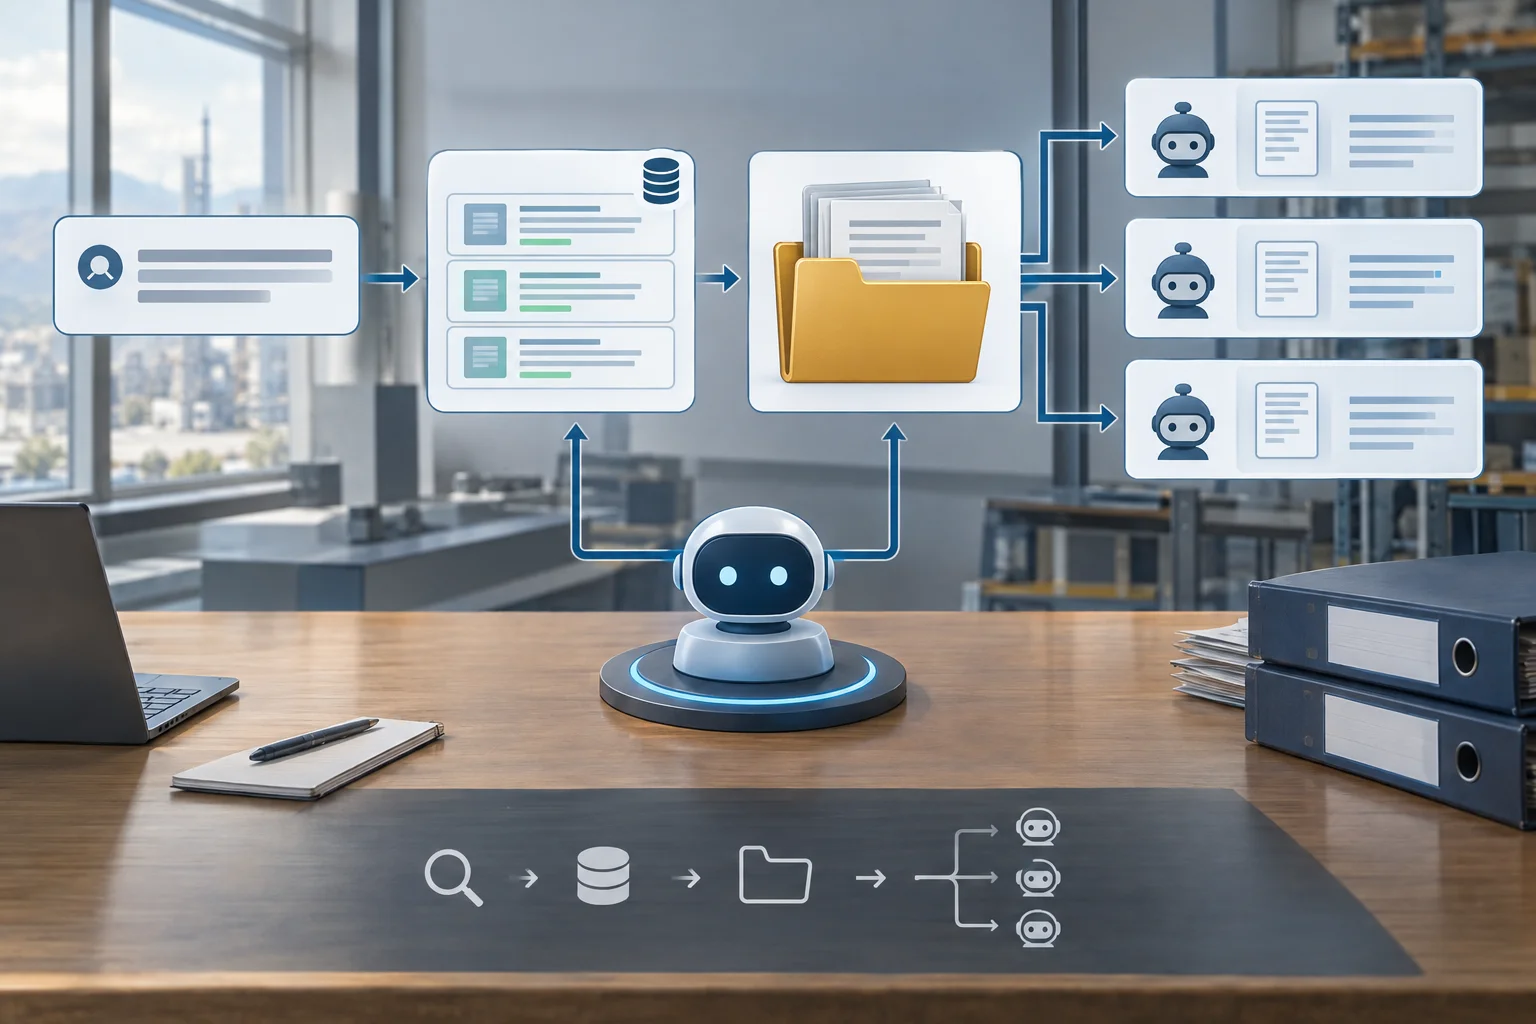
LangChain v blogu z 23. októbra 2026 rozobral, ako navrhovať retrieval pre dlhobežné AI agentov v Deep Agents. Jadrom odporúčania je nehádzať veľké výsledky priamo do kontextu hlavného agenta: najprv lacno nájsť kandidátov, potom veľké výstupy odložiť do súborov a ich čítanie delegovať na subagentov.
Claude Agent SDK: od odpovede modelu k cyklu práce a kontroly
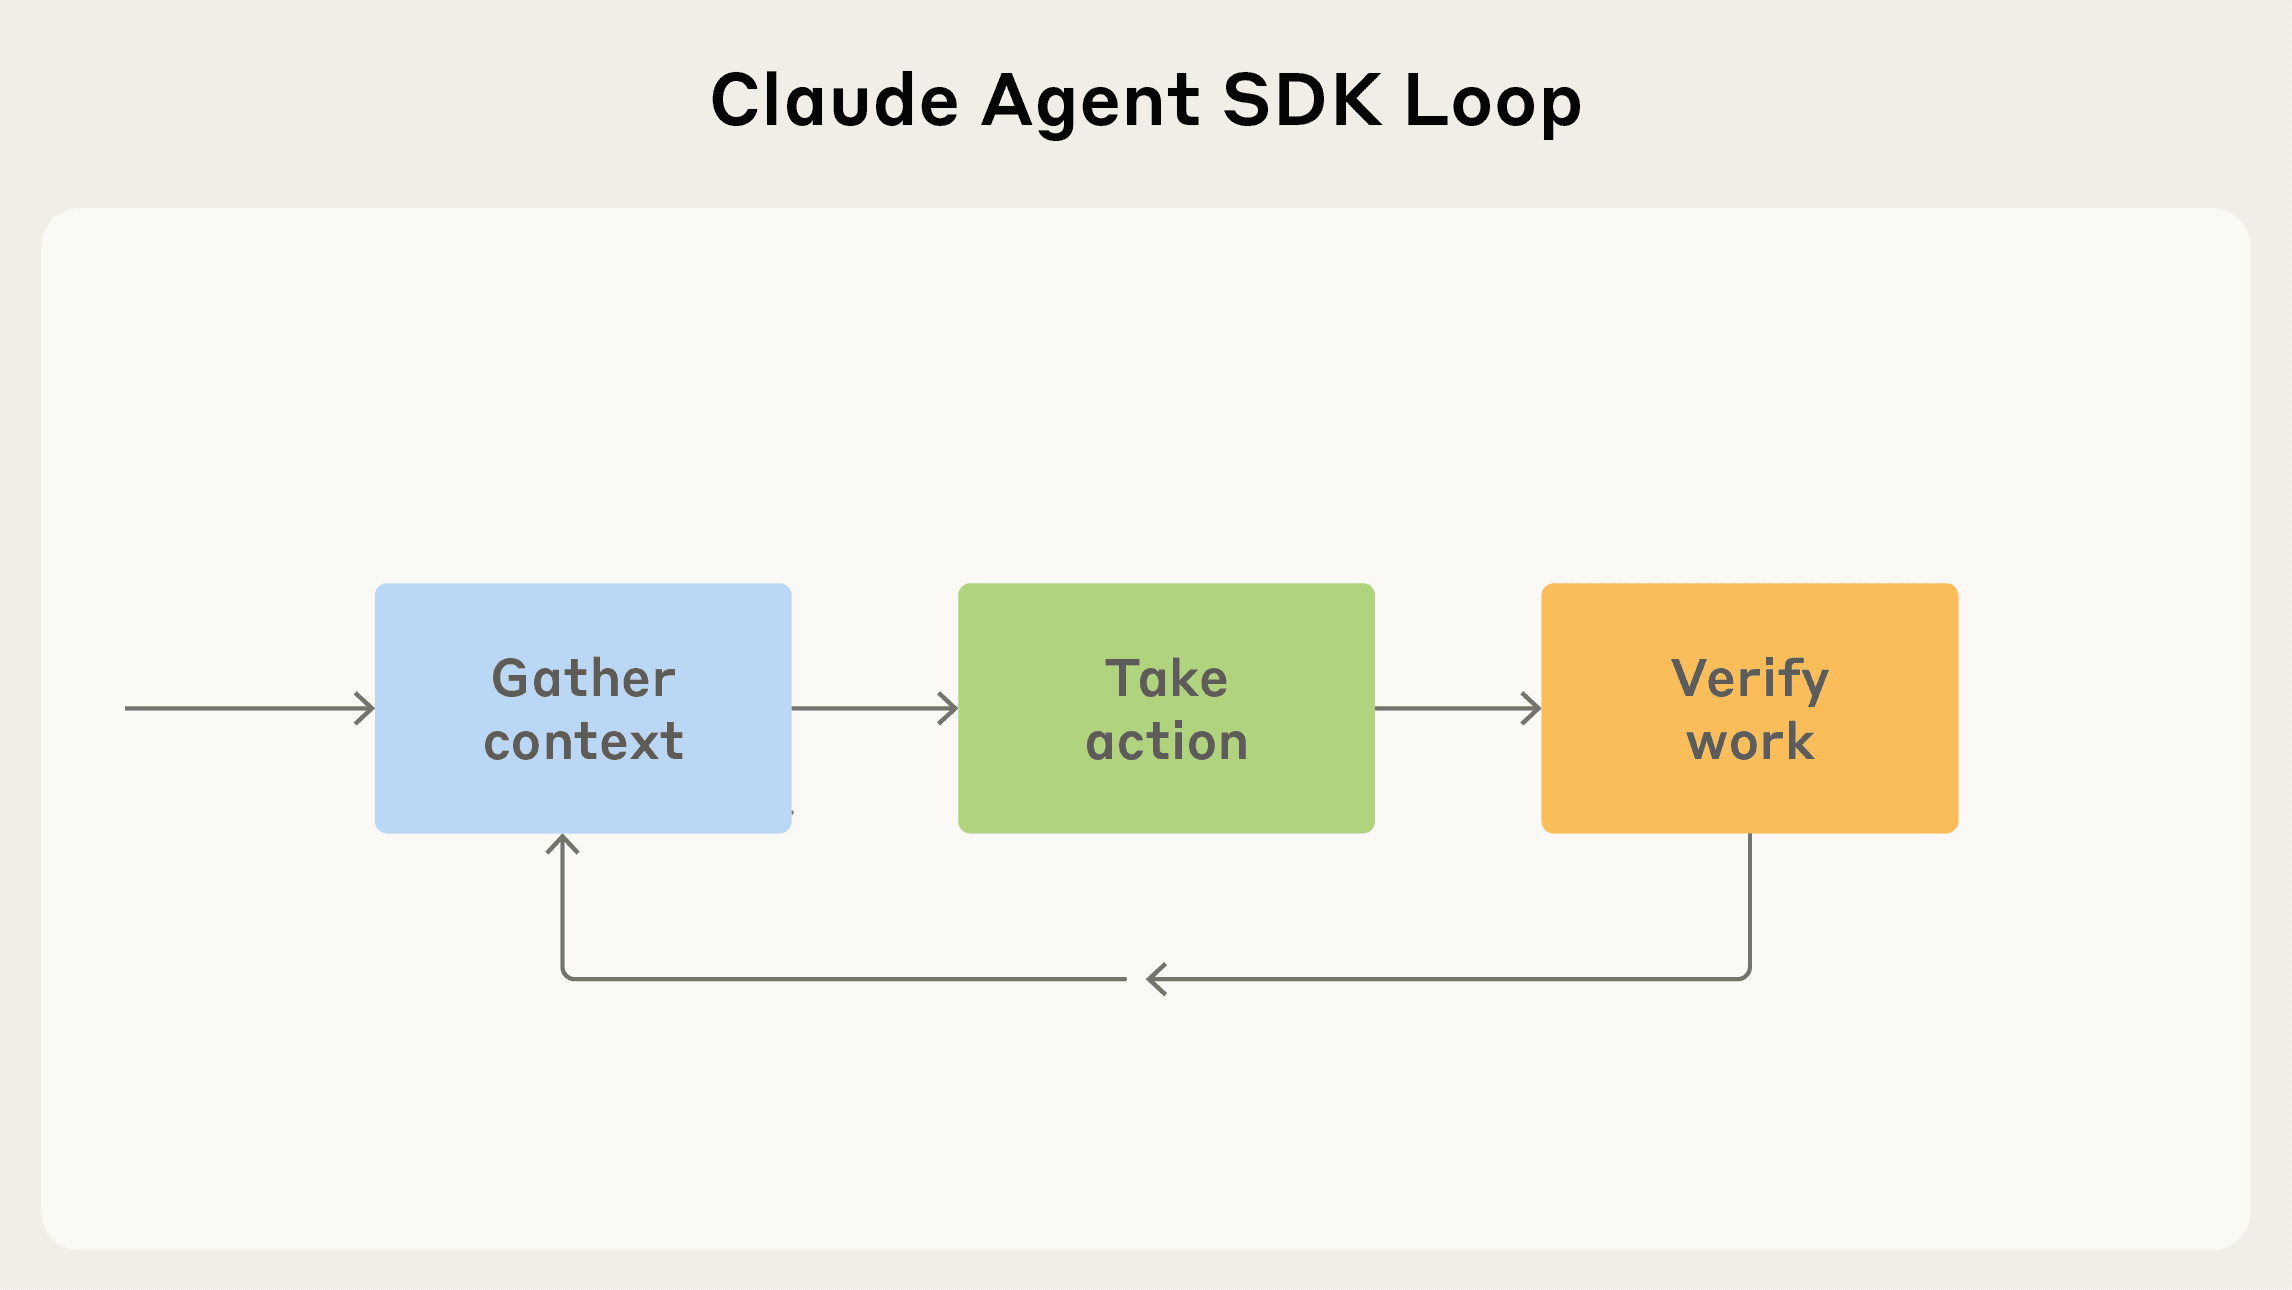
Agent SDK prenáša princípy Claude Code do ďalších aplikácií. Jeho význam spočíva v práci s kontextom, nástrojmi a overovaním, nie iba v dlhšom systémovom prompte.
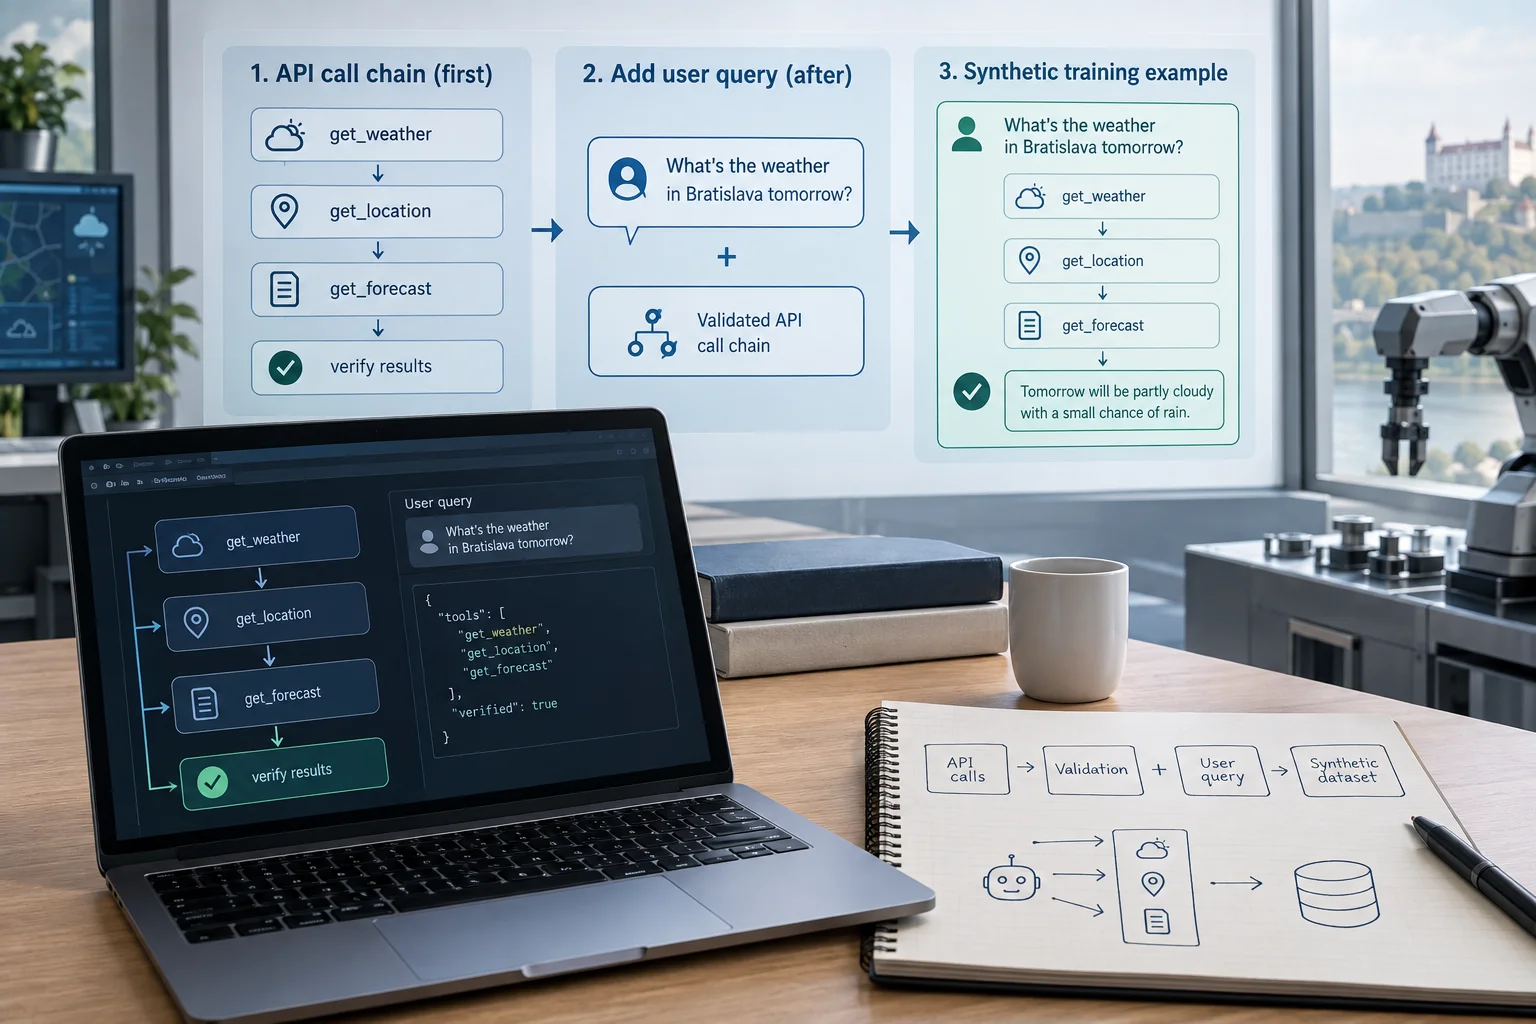
Google Research opísal ToolGrad: answer-first generovanie datasetov pre tool-use v práci predstavenej na ACL 2026
Google Research 10. septembra 2026 zverejnil popis frameworku ToolGrad, ktorý pri tvorbe syntetických datasetov pre používanie nástrojov obracia bežný postup: najprv vytvorí a overí reťazec API volaní, až potom k nemu doplní používateľský dopyt. Zdroj uvádza nižšie náklady a vyššiu úspešnosť generovania, no ide o vlastné výskumné tvrdenia bez nezávislého overenia v dodanom podklade.
ML Intern ukazuje, čo má agent odovzdať po tréningu: model aj poctivé porovnanie
Praktické príklady Hugging Face spájajú rozpočet, skúšobný beh a meranie zlepšenia. Samotné dokončenie tréningu nestačí.