LangChain vysvetlil retrieval pre Deep Agents: veľké výsledky majú ísť do súborov a čítanie na subagentov
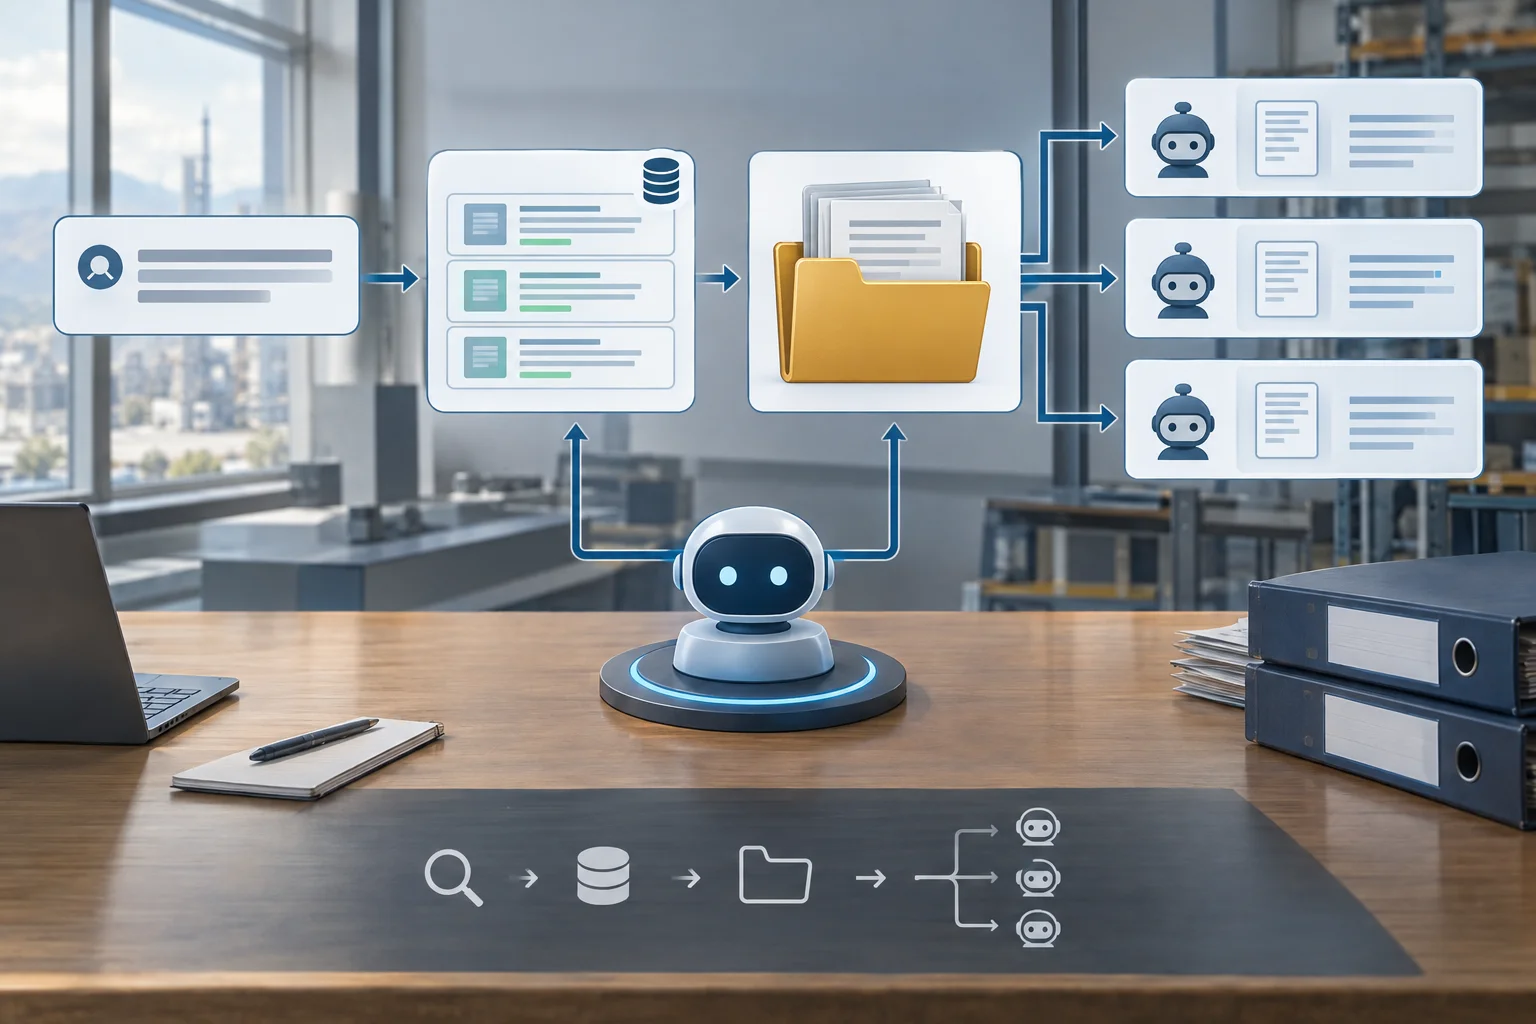
LangChain v blogu z 23. októbra 2026 rozobral, ako navrhovať retrieval pre dlhobežné AI agentov v Deep Agents. Jadrom odporúčania je nehádzať veľké výsledky priamo do kontextu hlavného agenta: najprv lacno nájsť kandidátov, potom veľké výstupy odložiť do súborov a ich čítanie delegovať na subagentov.
Hlavné poznatky
- LangChain opisuje retrieval pre dlhobežných agentov ako súčasť context engineeringu, nie ako jednorazové RAG načítanie.
- Odporúčaný vzor je začať lacným vyhľadávaním cez glob a grep, veľké výsledky ukladať do súborov a modelu vracať len cestu a náhľad.
- Čítanie a filtrovanie surových výsledkov majú robiť subagenti, aby sa hlavný agent nezahltil nerelevantným obsahom.
- Praktický význam je najmä pri agentoch nad veľkými archívmi, exportmi a internými znalosťami; nezávislé benchmarky prínosu však v podkladoch chýbajú.
Čo LangChain mení v prístupe k retrievalu
LangChain v texte „Context Engineering for AI Agents Starts with Retrieval“ z 23. októbra 2026 neposúva Deep Agents ako nový benchmark, ale ako konkrétny návrhový vzor pre dlhobežných agentov. Hlavná téza je jednoduchá: agent s obmedzeným kontextovým oknom zlyháva najmä tromi spôsobmi — hľadá neefektívne, naraz načíta priveľa textu alebo pracuje s irelevantným či zastaraným obsahom. Praktická zmena je v tom, že retrieval už nie je len „nájdi dokumenty“, ale samostatná disciplína context engineeringu: najprv vyhľadať čo najlacnejšie, potom neprenášať veľké payloady priamo modelu a hlučné čítanie izolovať mimo hlavného kontextu.
Deep Agents podľa oficiálnej stránky slúži ako open-source agent harness pre dlhšie úlohy, s plánovaním, správou kontextu a orchestráciou viacerých agentov. Nový blog tak zapadá do už skôr opísanej architektúry, kde sa kontext neriadi iba promptom, ale aj middleware vrstvou, offloadingom a subagentmi.
Mechanizmus: najprv lacné hľadanie, potom odloženie veľkých výsledkov
Primárny dokument odporúča začínať najlacnejším vhodným nástrojom. Vo filesysteme má agent najprv použiť glob na názvy súborov a grep na hľadanie riadkov či kľúčových slov; až keď presné slová nestačia, má prísť sémantické vyhľadávanie nad retrieval nástrojom, napríklad s vektorovým úložiskom. Dôležitý rozdiel oproti bežnému dvojkrokovému RAG je v tom, že výskumný agent nemá hľadať iba raz na začiatku, ale priebežne sa rozhodovať, kedy a čo ešte potrebuje dohľadať.
Druhá časť mechanizmu rieši objem dát. Deep Agents podľa blogu číta súbory po stranách: read_file štandardne po 100 riadkoch a s parametrami offset a limit. Keď výsledok nástroja prerastie približne 20 000 tokenov, harness ho uloží do /large_tool_results/ a model dostane len cestu a krátky náhľad. LangChain rovnaký vzor odporúča aj pre vlastné retrieval nástroje: vyhľadané texty uložiť do súborov a hlavnému agentovi vrátiť iba ich cesty.
Prečo do toho vstupujú subagenti
Samotné odkladanie veľkých výsledkov ešte nerieši kvalitu. Aj krátky zoznam ciest môže viesť k tomu, že hlavný agent začne otvárať nerelevantné alebo staré texty a zanesie si nimi kontext. Preto blog navrhuje vzor „retrieve, offload, delegate“: hlavný agent spustí vyhľadanie, výsledky sa odložia do súborov a jednotlivé súbory čítajú subagenti. Tí vrátia len kľúčové fakty a zdroj, pričom hlučná časť práce zostane v ich oddelených kontextových oknách.
Pre tím, ktorý stavia firemného výskumného alebo dokumentačného agenta, je to podstatné najmä pri archívoch, exportoch a interných znalostných bázach. Mechanizmus nemá doložený nezávislý benchmark, ale opisuje konkrétne integračné miesto: retrieval nástroj nemá byť len ďalší „tool call“, ale filter, ktorý znižuje, čo všetko sa dostane k hlavnému modelu.
Hranice tvrdení a čo z toho vyplýva
Dôležité je, že všetky podklady pochádzajú od LangChainu. Máme preto dobrý opis zamýšľaného mechanizmu, nie nezávisle overený dôkaz o zlepšení presnosti, ceny alebo latencie. Starší článok o „How Deep Agents Remember“ však potvrdzuje, že retrieval blog nie je izolovaná rada: sedí do širšej schémy Deep Agents, kde sa veľké výsledky offloadujú, starší kontext sumarizuje, špecializované inštrukcie sa načítajú až na požiadanie a subagenti oddeľujú hlučné medzikroky.
Pre vývojára je teda najdôležitejší prenositeľný princíp: ak agent pracuje nad veľkým korpusom, nemal by dostať všetko naraz ani priamo. Má najprv lacno zúžiť priestor hľadania, veľké výsledky odložiť mimo hlavného promptu a samotné čítanie delegovať tam, kde nepoškodí kontext hlavného rozhodovania.
Technický kontext
Stav overenia: Spracované podľa zdroja; redakcia postup nereprodukovala.
Verzie: Zdroj neuvádza konkrétne verzie.
Dátum pôvodného zdroja: 23. októbra 2026
Podmienky použitia: Znalosť agentových workflowov, filesystem nástrojov, RAG a práce s kontextovým oknom modelu.
Obmedzenia: Podklady neobsahujú nezávislé testy, presnú verziu deepagents pre všetky popísané schopnosti ani explicitnú licenciu. Praktické prínosy preto nemožno kvantifikovať nad rámec tvrdení zdroja.
Zdroje
Súvisiace
Ďalšie články k téme
LangChain opisuje, ako Deep Agents rieši dlhé behy agentov mimo kontextového okna
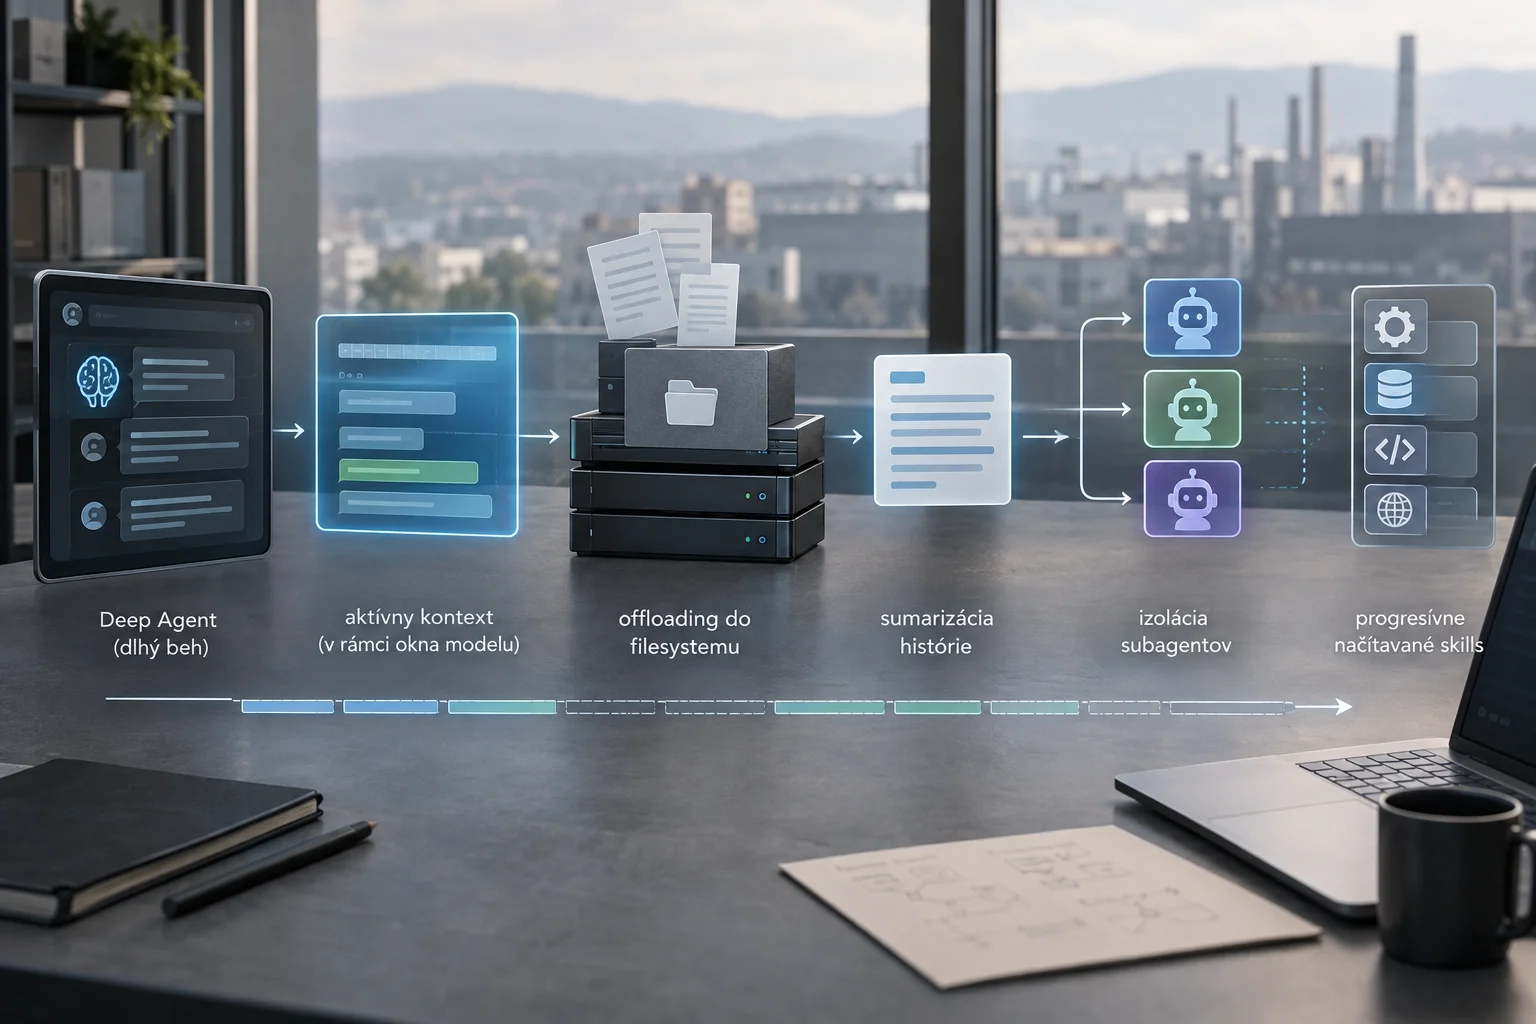
LangChain v októbri 2026 zhrnul, ako jeho Deep Agents presúva časť pracovnej pamäte mimo aktívneho kontextu modelu. Z dostupných podkladov vyplýva kombinácia offloadingu do filesystemu, sumarizácie histórie, izolácie subagentov a progresívne načítavaných skills; chýbajú však nezávislé benchmarky aj presné verzie.
LangChain v októbri 2026 rozšíril LangSmith o AI Search, Trajectories a Engine v2 pre prevádzku agentov
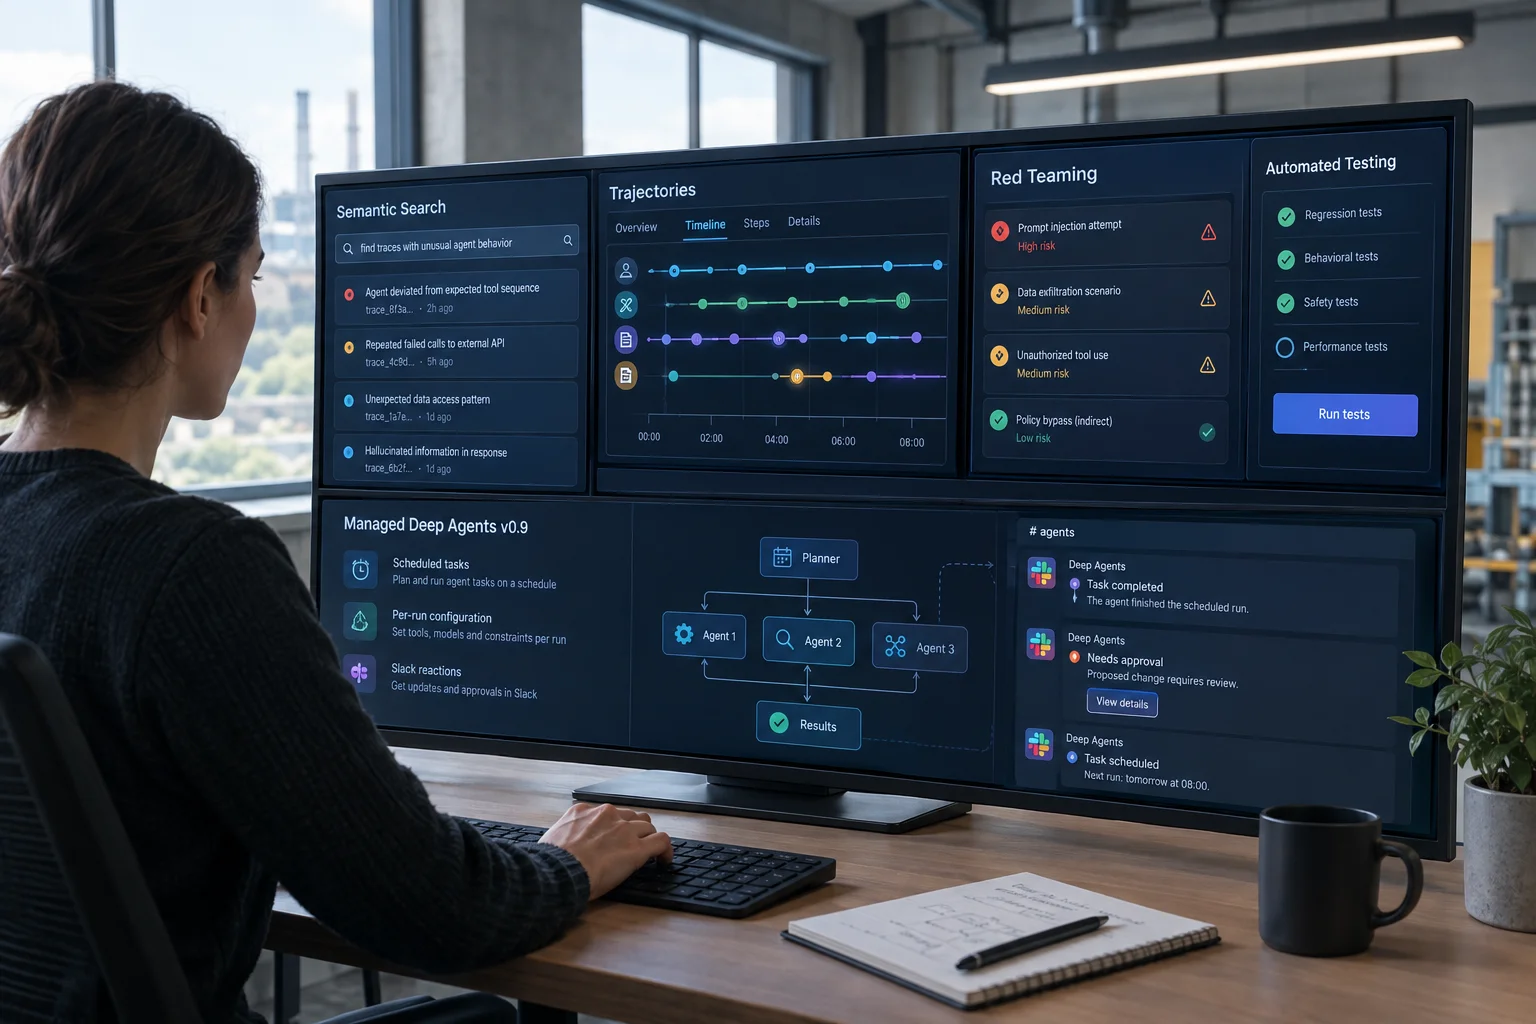
LangChain v októbri 2026 opísal sériu noviniek pre prevádzku agentov: semantické hľadanie problémového správania v traceoch, čitateľnejší chronologický pohľad na relácie, proaktívny red teaming a automatické testovanie navrhovaných opráv. Zároveň predstavil Managed Deep Agents v0.9 s plánovanými úlohami, per-run konfiguráciou a reakciami v Slacku.
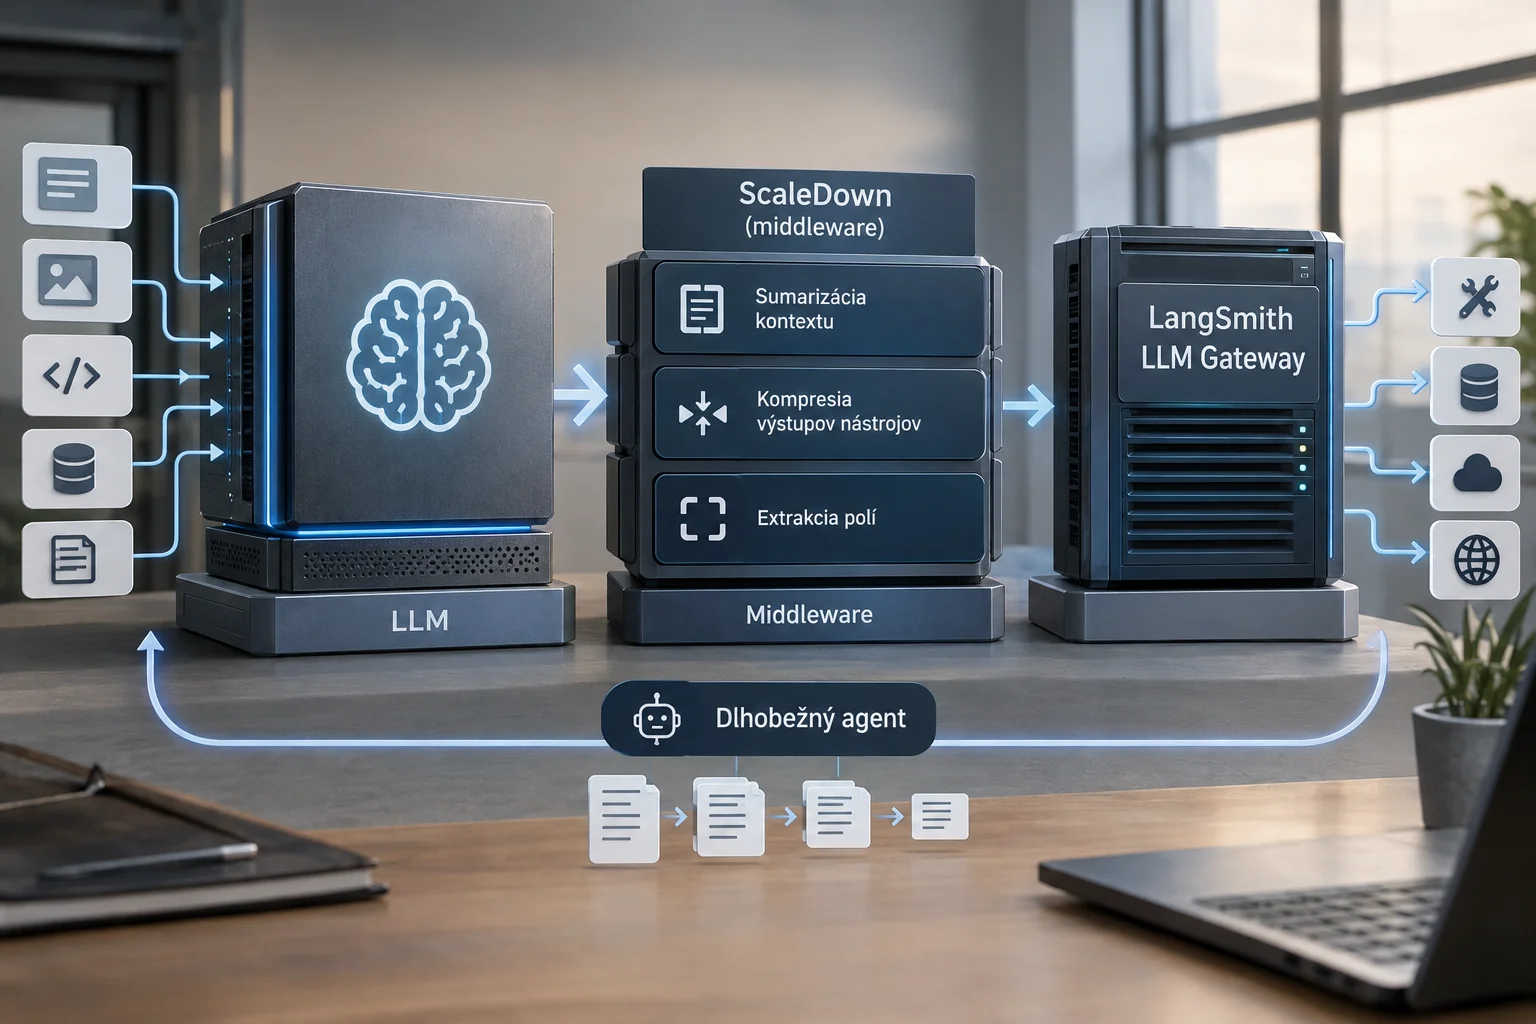
LangChain pridal ScaleDown do dlhobežných agentov a Gateway: kontext sa presúva z veľkého LLM do middleware
LangChain 13. októbra 2026 opísal integráciu langchain-scaledown a podporu ScaleDown v LangSmith LLM Gateway. Zmena je dôležitá tým, že opakované úlohy správy kontextu v dlhobežných agentoch presúva z veľkého generatívneho modelu do špecializovaných middleware pre sumarizáciu, kompresiu výstupov nástrojov a extrakciu polí.
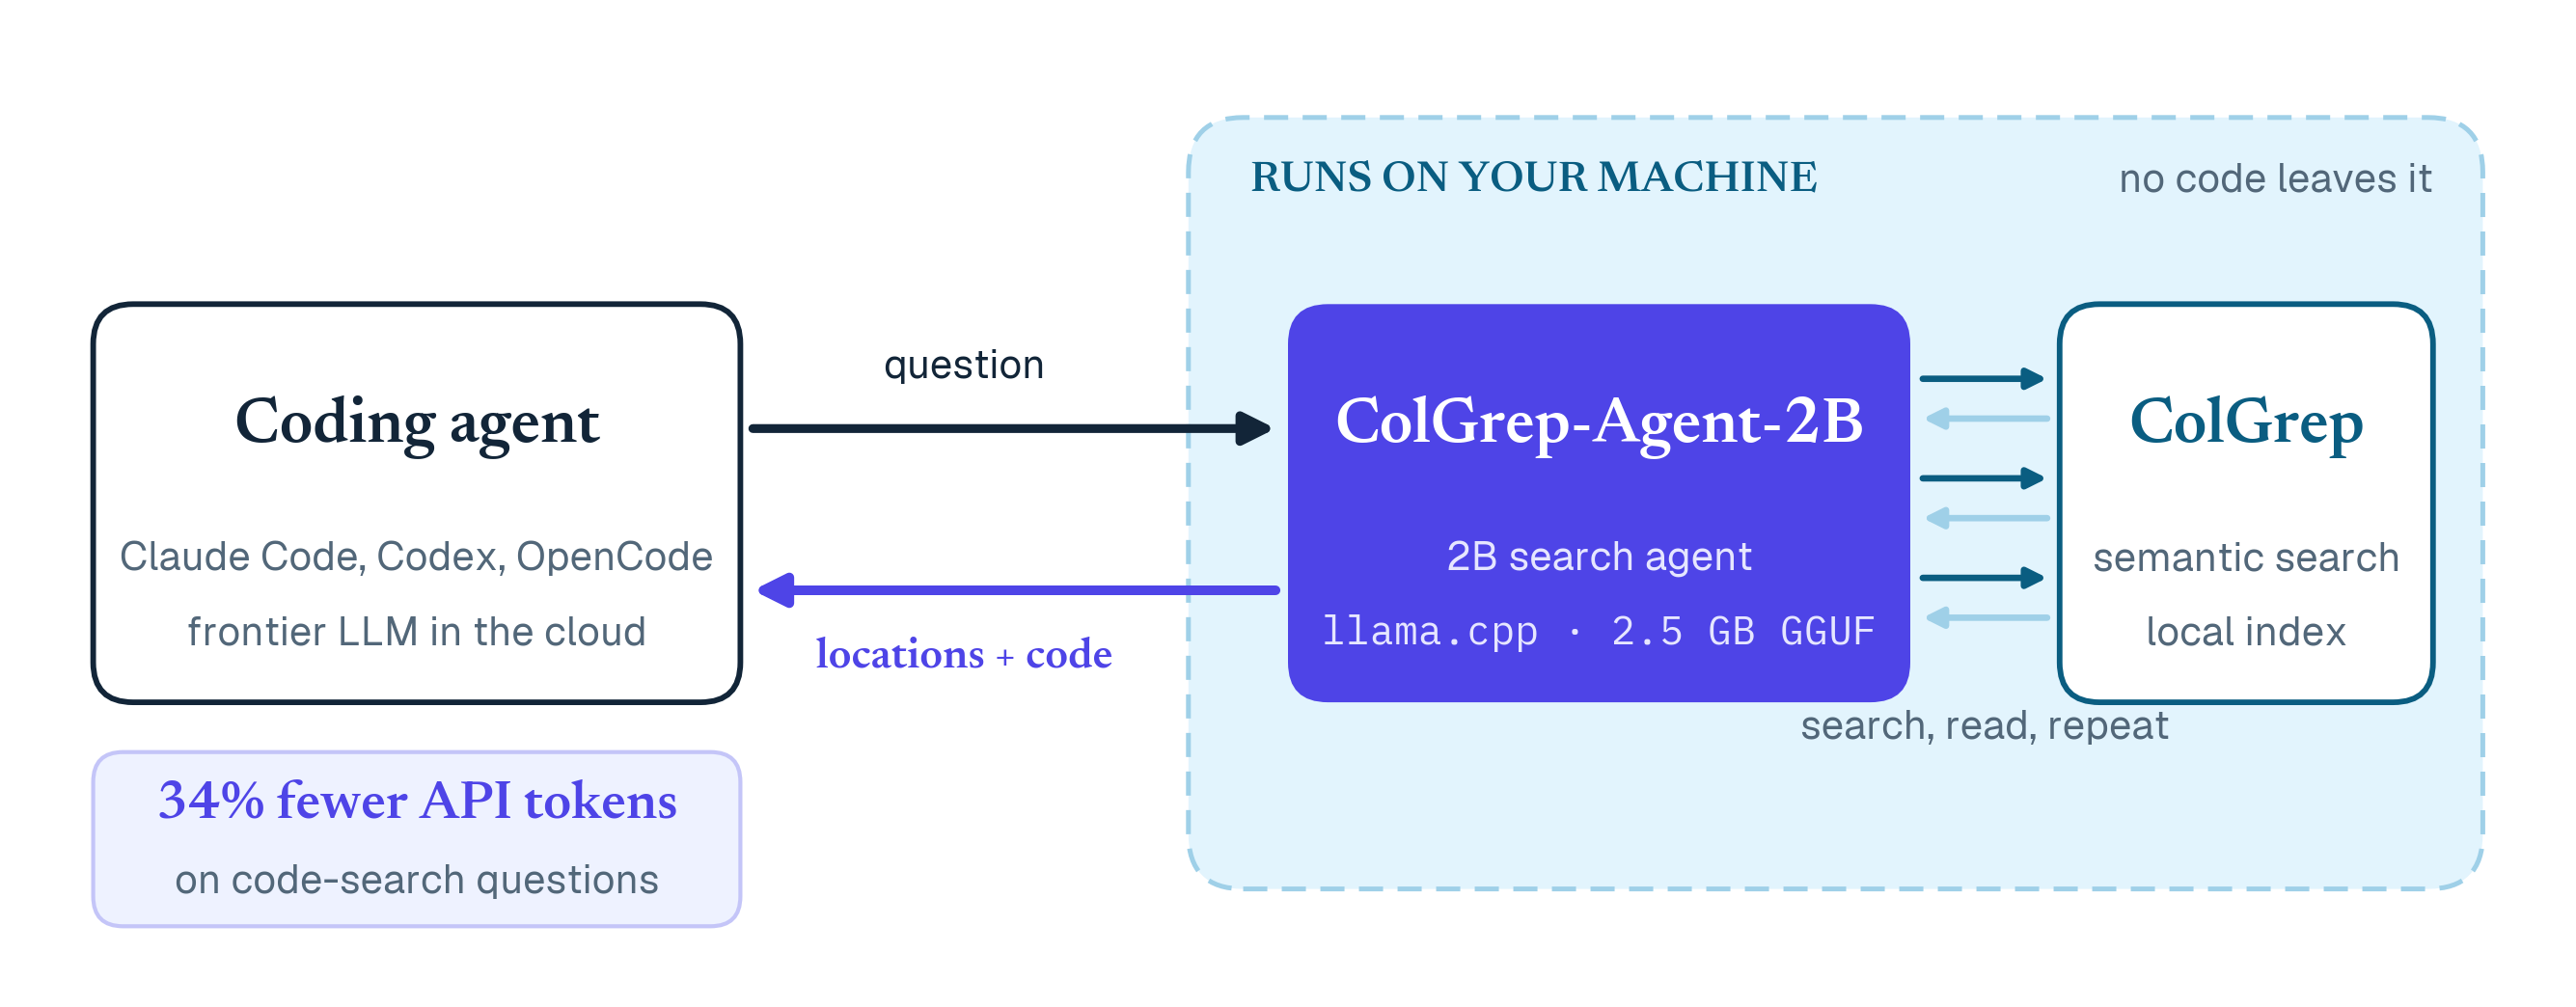
Malý ColGrep-Agent hľadá kód za veľký model. Úspora tokenov má časovú cenu
LightOn ukazuje dvojmiliardový model na orientáciu v repozitári. Výsledky oddeľujú nájdenie súborov od samotnej opravy programu.