Google Research opisuje stavebné bloky pre autonómne wet laby: digitálne dvojča, uzavreté cykly a bindery pre FAP
Google Research na svojom blogu predstavilo prístup, v ktorom AI agenti neostávajú len pri návrhu molekúl v softvéri, ale sú napojení na laboratórnu robotiku cez framework VERID. Firma zároveň tvrdí, že v uzavretých cykloch zlepšila hit rate aptamérov pre myoglobín a α-thrombín a pri cieli FAP našla bindery so single-digit nanomolar afinitou. V dodaných podkladoch však ide o firemné tvrdenia a opis interného výskumného postupu, nie o nezávislé externé overenie.
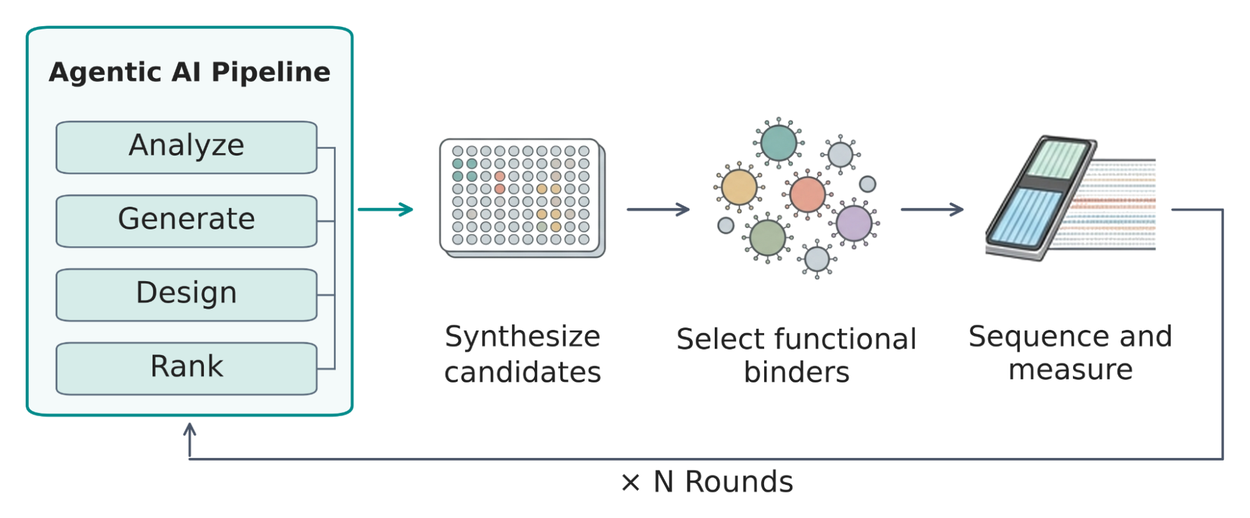
Google Research tvrdí, že posúva AI agentov z čisto výpočtového prostredia bližšie k reálnemu laboratórnemu stolu. Na blogu opisuje, ako agentov prepája s laboratórnou robotikou, aby mohli navrhovať, simulovať a následne vykonávať experimenty v uzavretých cykloch. Jadrom tohto prístupu je framework VERID, ktorý firma opisuje ako sémantické digitálne dvojča laboratória so živým sledovaním stavu, rýchlymi simuláciami pred vykonaním, bezpečnostnými kontrolami a synchronizovanými logmi behov.
Praktický význam takéhoto systému je v tom, že agent nemá pracovať iba s abstraktným kódom, ale aj s fyzickými obmedzeniami laboratória. Google priamo uvádza príklady chýb, ktoré môžu byť syntakticky správne, no fyzicky nemožné alebo logisticky nesprávne, napríklad pokus nasať vzorku z prázdnej jamky. Práve preto VERID podľa firmy najprv simuluje protokol a blokuje neplatné príkazy skôr, než sa dostanú k robotu.
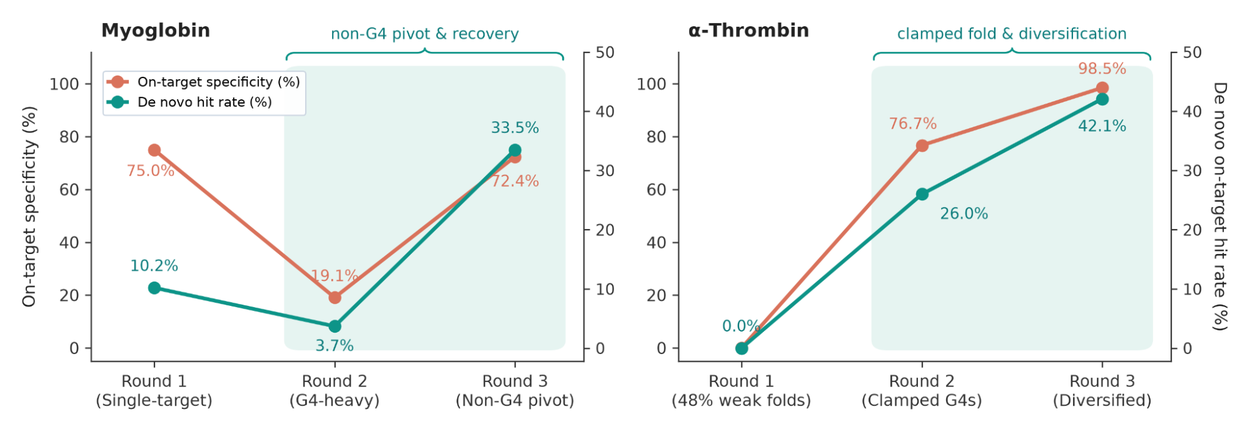
Google k tomu pridáva aj dva výskumné príklady uzavretého učenia z experimentov. Pri aptaméroch firma tvrdí, že počas troch kôl zvýšila potvrdený on-target hit rate na 33,5 % pre myoglobín a 42,1 % pre α-thrombín. Pri návrhu proteínových binderov zas uvádza, že pre cieľ FAP dosiahla po niekoľkých experimentoch bindery so single-digit nanomolar afinitou. To znie ambiciózne, ale hranica článku je dôležitá: v dodaných podkladoch ide o tvrdenia z firemného výskumného blogu, nie o nezávisle potvrdené porovnanie.
Zároveň nejde o obraz úplnej autonómie bez dozoru. Google opisuje safeguardy vrátane výberu neinfekčných testovacích systémov, biosecurity screeningu každej navrhnutej sekvencie, simulácie pred vykonaním a priameho ľudského schvaľovania sekvencií aj laboratórnych protokolov. Najsilnejšie doložené jadro novinky preto nie je prísľub automatického objavovania liekov, ale konkrétny návrh infraštruktúry, ktorou chce firma spojiť AI agentov s fyzickou realitou wet-labu.
Podrobnosti a podklady
Čo Google Research tvrdí, že buduje
Primárny zdroj predstavuje jednu spoločnú líniu výskumu: „We are bringing AI agents to the wet-lab bench at Google Research to navigate complex biological landscapes. By grounding agents in physical lab robotics, we can run fast closed-loop molecular design cycles where agents learn how to learn, ultimately discovering single-digit nanomolar protein binders for cancer targets.“ To je základný rámec článku: nejde o samostatný produktový launch, ale o výskumný opis toho, ako chce Google prepojiť návrh, test a spätnú väzbu v laboratóriu.
Ako má fungovať VERID
Technickým jadrom je VERID. Google ho opisuje ako „semantic digital twin of the laboratory workcell“, teda živý stavový model, ktorý sleduje geometriu robotických ramien, objemy v jamkách, identity reagencií aj zásobu špičiek pipiet. Zdroj zároveň vymenúva štyri hlavné schopnosti: live 3D state tracking, fast virtual dry runs, hardware safety checks a synchronized video and action logs. Význam tohto návrhu je v tom, že agent nemá rozhodovať iba podľa textového zadania alebo API, ale podľa priebežne aktualizovaného modelu fyzického pracoviska.
Prečo nestačí, aby agent generoval len „správny“ kód
Zdroj výslovne vysvetľuje, prečo takáto vrstva kontroly vôbec treba. „An agent can generate syntactically valid code that is physically impossible ... logistically invalid ... or scientifically compromised by unmodeled fluidic effects.“ Blog uvádza aj konkrétne interné príklady použitia: simulátor zachytil aspiráciu 8-kanálovou pipetou do príliš úzkeho žľabu a agent musel plán upraviť; v inom prípade synchronizované video a execution traces pomohli odhaliť nerovnomernú stratifikáciu farbiva. To podporuje interpretáciu, že Google sa nesústredí len na samotné navrhovanie molekúl, ale aj na validáciu vykonateľnosti experimentu.
Aptaméry: čo blog reportuje v troch kolách
Prvý uzavretý cyklus sa týka aptamérov. Google píše, že ide o vhodné experimentálne pieskovisko, lebo celý design-test-analyze cyklus trvá približne 7 až 10 dní a výsledok sa dá priamo čítať sekvenovaním. Kľúčové reportované čísla sú tieto: „Across three rounds on two protein targets with varying difficulty levels (myoglobin and α-thrombin), AI-driven rational and de novo design raised confirmed on-target hit rates ... to 33.5% and 42.1% for myoglobin and α-thrombin, respectively“. Zdroj zároveň dopĺňa, že oba ciele vyžadovali odhaliť odlišný wet-lab failure mode, takže nejde len o čisté zlepšenie modelu bez experimentálnych komplikácií.
Ako sa mali agenti opraviť po chybách v laboratóriu
Text podrobnejšie rozpisuje aj mechanizmus, ktorým sa agenti mali opraviť po zlyhaniach. Pri α-thrombíne malo prvé kolo skončiť s 0 % binderov, pretože pevné primerové presahy narúšali skladanie sekvencií; následne agenti zaviedli upravené flankujúce štruktúry a hit rate stúpol. Pri myoglobíne sa zas po preferovaní surovej afinity rozšírili G-kvadruplexové motívy, ktoré sa podľa wet-lab dát ukázali ako nešpecifické „sticky“ bindery. Až následná revízia pravidiel mala obnoviť špecificitu aj hit rate. Tieto detaily sú dôležité preto, lebo zdroj nepredáva iba finálne čísla, ale argumentuje, že agenti sa učili z experimentálnych artefaktov.
Proteinové bindery pre FAP a výpočtové zrýchlenie
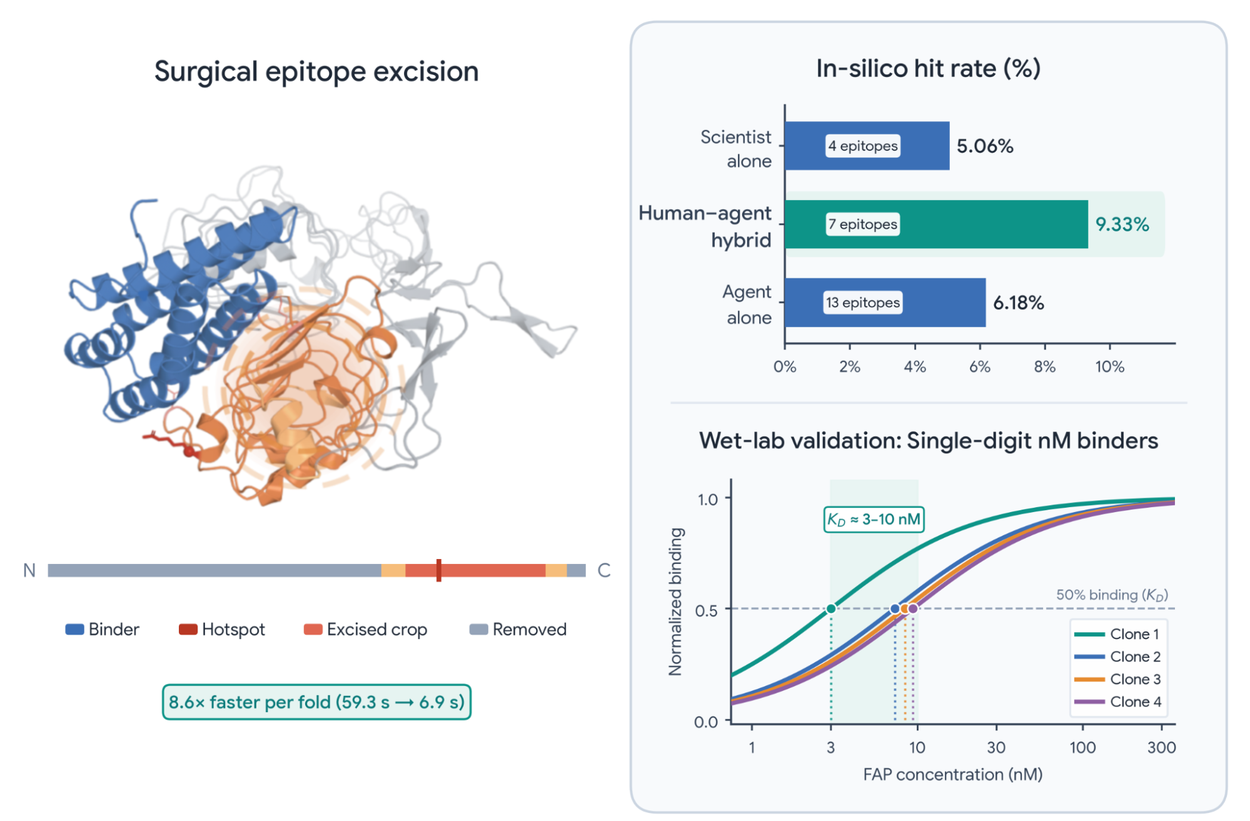
Druhý príklad sa týka de novo návrhu proteínových binderov pre fibroblast activation protein alpha (FAP), receptor nadmerne exprimovaný v solídnych nádoroch. Google tvrdí: „In just a few experimental runs, the top designs yielded binders with single-digit nanomolar affinity“. Zdroj zároveň opisuje, že výpočtovo zrýchlil jeden z drahých krokov pomocou „surgical epitope excision“, teda vyrezania lokálneho väzbového miesta pri predikcii skladania. Blog uvádza, že tým akceleroval cyklus viac než osemnásobne bez straty štruktúrnej presnosti a že pri rovnakom výpočtovom rozpočte ľudsko-agentná spolupráca takmer zdvojnásobila in-silico hit rate oproti samostatnej práci vedca. V našom článku však zostáva jadrom najmä atribútované tvrdenie o single-digit nanomolar afinite pri FAP.
Safeguardy a ľudský dohľad podľa zdroja
Bezpečnostná vrstva je v blogu formulovaná explicitne, ale stále ide o opis vlastného postupu Googlu. Zdroj uvádza tri typy safeguardov: výber dobre kontrolovaných neinfekčných biologických systémov bez gain-of-function rizika, biosecurity screening každej navrhnutej sekvencie a pravidlo, že agenti neposielajú neoverený kód priamo robotom, pretože každý protokol sa najprv nasucho simuluje a validuje proti digitálnemu dvojčaťu. Samostatne blog dodáva aj „Human oversight“, teda že ľudia autorizujú navrhnuté sekvencie, kontrolujú wet-lab protokoly a dohliadajú na beh robotov.
Čo je doložené a čo nie
Hranica poznania je podstatná. V dodaných podkladoch máme jeden primárny firemný blog s konkrétnymi technickými opismi a číselnými tvrdeniami, no nie nezávislú replikáciu, externý audit ani samostatné potvrdenie výkonu z iného zdroja. Preto sú najsilnejšie formulácie tie, ktoré ostávajú verné textu zdroja: Google opisuje VERID ako digitálne dvojča laboratória, tvrdí zlepšenia v aptamérových cykloch a tvrdí single-digit nanomolar bindery pri FAP. Silnejšie závery o preukázanom prelome v objavovaní liekov by z týchto podkladov neboli doložené.
Zdroje
Súvisiace
Ďalšie články k téme
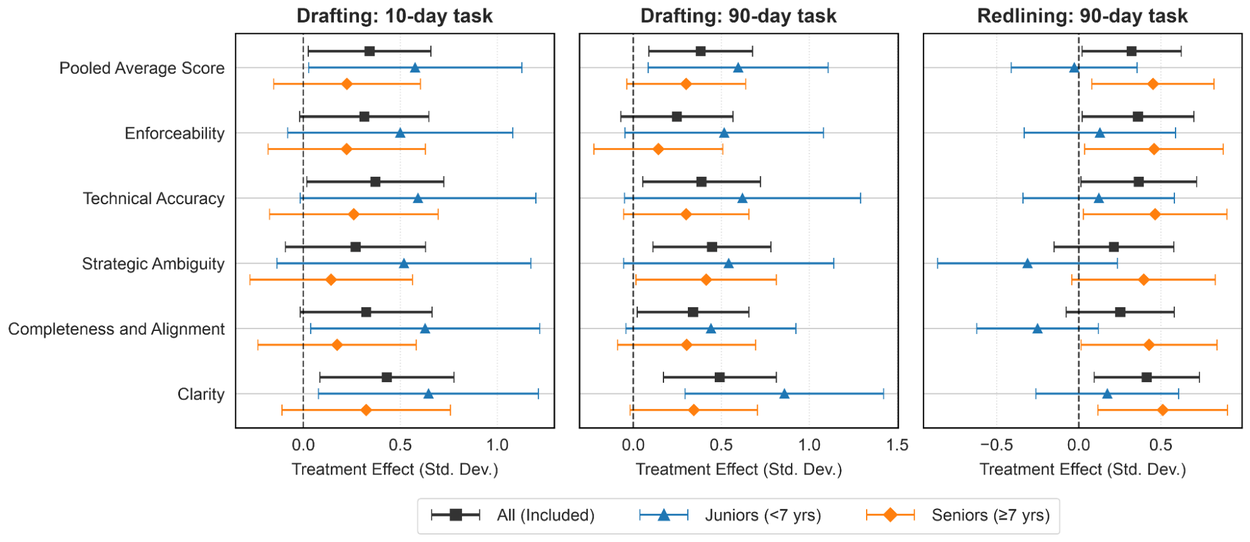
Štúdia Google pri patentových právnikoch: AI zlepšila výstup, no bez nej sa posun ukázal najmä u skúsenejších
Google Research opisuje trojmesačný randomizovaný experiment so 133 patentovými právnikmi v 11 kanceláriách, v ktorom prístup k AI zvýšil kvalitu písania patentov. Keď však výskumníci AI pri záverečnej úlohe odobrali, lepší neasistovaný výkon hlásia najmä u seniorných právnikov, zatiaľ čo juniori nevykázali priemerné zlepšenie; samotní autori zároveň upozorňujú na obmedzenú vzorku a krátke trvanie štúdie.
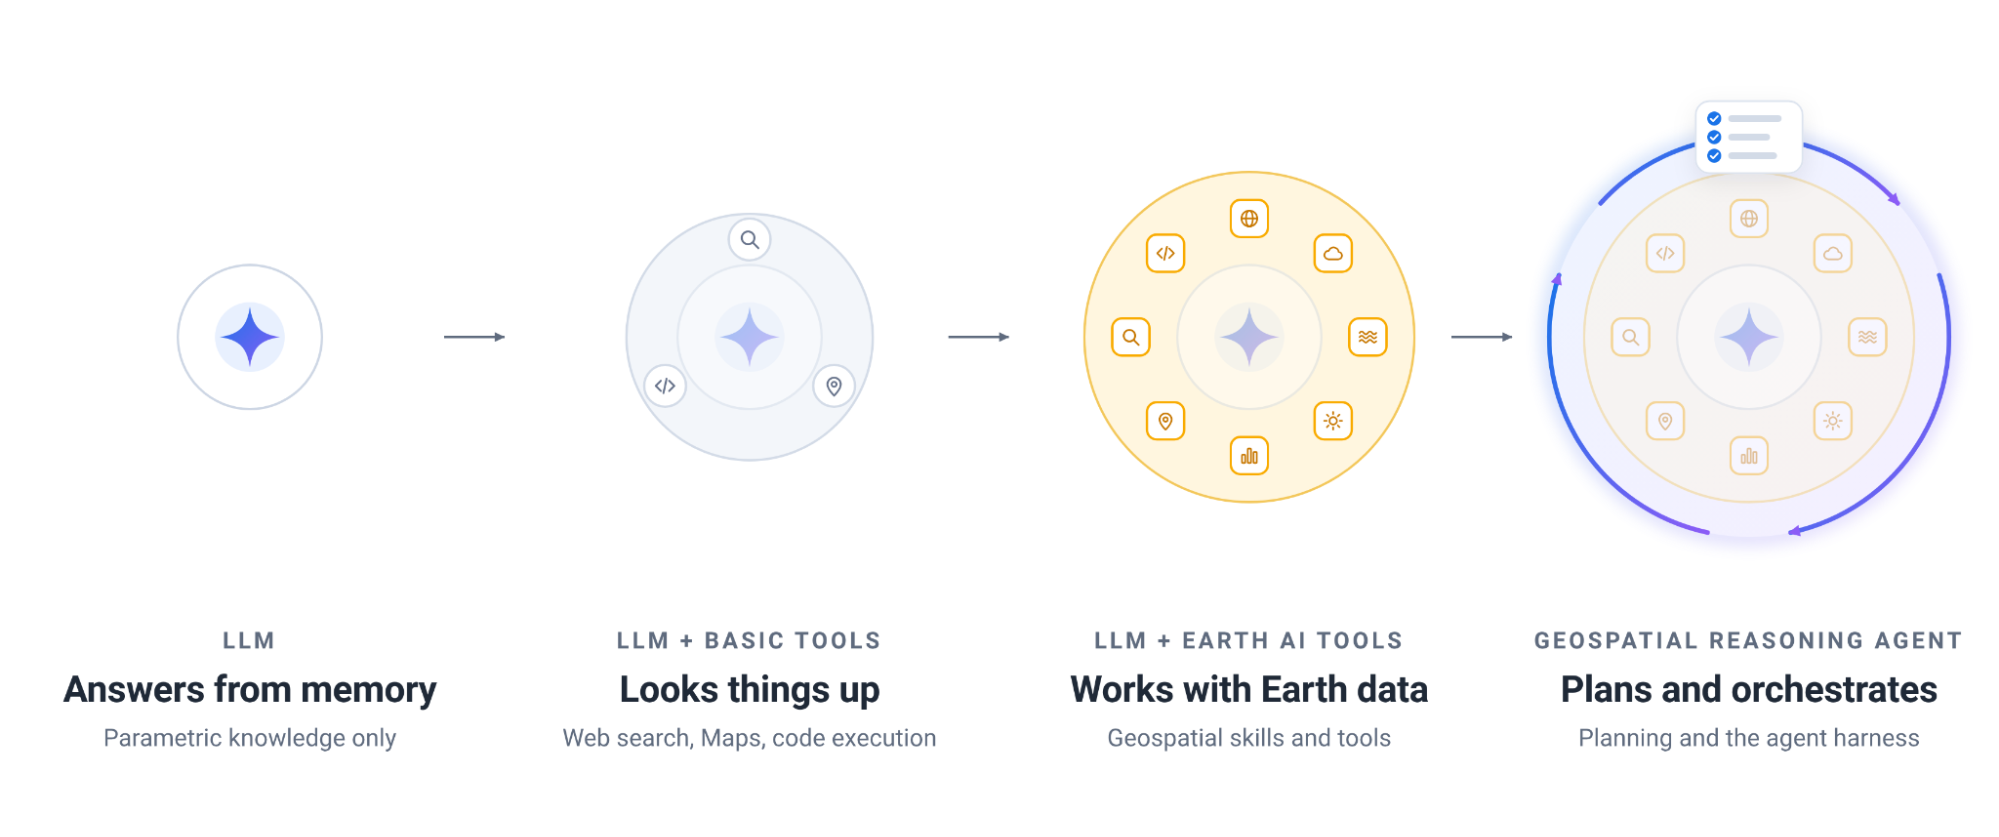
Google rozširuje experimentálny geopriestorový agent Earth AI a pridáva nové benchmarky
Google Research tvrdí, že jeho experimentálny Geospatial Reasoning agent získal technickú správu so štyrmi benchmarkmi vrátane dvoch nových sád GeoKTools a GeoExpertQueries, prešiel skorým testovaním s partnermi a rozširuje skorý prístup cez Ask Google Earth aj A2A API. Samotný Google zároveň upozorňuje, že aspoň časť výstupov treba chápať ako prvý návrh pre expertov, nie finálnu odpoveď.
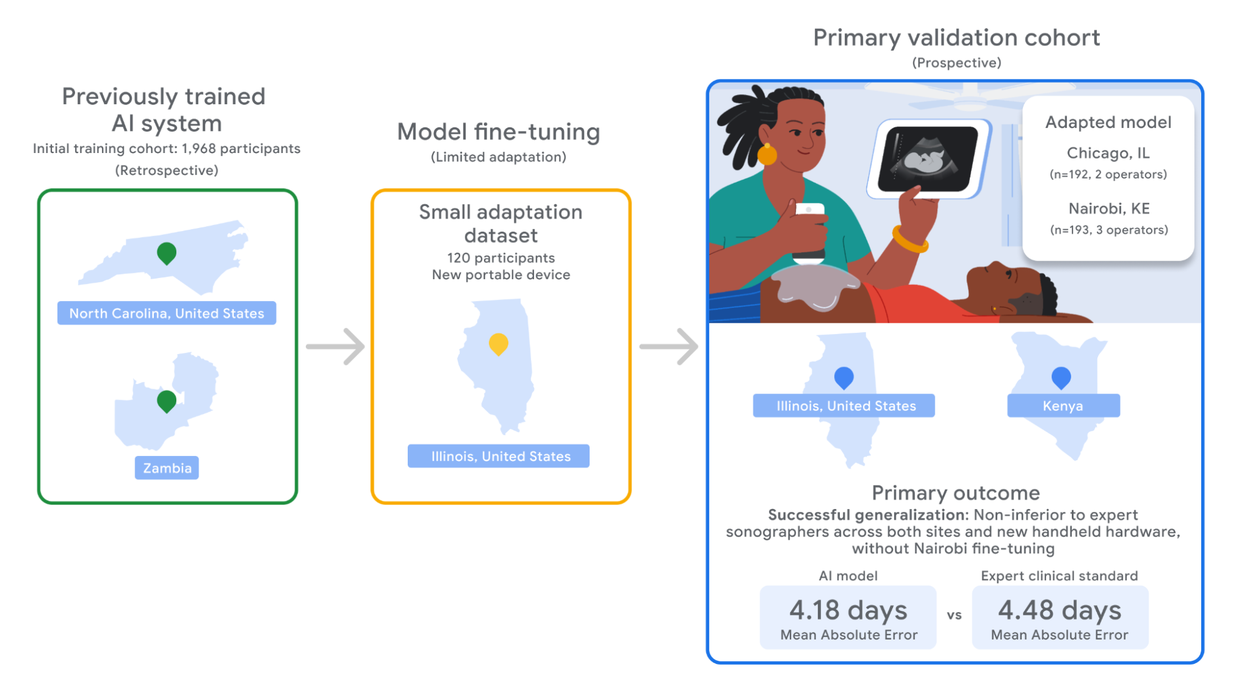
Google opísal AI ultrazvuk, ktorý podľa štúdie odhadol gestačný vek porovnateľne s expertmi
Google Research a Google for Health 21. októbra 2026 zverejnili opis prospektívnej multicentrickej štúdie AI systému pre „blind sweep“ ultrazvuk. Podľa autorov bol model pri odhade gestačného veku non-inferior voči expertnej sonografii a udržal podobnú chybu v Chicagu aj Nairobi, pričom v Nairobi neprešiel lokálnym dolaďovaním.
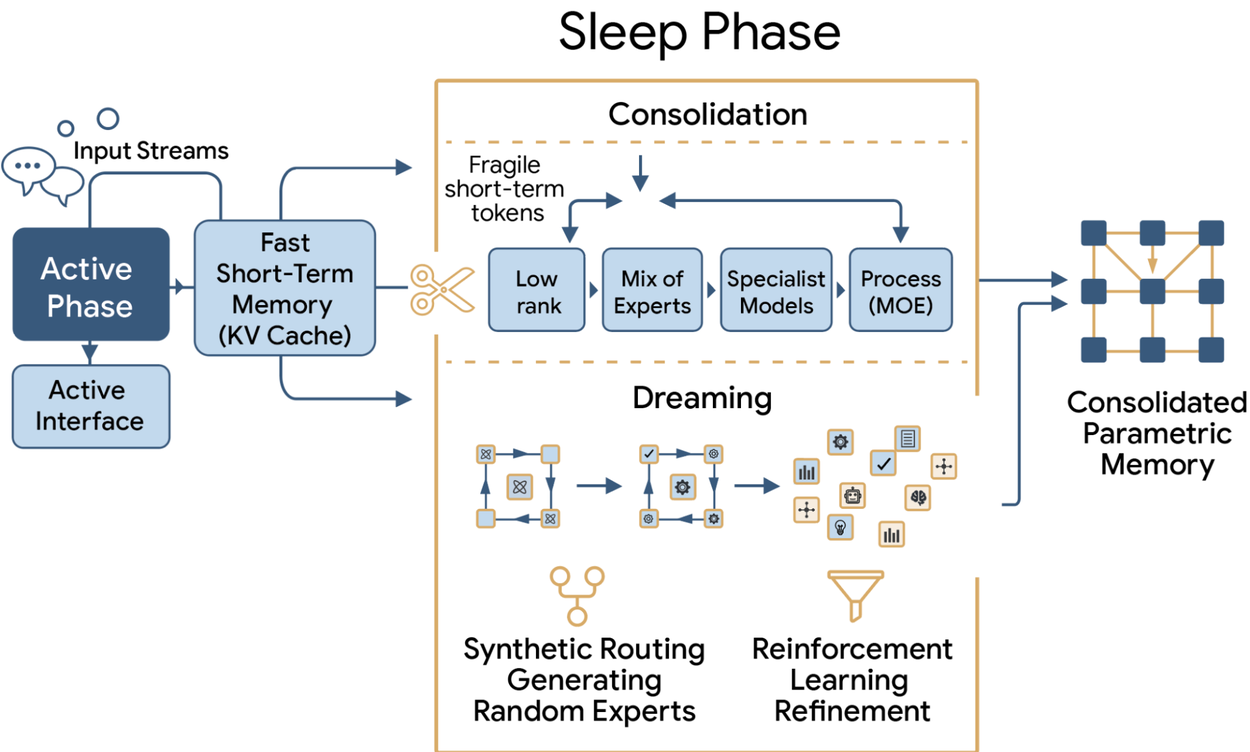
Google Research opisuje „sleep framework“ pre LLM: oddelená fáza spánku má ukladať nové poznatky bez prepísania starých
Google Research predstavilo rámec continual learningu, v ktorom sa model strieda medzi aktívnou fázou a „spánkom“. Počas spánku má konsolidovať krátkodobé stopy do parametrov cez rozšírenie kapacity, distiláciu znalostí a imitation learning; Google zároveň tvrdí zlepšenia pri dlhom kontexte, dopĺňaní faktov aj reasoningu, no v dodaných podkladoch ich nemožno nezávisle overiť.