Google Research opisuje „sleep framework“ pre LLM: oddelená fáza spánku má ukladať nové poznatky bez prepísania starých
Google Research predstavilo rámec continual learningu, v ktorom sa model strieda medzi aktívnou fázou a „spánkom“. Počas spánku má konsolidovať krátkodobé stopy do parametrov cez rozšírenie kapacity, distiláciu znalostí a imitation learning; Google zároveň tvrdí zlepšenia pri dlhom kontexte, dopĺňaní faktov aj reasoningu, no v dodaných podkladoch ich nemožno nezávisle overiť.
Veľké jazykové modely po nasadení zvyčajne ostávajú statické: vedia veľa z predtréningu, ale nové informácie si dlhodobo neukladajú. Google Research teraz opisuje „sleep framework“, teda režim continual learningu, v ktorom sa model strieda medzi aktívnou fázou práce a oddelenou fázou „spánku“. Cieľom je, aby model vedel priebežne prijímať nové fakty a pritom menej trpel problémom catastrophic forgetting, keď učenie nových vecí zhorší staršie schopnosti.
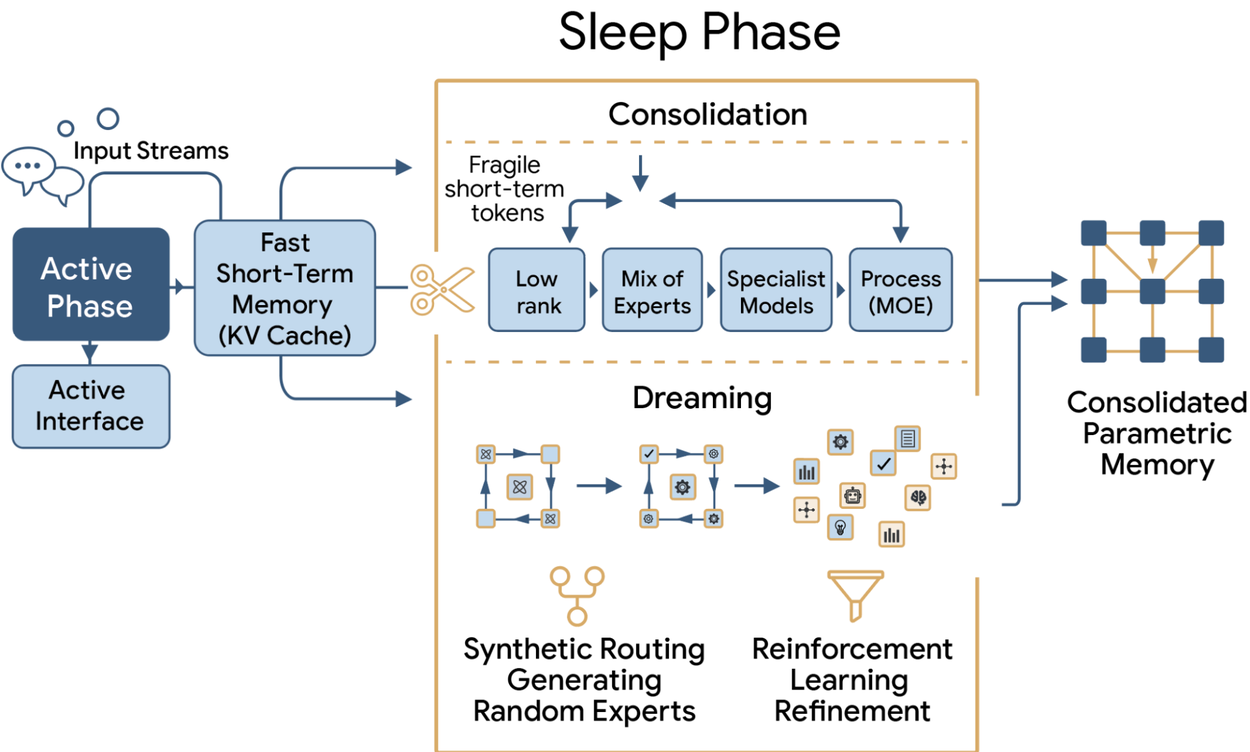
Podstatná zmena nie je len v tom, že sa model znovu trénuje, ale ako sa to deje. Počas aktívnej fázy zbiera dočasné krátkodobé stopy. Počas spánku ich má presúvať do stabilnejšej parametrickej pamäte: Google opisuje rozšírenie kapacity cez nové low-rank expert bloky v architektúre Mixture of Experts, prenos znalostí cez Generalized Knowledge Distillation a RL-based imitation learning a potom vyčistenie dočasných vysokofrekvenčných parametrov, aby sa uvoľnilo miesto na ďalší cyklus.
Druhá časť frameworku sa volá „dreaming“. V nej model generuje syntetické tréningové vzorky, pri generovaní náhodnejšie zapája expertov, vyberá užitočné vzorky gradientovým filtrom a na najlepších pokračuje v dolaďovaní. Google tým nepopisuje iba ukladanie nových faktov, ale aj mechanizmus, ktorý má zlepšovať samotné učenie a reasoning.
Praktický význam je jasný najmä pre systémy, ktoré majú fungovať dlhšie než jedno kontextové okno. Google tvrdí, že tento prístup pomohol pri priebežnom dopĺňaní faktov, pri práci s dlhým kontextom až do 10 miliónov tokenov aj pri matematickom reasoningu. To však treba čítať ako tvrdenia z jedného firemného blogového zdroja: v dodaných podkladoch nie je nezávislá replikácia ani externé overenie benchmarkov.
Podrobnosti a podklady
Čo sa mení oproti statickému LLM
Primárny zdroj explicitne predstavuje sleep framework ako nový režim continual learningu pre veľké jazykové modely. Východiskový problém je dvojitý: bežne nasadené LLM majú pevný „knowledge cutoff“ a ak sa priebežne preučujú na nových dátach, hrozí catastrophic forgetting. Autorom nejde o priebežné písanie do modelu počas inferencie, ale o periodický životný cyklus, v ktorom sa strieda interakcia s používateľom a oddelená offline konsolidácia pamäte.
Wake a sleep ako dve oddelené fázy
Zdroj rozdeľuje chod modelu na dve stavy. V aktívnej fáze model prijíma vstupy a ukladá dočasné informácie do rýchlych krátkodobých pamäťových komponentov. V spánkovej fáze zastaví spracovanie nových vstupov a presmeruje výpočty na konsolidáciu pamäte a samo-zlepšovanie. Google zároveň výslovne uvádza, že hoci používa metafory ako „sleep“ či „dreaming“, celý postup zostáva v pevnej architektúre modelu a v ľuďmi definovaných tréningových pravidlách.
Mechanizmus konsolidácie: kapacita, distilácia, reset
Konsolidácia pamäte má tri hlavné technické kroky. Po prvé, model si počas spánku rozširuje kapacitu: v MoE/Hope architektúre sa odomykajú nové low-rank expertné bloky, ktoré majú ukladať prichádzajúce poznatky bez narušenia starších parametrov. Po druhé, krátkodobé stopy sa prenášajú do dlhodobejších parametrov cez knowledge seeding, ktoré podľa zdroja využíva Generalized Knowledge Distillation a RL-based imitation learning. Po tretie, po dokončení konsolidácie sa dočasné vysokofrekvenčné parametre resetujú, aby sa uvoľnila kapacita pre ďalšie aktívne relácie.
Ako má fungovať knowledge seeding
Pri distilácii zdroj rozlišuje dve zložky. On-policy distillation má učiť rozšírený študentský model z tokenovo špecifickej spätnej väzby na sekvenciách, ktoré si sám vzorkuje. Learning to imitate ho potom odmeňuje za sémantickú aj absolútnu podobnosť s textom učiteľa, vrátane Levenshteinovej vzdialenosti pri dopĺňaní prefixov. Teoretická časť blogu interpretuje tento krok ako štruktúrovanú low-rank kompresiu: nejde o kopírovanie každej krátkodobej stopy, ale o výber smerov, ktoré najlepšie zachovajú správanie modelu a významovo dôležité informácie.
Dreaming: syntetické dáta a výber užitočných aktualizácií
Druhá vetva sleep frameworku je „dreaming“, teda autonómne samo-zlepšovanie na syntetických dátach. Počas generovania sa náhodne aktivujú neštandardní experti, čím sa má premiešať znalosť z rôznych domén a rozšíriť priestor gradientových smerov. Následne model vygenerované „sny“ filtruje gradientovým výberom, aby uprednostnil vzorky s najvyšším potenciálom zlepšiť celkovú schopnosť modelu. Na vybraných vzorkách potom robí supervised fine-tuning a sleduje, či sa výkon na downstream úlohách zlepší.
Aké výsledky Google reportuje
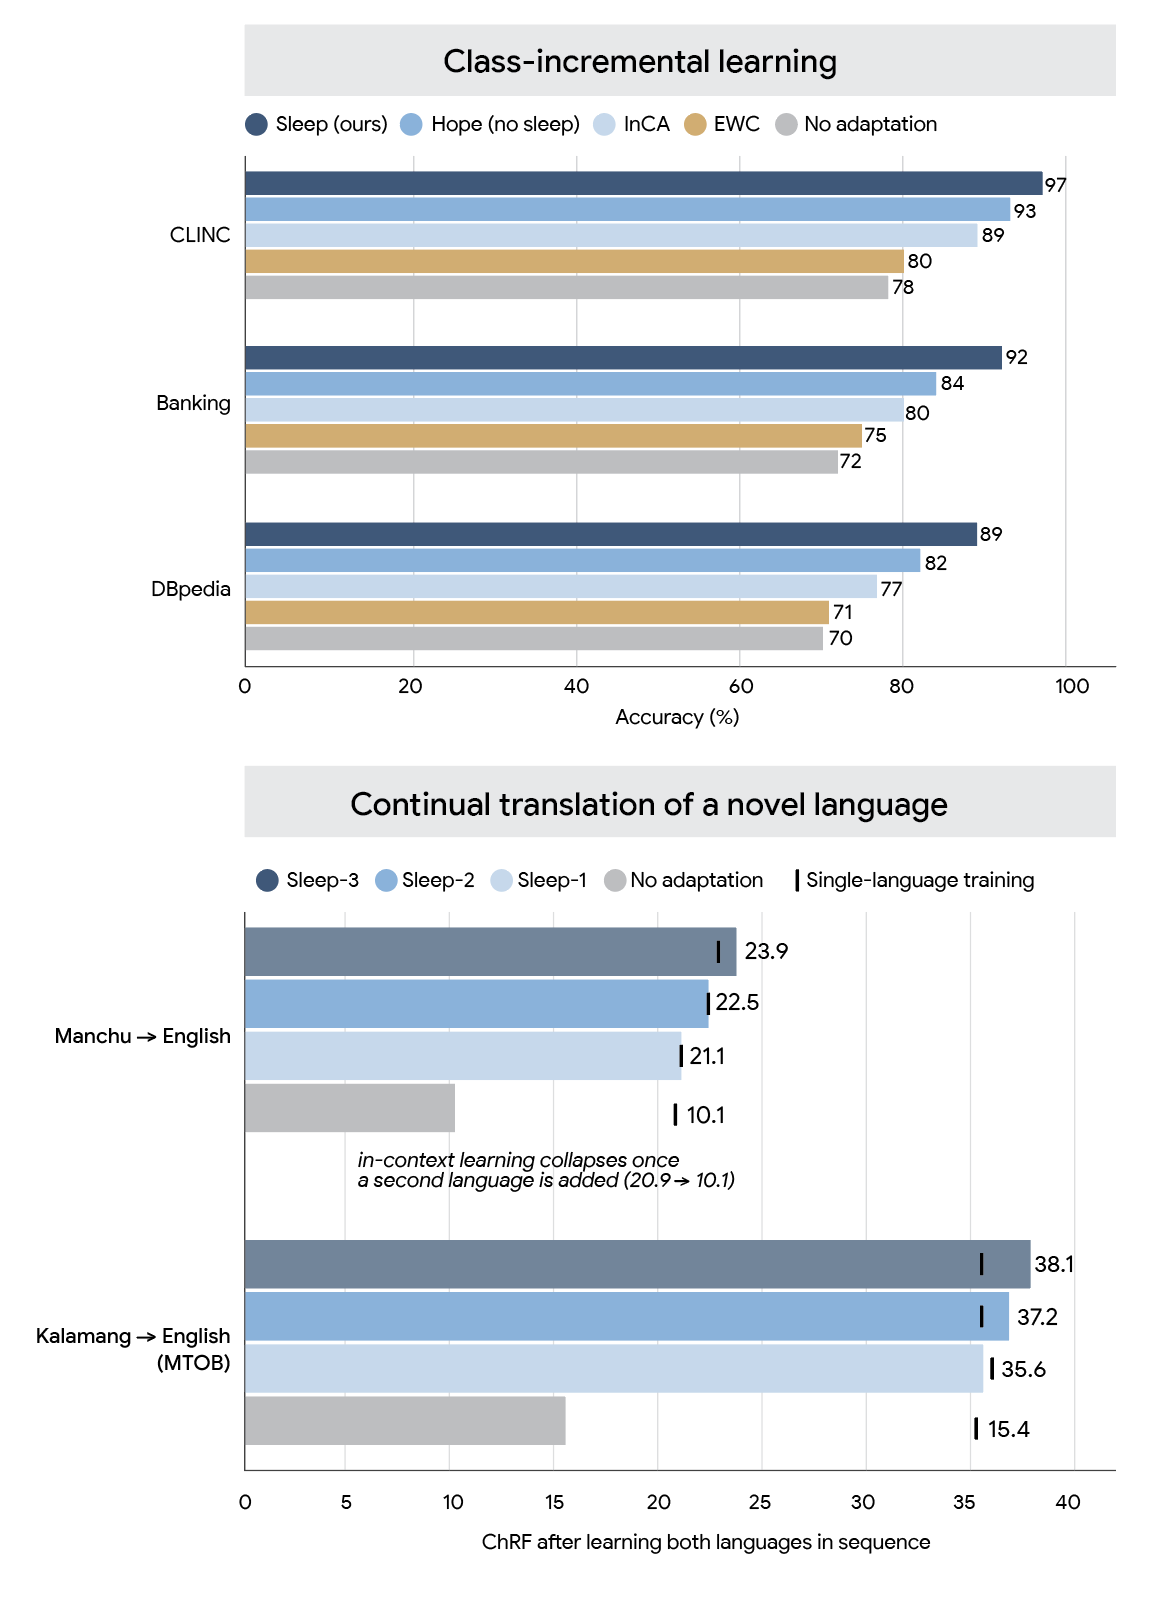
Google tvrdí, že sleep framework prekonal baseline prístupy vo viacerých osiach. Pri continual translation má pri nevidených jazykoch udržať takmer nulový pokles výkonu vo viacstupňových evaluáciách. Pri dlhom kontexte na benchmarku BABILong blog uvádza takmer perfektné škálovanie až do 10M tokenov a prekonanie silných baseline prístupov vrátane GPT-4 a Titans. Pri dopĺňaní faktických znalostí text uvádza 48,9 % na single-task a 46,2 % pri continued pre-training nastavení; pri matematickom reasoningu spomína skóre 79,2 %, 69,0 % a 46,1 % na AIME 24/25 a HMMT 25.
Čo je doložené a čo nie
Hranica článku je dôležitá: všetky výkonové výsledky v dodaných podkladoch pochádzajú z jedného blogového textu Google Research. Máme podrobný opis mechanizmu a explicitné benchmarkové tvrdenia, ale nie nezávislé testovanie, reprodukčný protokol ani externé overenie. Preto je najsilnejšie jadro príbehu samotná zmena lifecycle modelu a konkrétny mechanizmus konsolidácie a dreaming; reportované zlepšenia treba uvádzať ako tvrdenia autora zdroja.
Zdroje
Súvisiace
Ďalšie články k téme
Google Research opisuje stavebné bloky pre autonómne wet laby: digitálne dvojča, uzavreté cykly a bindery pre FAP
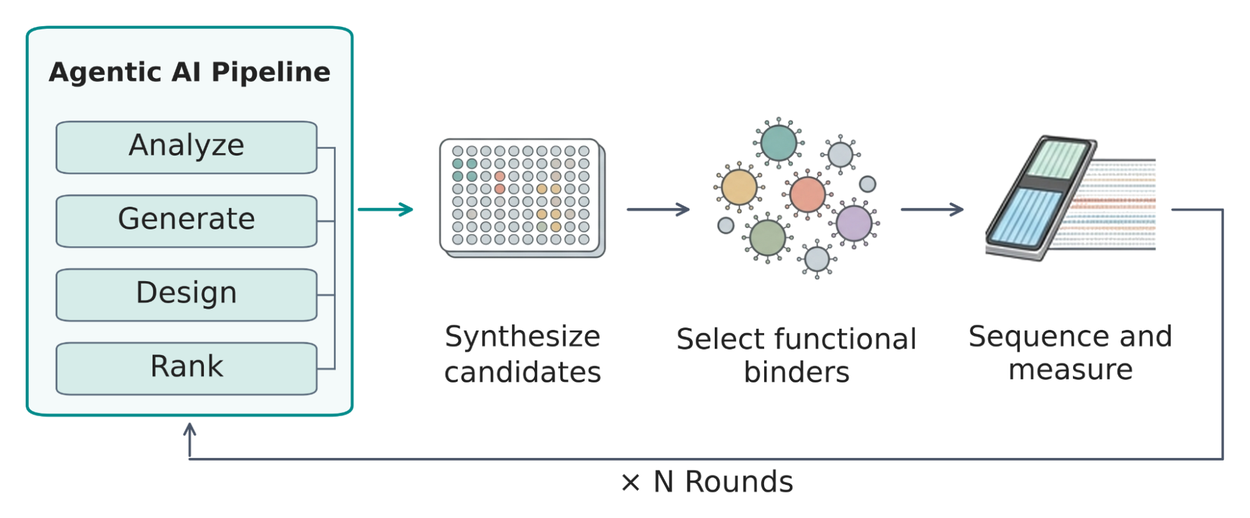
Google Research na svojom blogu predstavilo prístup, v ktorom AI agenti neostávajú len pri návrhu molekúl v softvéri, ale sú napojení na laboratórnu robotiku cez framework VERID. Firma zároveň tvrdí, že v uzavretých cykloch zlepšila hit rate aptamérov pre myoglobín a α-thrombín a pri cieli FAP našla bindery so single-digit nanomolar afinitou. V dodaných podkladoch však ide o firemné tvrdenia a opis interného výskumného postupu, nie o nezávislé externé overenie.
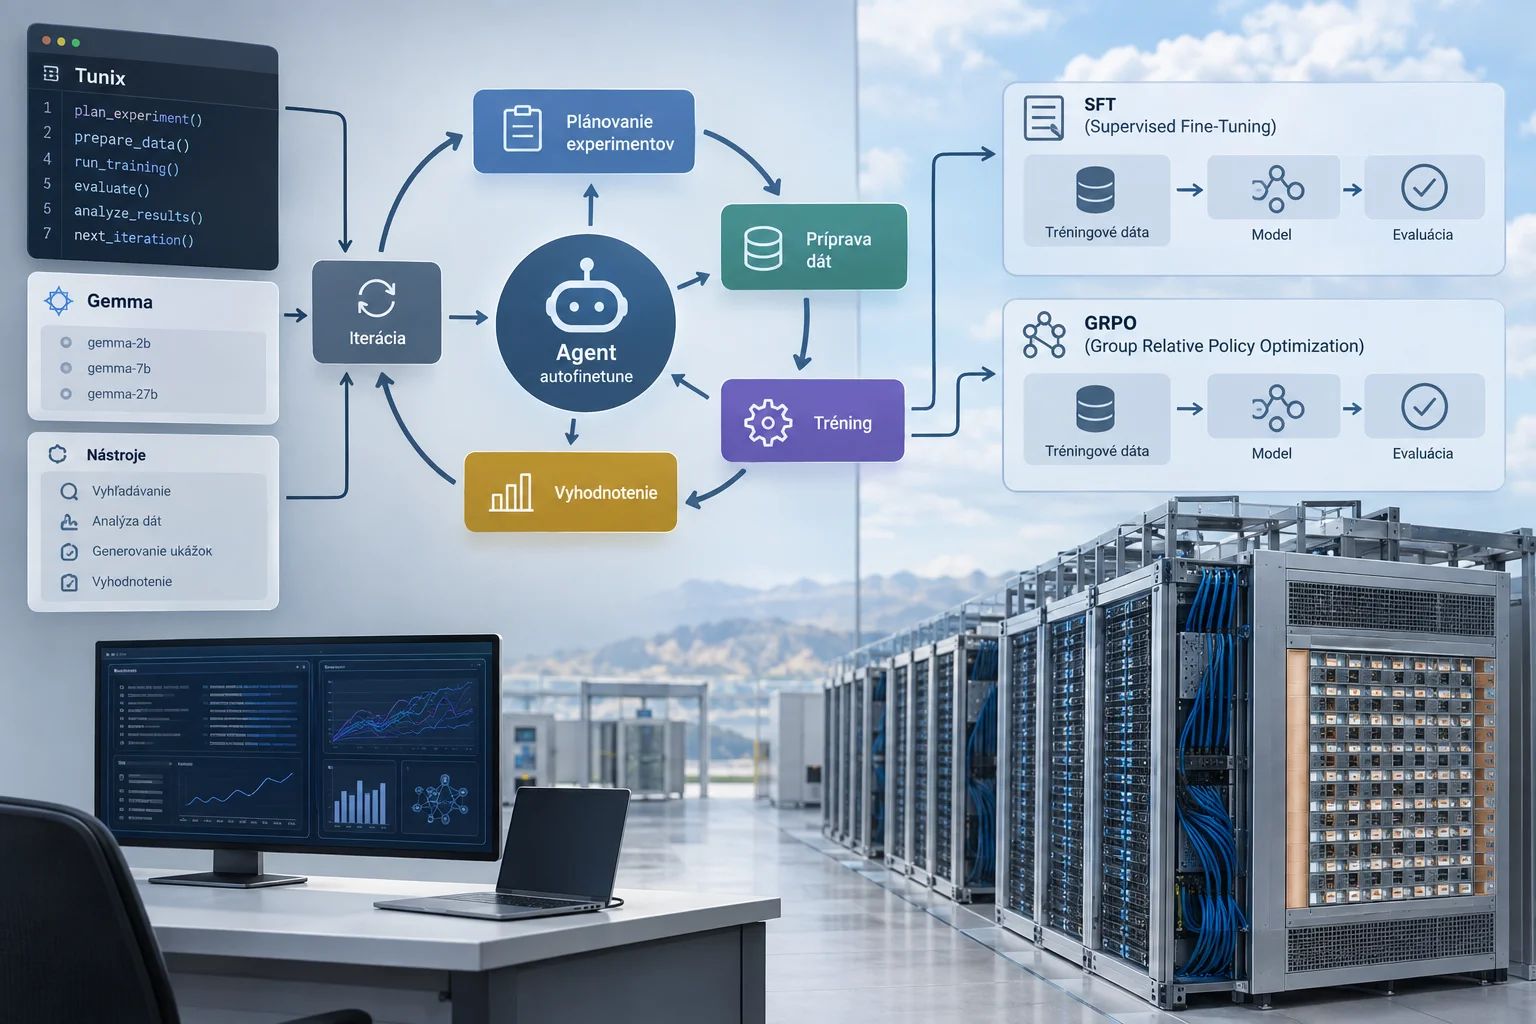
Google opísal autofinetune na Cloud TPU: agentické post-training slučky pre SFT a GRPO
Google Developers Blog 11. septembra 2026 predstavil projekt autofinetune: agentický workflow pre post-training LLM na Cloud TPU s Tunix, Gemma a pomocnými nástrojmi. Podklad ukazuje mechanizmus automatizovaných experimentov pre SFT aj GRPO, no výkonové zlepšenia sú doložené len ako tvrdenia pôvodcu v ukážkových behoch.
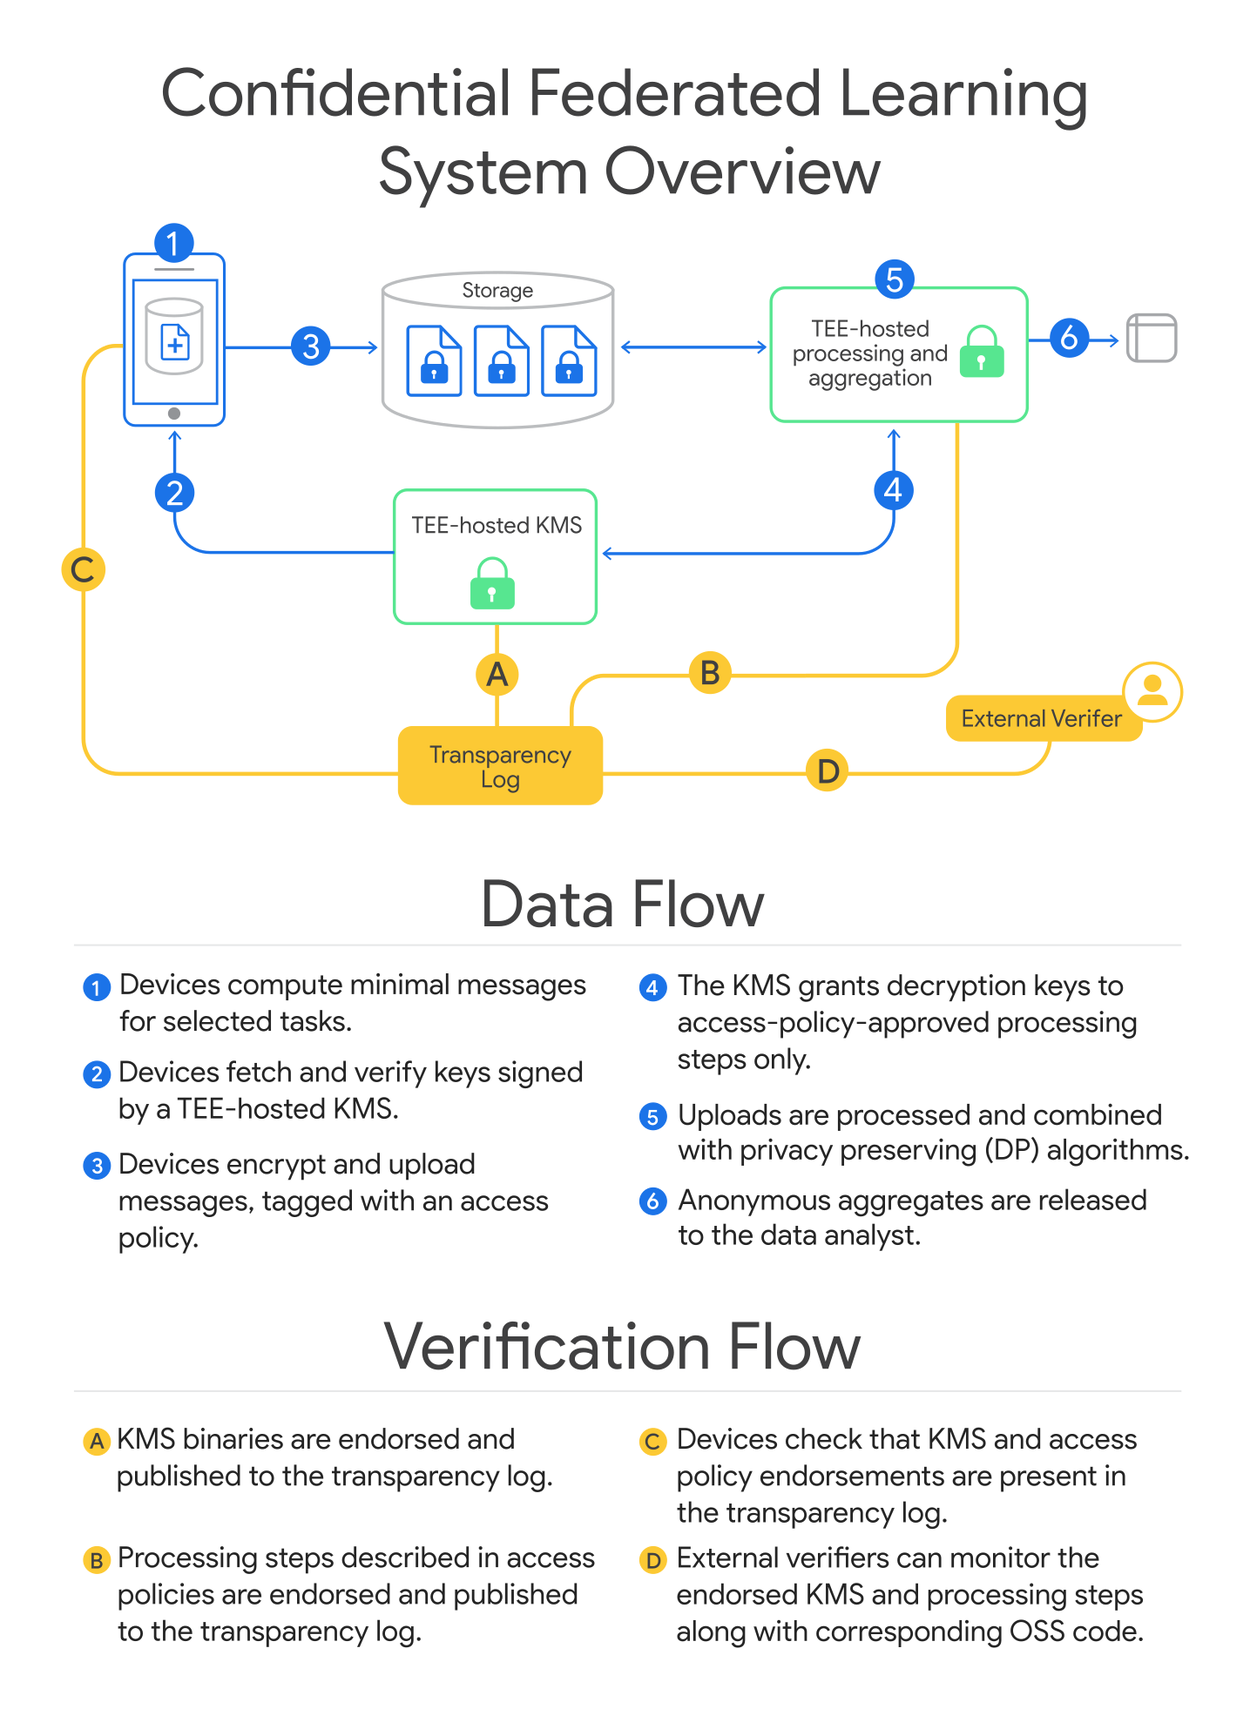
Google opisuje federované učenie s TEE: auditovateľnejšie súkromie a presun tréningu na server
Google Research predstavilo novú generáciu federovaného učenia, v ktorej klienti šifrujú tréningové dáta, prístup povoľujú cez zverejnené politiky a dešifrovanie prebieha len vo workloadoch v Trusted Execution Environments. Firma zároveň tvrdí, že presun výpočtu na server zrýchlil tréning a že Gboard už systém používa pri anglickom a japonskom predikovaní ďalšieho slova; tieto prínosy však v dodaných podkladoch nemajú nezávislé overenie.
KInIT: vysoké skóre ešte neznamená, že multimodálna AI naozaj rozumie obrázkom
KInIT zverejnil 20. októbra 2026 súhrn doktorandského výskumu Ivany Beňovej o multimodálnych modeloch. Podľa autorky môžu modely na jednoduchých benchmarkoch pôsobiť presvedčivo, no pri hľadaní správneho popisu medzi tisíckami možností sa ukáže, že slabšie chápu najmä akcie a vzťahy medzi objektmi.