Téma

LLM

5 publikovaných článkov s dohľadateľnými zdrojmi a revíziami.

Slovensko

KInIT opísal AI program pre Najvyšší kontrolný úrad SR

KInIT 23. októbra 2026 zverejnil opis spolupráce s Najvyšším kontrolným úradom SR, v ktorej nepripravil jedno univerzálne školenie, ale viacero paralelných tratí podľa potrieb zamestnancov. Program podľa zdroja spojil AI gramotnosť, právno-etické konzultácie k AI Actu a GDPR aj technickejšie témy vrátane práce s veľkými dokumentmi pomocou LLM.
Odborný rozbor·3 min
Slovensko

KInIT zhrnul výstupy projektu lorAI: od slovenského benchmarku sk-bench po PEFT-Bench

KInIT 26. októbra 2026 zverejnil stránku „Research powered by lorAI“, na ktorej sumarizuje publikácie podporené projektom lorAI a ďalšie práce s partnermi lorAI. Podľa KInIT záber týchto výstupov siaha od efektívnych LLM a fine-tuningu po auditing, benchmarking a human-centered AI; medzi konkrétnymi príkladmi uvádza aj slovenský benchmark sk-bench a benchmark PEFT-Bench pre parameter-efficient fine-tuning.

Odborný rozbor·3 min
Firmy a výskum

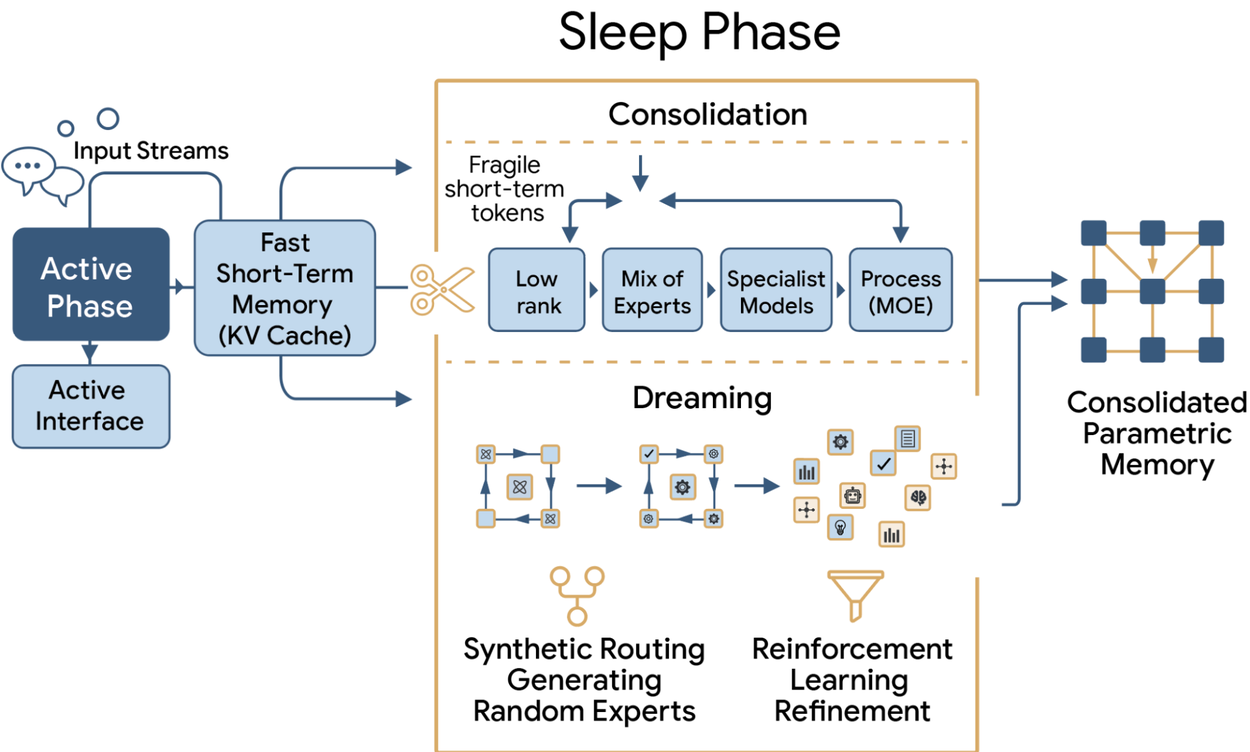
Google Research opisuje „sleep framework“ pre LLM: oddelená fáza spánku má ukladať nové poznatky bez prepísania starých

Google Research predstavilo rámec continual learningu, v ktorom sa model strieda medzi aktívnou fázou a „spánkom“. Počas spánku má konsolidovať krátkodobé stopy do parametrov cez rozšírenie kapacity, distiláciu znalostí a imitation learning; Google zároveň tvrdí zlepšenia pri dlhom kontexte, dopĺňaní faktov aj reasoningu, no v dodaných podkladoch ich nemožno nezávisle overiť.

Odborný rozbor·4 min
AI systémy a vývoj

Benchmark AutoBench tvrdí, že testované LLM routery často neprekonajú ani jednoduchú statickú voľbu modelu

AutoBench Router Benchmark hodnotí routery tak, že iba sleduje, ktorý model zvolia, a k tejto voľbe priradí už uložené skóre aj cenu. Podľa autorov pritom žiadny z testovaných routerov neprekonal statickú voľbu Always-Luna súčasne v kvalite aj cene a viaceré nastavenia sa správajú takmer ako konštantná politika jedného modelu.

Odborný rozbor·3 min
AI systémy a vývoj

Lumma-Fev-v2 sľubuje rozhodovanie bez parsovania textu a v 27B verzii mení attention na bidirekčný

FrontiersMind predstavil rodinu decision modelov Lumma-Fev-v2, ktoré namiesto generovania viet vracajú pravdepodobnosti pre jednotlivé možnosti v jednom forward passe. Podľa článku majú vydané verzie 4B a 27B vyššiu priemernú presnosť než TypeSafe Jev 1.13.0 na ôsmich verejných benchmarkoch a 27B verzia zároveň prechádza na bidirekčný full-attention, zatiaľ čo Gated DeltaNet vrstvy ostávajú kauzálne.

Odborný rozbor·4 min