Lumma-Fev-v2 sľubuje rozhodovanie bez parsovania textu a v 27B verzii mení attention na bidirekčný
FrontiersMind predstavil rodinu decision modelov Lumma-Fev-v2, ktoré namiesto generovania viet vracajú pravdepodobnosti pre jednotlivé možnosti v jednom forward passe. Podľa článku majú vydané verzie 4B a 27B vyššiu priemernú presnosť než TypeSafe Jev 1.13.0 na ôsmich verejných benchmarkoch a 27B verzia zároveň prechádza na bidirekčný full-attention, zatiaľ čo Gated DeltaNet vrstvy ostávajú kauzálne.

FrontiersMind uvádza Lumma-Fev-v2 ako rodinu decision modelov, ktoré sa nesnažia napísať odpoveď vetou. Namiesto toho dostanú vstupný stav a sadu typovaných otázok a vrátia pravdepodobnosti pre každú možnosť v jednom priechode modelom. Prakticky to znamená, že výsledok netreba dodatočne parsovať z textu a systém sa dá priamo použiť na výber možnosti, nastavenie prahu alebo odovzdanie neistej požiadavky človeku.
Najväčšia zmena sa týka modelu Lumma-Fev-27B-v2. Podľa autorov jeho full-attention vrstvy čítajú celý prompt oboma smermi, podobne ako encoder, zatiaľ čo Gated DeltaNet vrstvy ostávajú kauzálne. Pre decision model je to podľa textu prirodzené, lebo stav aj otázky sú známe ešte pred samotným skórovaním odpovede. Zároveň preto treba knižnicu lumma-fev vo verzii 0.3 alebo novšej.
Výkonnostné tvrdenia zatiaľ pochádzajú od výrobcu. Ten uvádza, že vydané modely 4B-v2 a 27B-v2 dosiahli v priemere 82,4 % a 87,3 % presnosti naprieč ôsmimi verejnými benchmarkmi, kým TypeSafe Jev 1.13.0 mal 81,2 %. Článok zároveň tvrdí lepšiu kalibráciu oboch nových modelov, no tiež priznáva oblasti, kde Jev zostáva vpredu, konkrétne BBH a JudgeBench.
Rodina zatiaľ vychádza v dvoch veľkostiach: 4B a 27B. Menšie verzie 0.1B a 0.6B sú v texte označené ako pripravované. Rozhranie má zostať rovnaké ako vo v1, takže existujúce integrácie nemusia meniť spôsob volania modelu; zmenou je skôr vnútorná architektúra, tréning a podľa autorov aj kvalita odhadovaných pravdepodobností.
Podrobnosti a podklady
Ako funguje decision model namiesto textového generátora
Lumma-Fev-v2 je v zdroji opísaný ako rodina decision modelov, nie generátorov textu. Podstatné je tvrdenie: „You give a model a state and typed questions, and it returns a probability for every option in one forward pass. It never generates text, so there is nothing to parse.“ To odlišuje systém od bežného použitia jazykových modelov, kde aplikácia najprv čaká na vetu a potom sa ju snaží previesť na štruktúrovaný výsledok. Zdroj zároveň dopĺňa, že keďže odpoveďou je distribúcia pravdepodobností, dá sa na nej stavať thresholding, routovanie podľa najpravdepodobnejšej voľby alebo eskalácia nízkej istoty na človeka.
Čo sa zmenilo vo v2: bidirekčný full-attention
Najvýraznejšia technická zmena sa týka modelu Lumma-Fev-27B-v2. Zdroj uvádza: „In Lumma-Fev-27B-v2, the full-attention layers read the whole prompt in both directions, like an encoder. The Gated DeltaNet (linear-attention) layers stay causal.“ Článok to zdôvodňuje tým, že pri rozhodovacej úlohe sú stav aj otázky prítomné v prompte ešte pred skórovaním odpovede, takže skoršie tokeny nemusia byť slepé voči neskorším. Praktický dôsledok pre používateľa je kompatibilita iba s novšou knižnicou: „Because of this, the checkpoint needs lumma-fev 0.3 or later. Older versions do not apply bidirectional attention and refuse to load it.“
Tréningové dáta a použitý tréningový nástroj
Zdroj tvrdí, že model 27B-v2 trénovali na väčšom datasete než predchodcu: „Lumma-Fev-27B-v2 trains on about 300K samples, up from about 100K for v1.“ Zároveň uvádza, že modely boli trénované pomocou open-source knižnice decisionformer s licenciou Apache 2.0, určenej na fine-tuning, načítanie a serving kalibrovaných decision modelov. To je dôležité najmä ako opis výrobcom použitej tréningovej cesty; zdroj však neposkytuje nezávislé porovnanie, ktoré by izolovalo vplyv architektonickej zmeny oproti väčšiemu množstvu dát.
Výsledky na ôsmich verejných benchmarkoch
Benchmarková časť je výrobcom deklarované porovnanie s TypeSafe Jev 1.13.0. Zdroj hovorí: „Both released models score higher than TypeSafe Jev 1.13.0 on average across eight public benchmarks, and both are better calibrated.“ V tabuľke je priemer 82.4 pre Lumma-Fev-4B-v2, 87.3 pre Lumma-Fev-27B-v2 a 81.2 pre Jev. Článok zároveň uvádza, že Jev zostáva silnejší v BBH a JudgeBench, takže nejde o univerzálne víťazstvo vo všetkých úlohách. Keďže ide o vlastné vyhodnotenie autorov, treba tieto čísla čítať ako výrobcom uvádzané výsledky, nie ako nezávisle replikované testy.
Kalibrácia a hranice použitia v automatizácii
Samostatná časť sa venuje kalibrácii, teda tomu, či deklarovaná istota zodpovedá reálnej úspešnosti. Zdroj uvádza: „Both Lumma-Fev-v2 models beat Jev on log loss, ECE and Brier, and Lumma-Fev-27B-v2 is the best calibrated of the three on every metric.“ Pre priemer cez osem benchmarkov potom uvádza log loss 0.401 a 0.307, ECE 0.045 a 0.024 a Brier 0.237 a 0.178 pre 4B-v2 a 27B-v2, oproti 1.315, 0.088 a 0.291 pre Jev. Zároveň však text pridáva dôležité obmedzenie: pred automatickým spúšťaním akcií treba prahy naladiť na vlastných označených dátach.
API kompatibilita, limity a čo ešte len príde
Rozhranie má zostať kompatibilné s predchádzajúcou verziou: „Every Lumma-Fev-v2 model uses the interface of v1, so nothing changes for existing users.“ Model pracuje so stavom vo forme textu, JSON objektu alebo poľa a s otázkami typu noul a choice; typ score je podľa zdroja „accepted, but untested“. Pri nasadení zdroj uvádza aj limity: 27B-v2 potrebuje asi 55 GB voľnej GPU pamäte, používa BF16 a Safetensors a „a question plus the state must fit in 8,192 tokens“. Menšie modely 0.1B-v2 a 0.6B-v2 sú podľa článku iba pripravované, nie vydané.
Zdroje
Súvisiace
Ďalšie články k téme
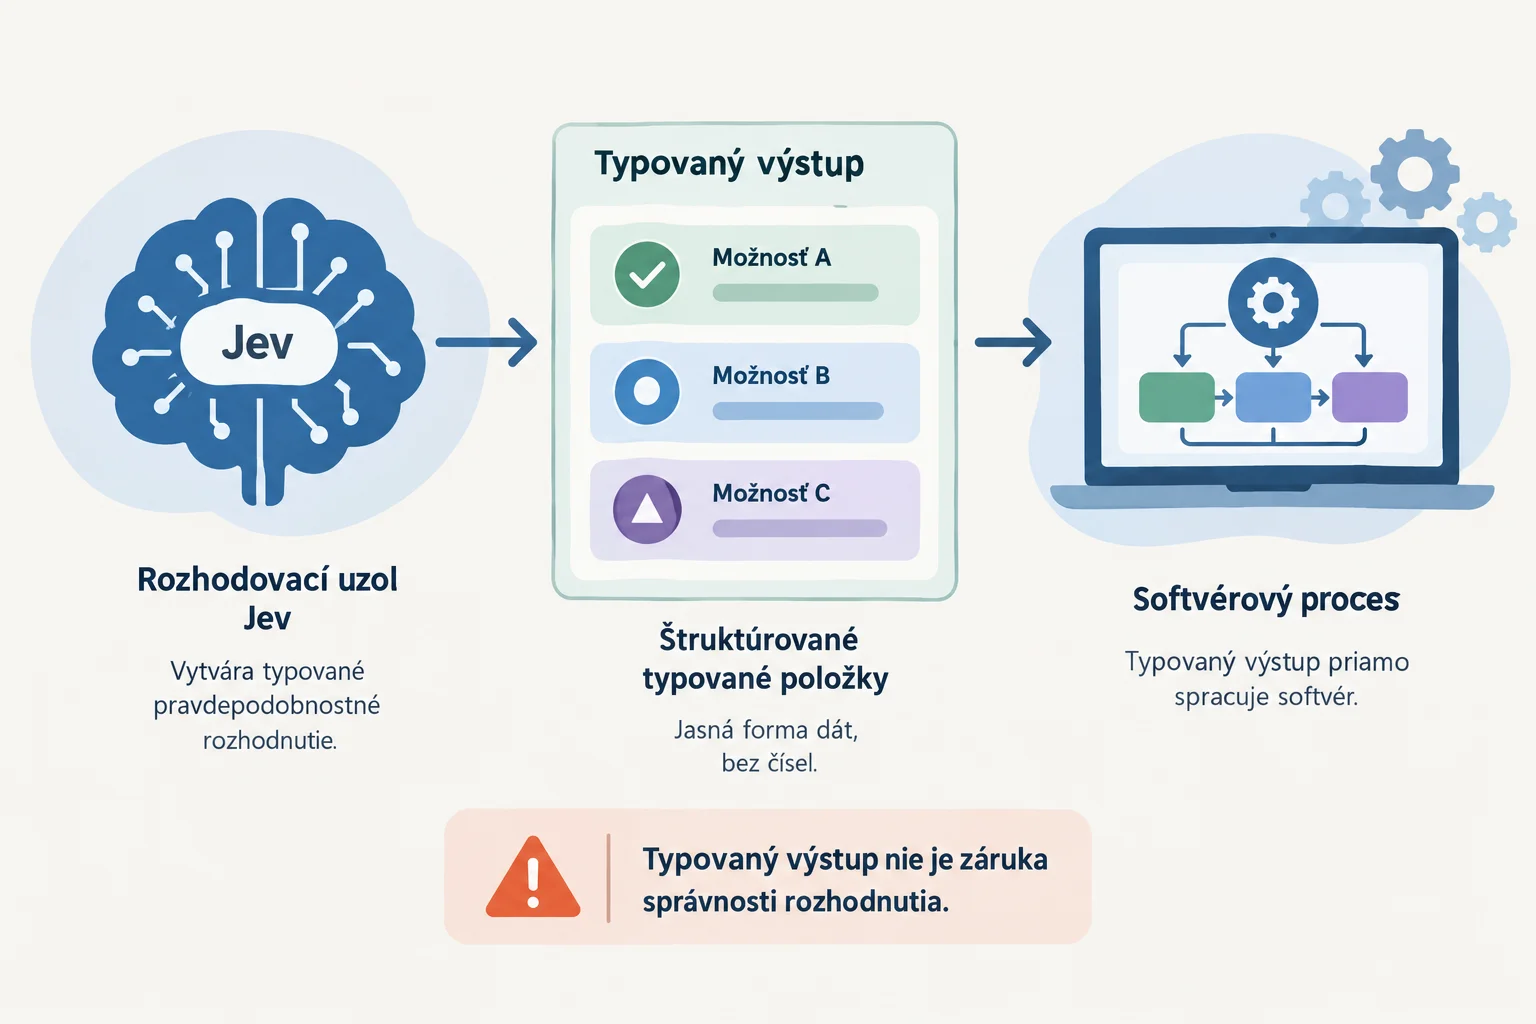
Jev od TypeSafe AI: čo znamená model pre štruktúrované rozhodovanie
Rozbor oznámenia z 15. septembra 2026: typované rozhodnutia, early access a hranice firemných dôkazov.
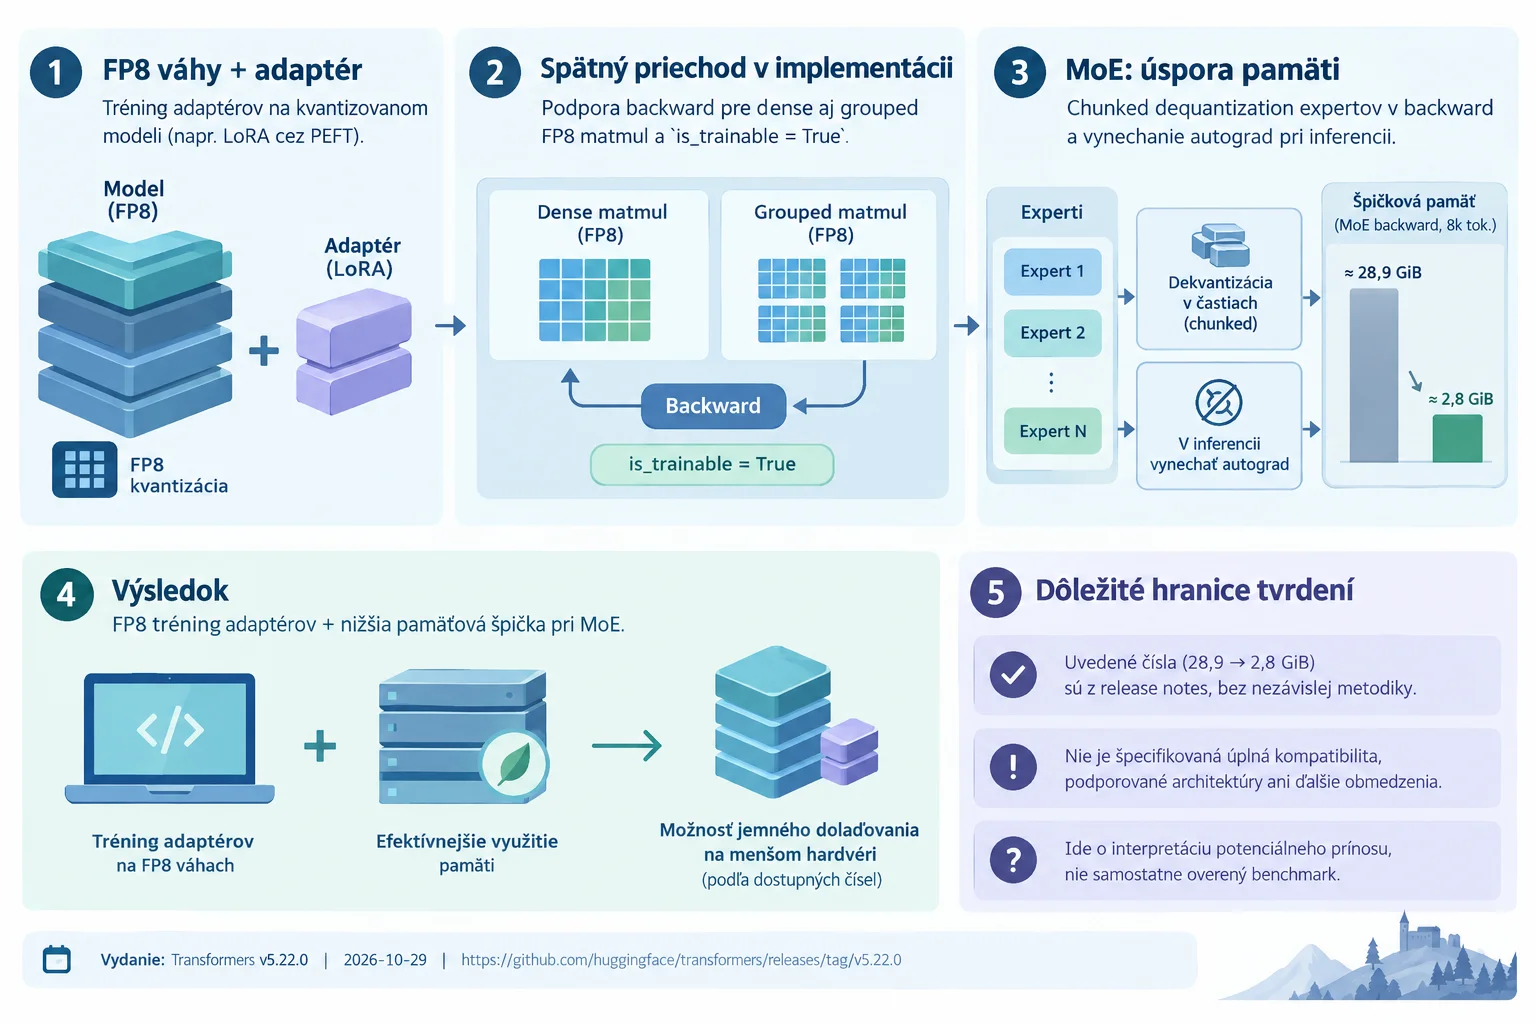
Transformers v5.22.0 prináša FP8 tréning adaptérov a nižšiu pamäťovú špičku pri MoE
V poznámkach k vydaniu Transformers v5.22.0 Hugging Face uvádza, že FP8 kvantizované modely sa dajú použiť na tréning adaptérov, napríklad LoRA cez PEFT. Zmena stojí na doplnení spätného priechodu pre dense aj grouped FP8 matmul operácie a na tom, že `is_trainable` je teraz `True`. Dokument zároveň tvrdí, že chunked dequantization expertov v backward a vynechanie autograd pri inferencii znižujú špičkovú pamäť v MoE vrstve backward z približne 28,9 GiB na 2,8 GiB pri 8k tokenoch.
DiffuSpace uviedol Clover-35B-A3B-Preview a tvrdí vyššiu rýchlosť aj silnejšie výsledky než podobne veľké autoregresívne modely
DiffuSpace oznámil prvú verziu modelovej línie Clover. Podľa firmy ide o 35B MoE difúzny jazykový model s 3B aktivovanými parametrami, otvorený pod licenciou Apache, pričom výrobca pripisuje jeho rýchlosť a výsledky prepracovanej architektúre Bidirectional Gated DeltaNet a uvádza vlastné benchmarky aj nameranú priepustnosť inferencie.
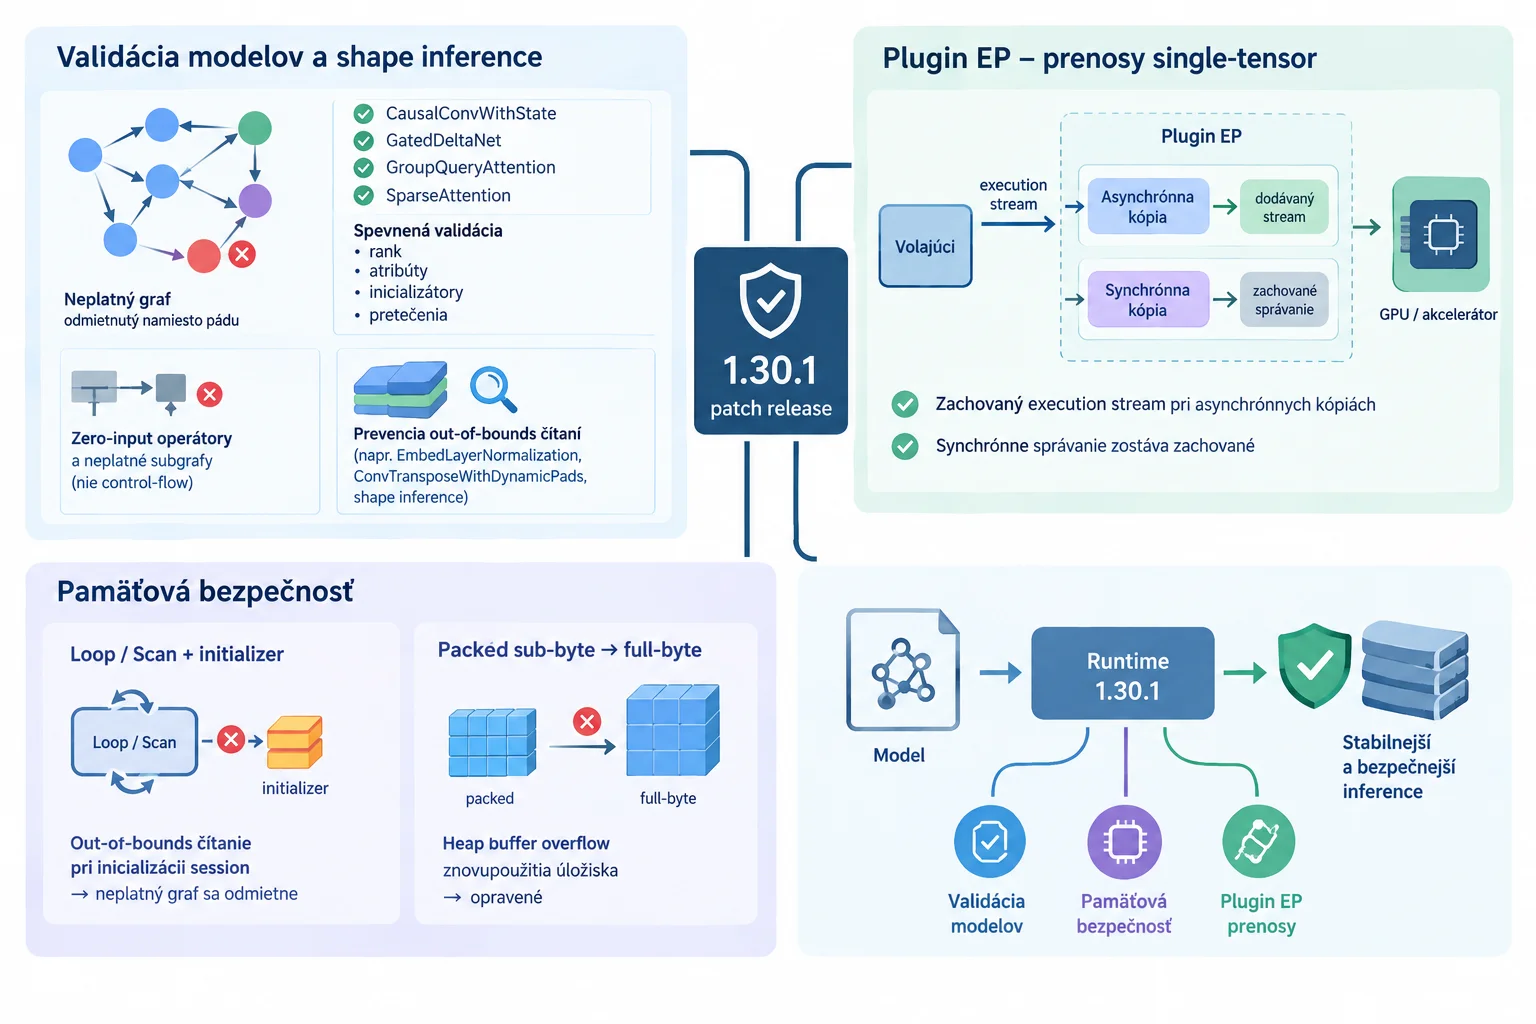
ONNX Runtime 1.30.1 opravuje validáciu modelov a prenosy Plugin EP bez sľubov o výkone
Microsoft vydal ONNX Runtime 1.30.1 ako patch release nad verziou 1.30.0. Poznámky k vydaniu uvádzajú cielené opravy validácie modelov a memory-safety, konkrétne prevenciu out-of-bounds čítaní, heap buffer overflow a odmietanie neplatných grafov namiesto pádu; zároveň sa mení správanie Plugin EP tak, že pri single-tensor prenosoch zachová execution stream volajúceho pre asynchrónne kópie, pričom synchronné správanie ostáva zachované. Dodaný zdroj však neobsahuje nezávislé testy ani kvantifikáciu dopadu.