Transformers v5.22.0 prináša FP8 tréning adaptérov a nižšiu pamäťovú špičku pri MoE
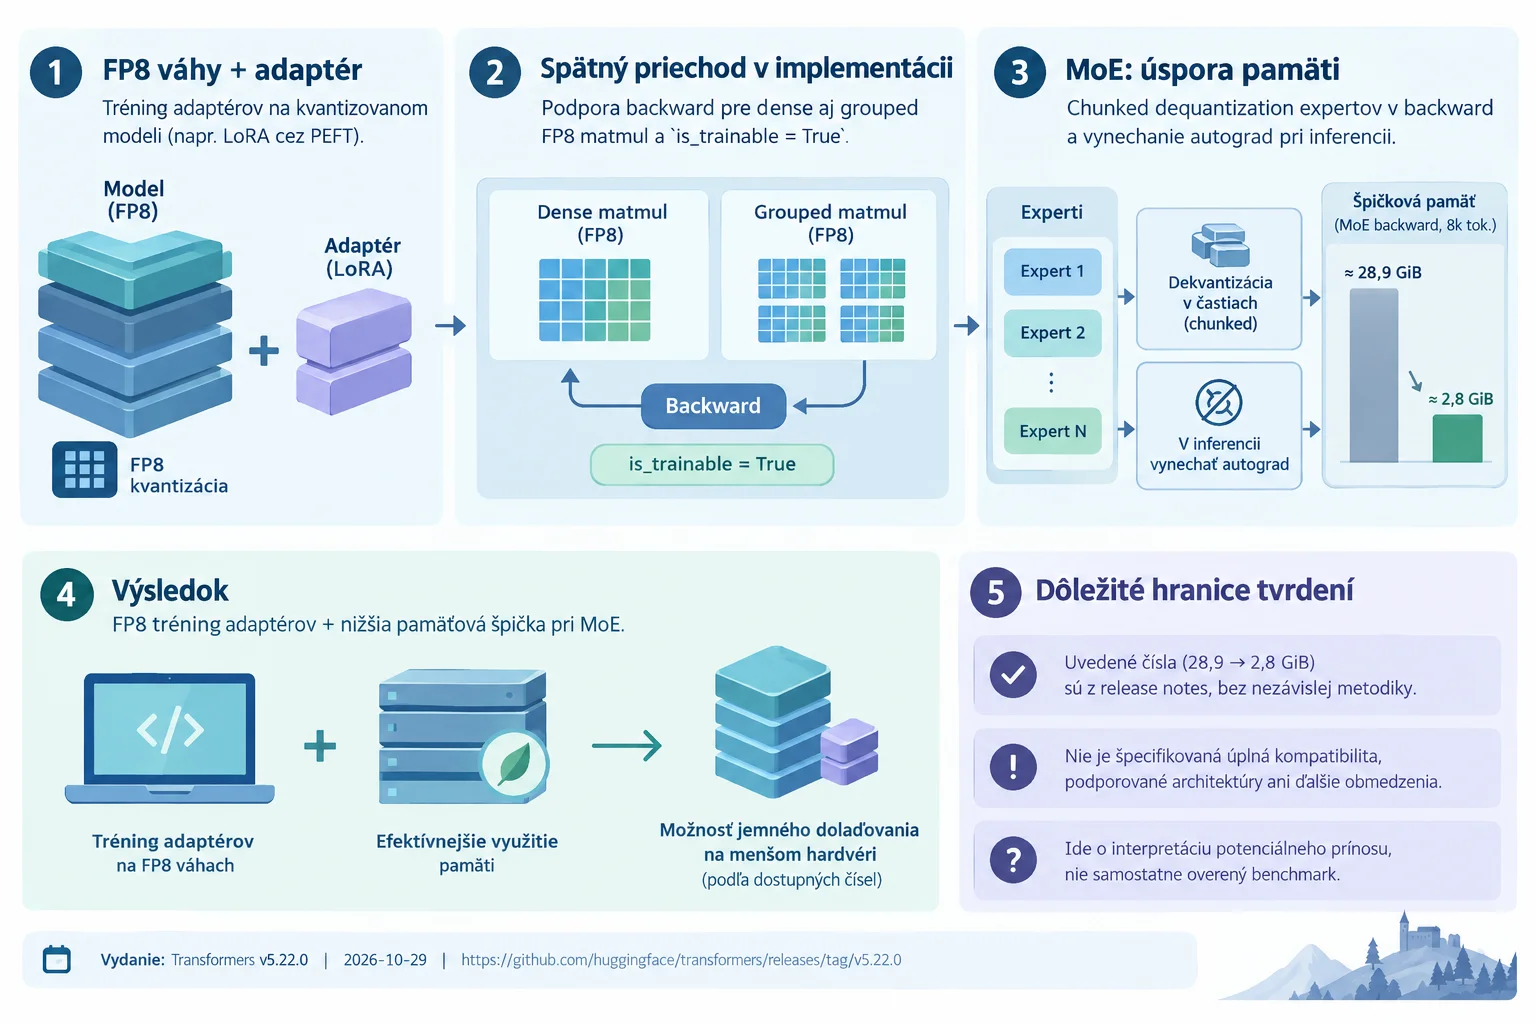
V poznámkach k vydaniu Transformers v5.22.0 Hugging Face uvádza, že FP8 kvantizované modely sa dajú použiť na tréning adaptérov, napríklad LoRA cez PEFT. Zmena stojí na doplnení spätného priechodu pre dense aj grouped FP8 matmul operácie a na tom, že `is_trainable` je teraz `True`. Dokument zároveň tvrdí, že chunked dequantization expertov v backward a vynechanie autograd pri inferencii znižujú špičkovú pamäť v MoE vrstve backward z približne 28,9 GiB na 2,8 GiB pri 8k tokenoch.
Hugging Face v poznámkach k vydaniu Transformers v5.22.0 popisuje praktickú zmenu pre ľudí, ktorí jemne dolaďujú veľké modely: FP8 kvantizované váhy sa po novom dajú použiť aj na tréning adaptérov, napríklad LoRA cez PEFT. Nejde len o formálne zapnutie voľby, ale o zásah do tréningovej cesty knižnice.
Mechanizmus je v zdroji pomenovaný pomerne presne. Release uvádza, že pribudli backward priechody pre dense aj grouped FP8 matmul operácie a že is_trainable je teraz nastavené na True. Inými slovami, FP8 cesta už nie je len na inferenciu, ale má aj potrebné súčasti pre tréning adaptérov.
Najdôležitejší praktický bod je pamäť. Podľa release sa v backward pri MoE expertov používa dekvantizácia po častiach a pri inferencii sa obchádza autograd, čo má znížiť špičkovú pamäť v MoE layer backward z asi 28,9 GiB na 2,8 GiB pri 8-tisíc tokenoch. To môže v praxi sprístupniť FP8+LoRA dolaďovanie aj na skromnejšom hardvéri, no tento širší dôsledok tu nie je nezávisle otestovaný mimo samotného zdroja.
Dodané podklady neobsahujú nezávislý benchmark ani podrobný zoznam podporovaných architektúr, takže článok sa opiera o to, čo explicitne tvrdia release notes. Dátum vydania je však v metadátach dokumentu overiteľný: ide o release publikovaný 29. októbra 2026.
Podrobnosti a podklady
Čo sa konkrétne zmenilo
Relevantná novinka v release nespočíva v novom modeli, ale v sekcii „Quantization“. Tá explicitne hovorí: „FP8 quantized models can now be used for adapter training (such as LoRA with PEFT).“ To priamo podporuje tvrdenie, že v Transformers v5.22.0 pribudla podpora tréningu adaptérov nad FP8 kvantizovanými váhami. Text nehovorí o plnom pretrénovaní modelu, ale konkrétne o adapter trainingu, preto je vhodné držať sa tejto užšej formulácie.
Mechanizmus v implementácii
Mechanizmus je v release rozpísaný v tej istej pasáži: „Backward passes were added to the dense and grouped FP8 matmuls, and is_trainable is now True." To znamená dve veci. Po prvé, FP8 implementácia dostala spätný priechod pre husté aj grouped maticové násobenia. Po druhé, knižnica už túto cestu označuje ako trénovateľnú. Z dodaného dôkazu teda vyplýva, že nejde len o dokumentačnú zmenu, ale o doplnenie potrebnej tréningovej infraštruktúry v implementácii.
Prečo klesá pamäťová špička
Release pridáva aj technický detail optimalizácie pamäte: „Backward also dequantizes experts in chunks and skips autograd at inference, which cuts peak memory in the MoE layer backward from about 28.9 GiB to 2.8 GiB at 8k tokens.“ Z tohto textu sa dajú oddeliť tri presné body. Po prvé, dekvantizácia expertov v backward prebieha po častiach. Po druhé, pri inferencii sa preskakuje autograd. Po tretie, zdroj uvádza konkrétne čísla o poklese pamäťovej špičky v MoE vrstve backward pri 8k tokenoch. Tieto čísla sú tvrdením release notes; v dodaných podkladoch nie je nezávislá metodika merania ani reprodukcia výsledku.
Praktický význam a hranice tvrdení
Praktický význam treba formulovať opatrne. Z explicitne uvedeného poklesu peak memory možno rozumne vyvodiť, že jemné dolaďovanie MoE modelov s FP8 váhami a adaptérmi môže byť realizovateľné na menej pamäťovo náročnom hardvéri než predtým. To je však interpretácia založená na číslach zo zdroja, nie samostatne overený benchmark v tomto článku. Podklady zároveň nešpecifikujú úplný rozsah kompatibility, podporované architektúry ani ďalšie obmedzenia tejto FP8 tréningovej cesty.
Dátum a zdroj
Časové zaradenie release je overiteľné z metadát dokumentu. Dodaný záznam nesie published_at „2026-10-29T14:15:39+00:00“ a ide o release stránku „https://github.com/huggingface/transformers/releases/tag/v5.22.0“. To stačí na tvrdenie, že článok vychádza z release publikovaného 29. októbra 2026. Nie je však potrebné z toho odvádzať nič o širšej adopcii alebo dlhodobej stabilite funkcie.
Zdroje
Súvisiace
Ďalšie články k téme
Hugging Face vydal patch release Transformers v5.22.1, ktorý podľa poznámky opravuje dokumentáciu
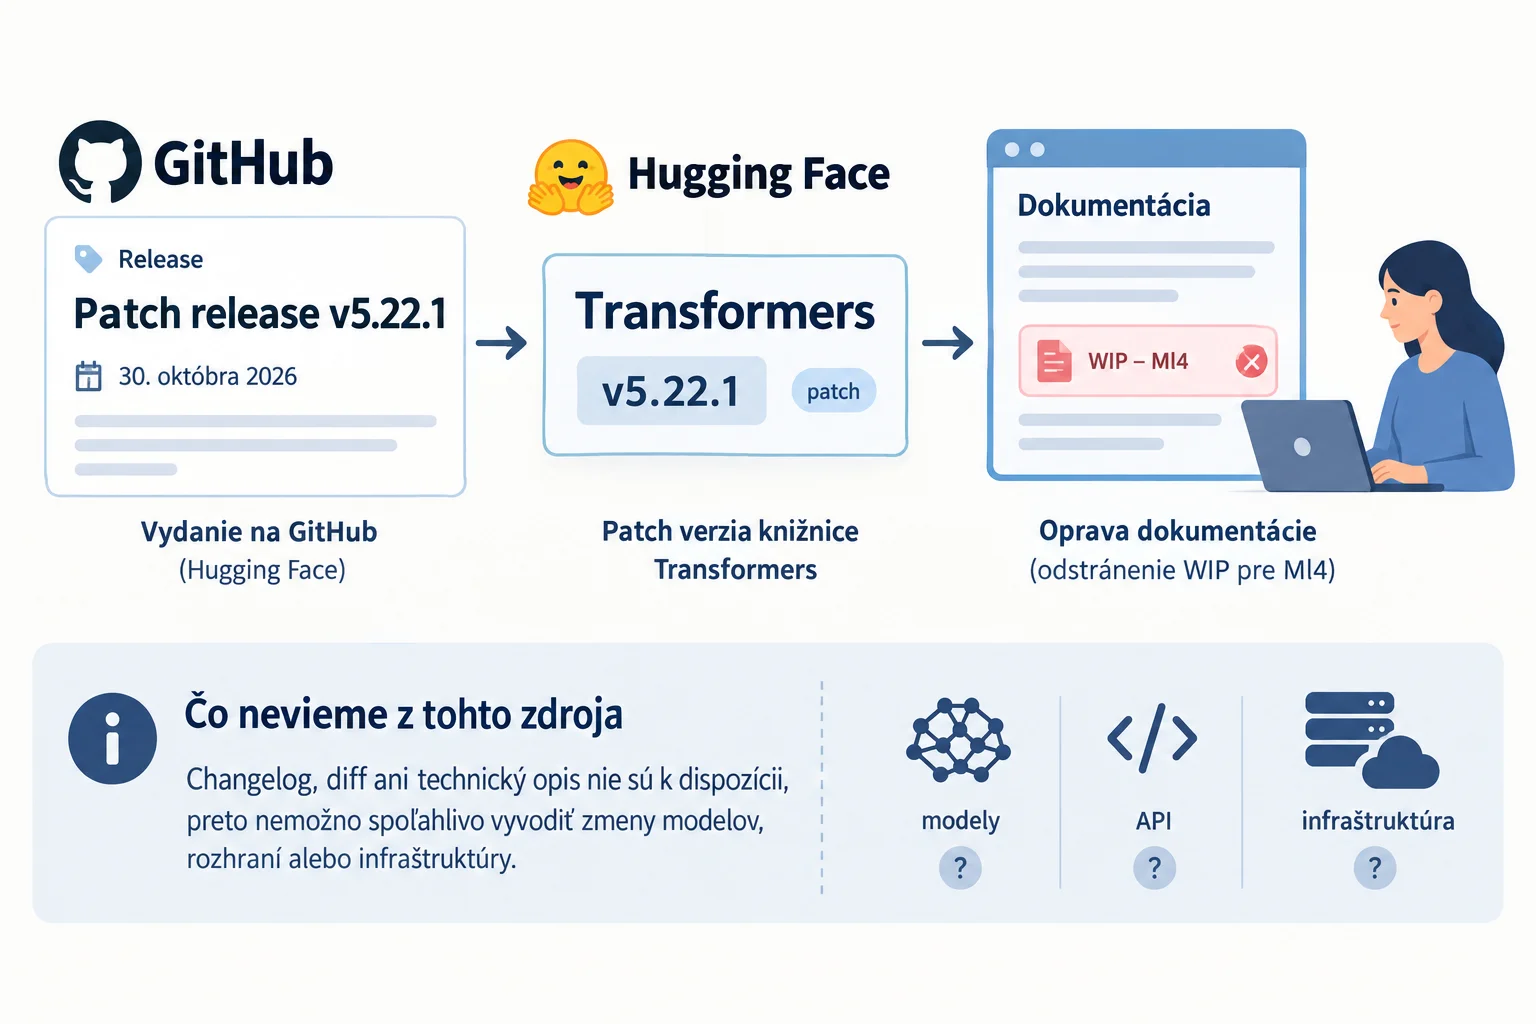
Krátke vydanie Transformers v5.22.1 z 30. októbra 2026 je podľa release note zamerané na opravu dokumentácie. Poznámka konkrétne uvádza odstránenie WIP dokumentu pre Ml4, bez zmien modelových schopností či API doložených v dodanom zdroji.
DiffuSpace uviedol Clover-35B-A3B-Preview a tvrdí vyššiu rýchlosť aj silnejšie výsledky než podobne veľké autoregresívne modely
DiffuSpace oznámil prvú verziu modelovej línie Clover. Podľa firmy ide o 35B MoE difúzny jazykový model s 3B aktivovanými parametrami, otvorený pod licenciou Apache, pričom výrobca pripisuje jeho rýchlosť a výsledky prepracovanej architektúre Bidirectional Gated DeltaNet a uvádza vlastné benchmarky aj nameranú priepustnosť inferencie.
KInIT: pri slovenskom rozpoznávaní reči je problém skôr v dátach než v modeloch
KInIT 22. októbra 2026 uviedol, že zverejnil 39-hodinový slovenský ASR benchmark na SLAIH a prvé doladené otvorené modely. Podľa jeho výsledkov dosiahol na rovnakých dátach najsilnejší komerčný systém 10,8 % word error rate a najlepší bežne dostupný open-weight model 17,5 %, pričom po doladení na slovenčine chybovosť v skúšaných architektúrach klesla približne na polovicu. Inštitút zároveň upozorňuje na dve hranice: úzku dátovú rozmanitosť a zhoršenie výkonu v iných jazykoch po plnom fine-tuningu.
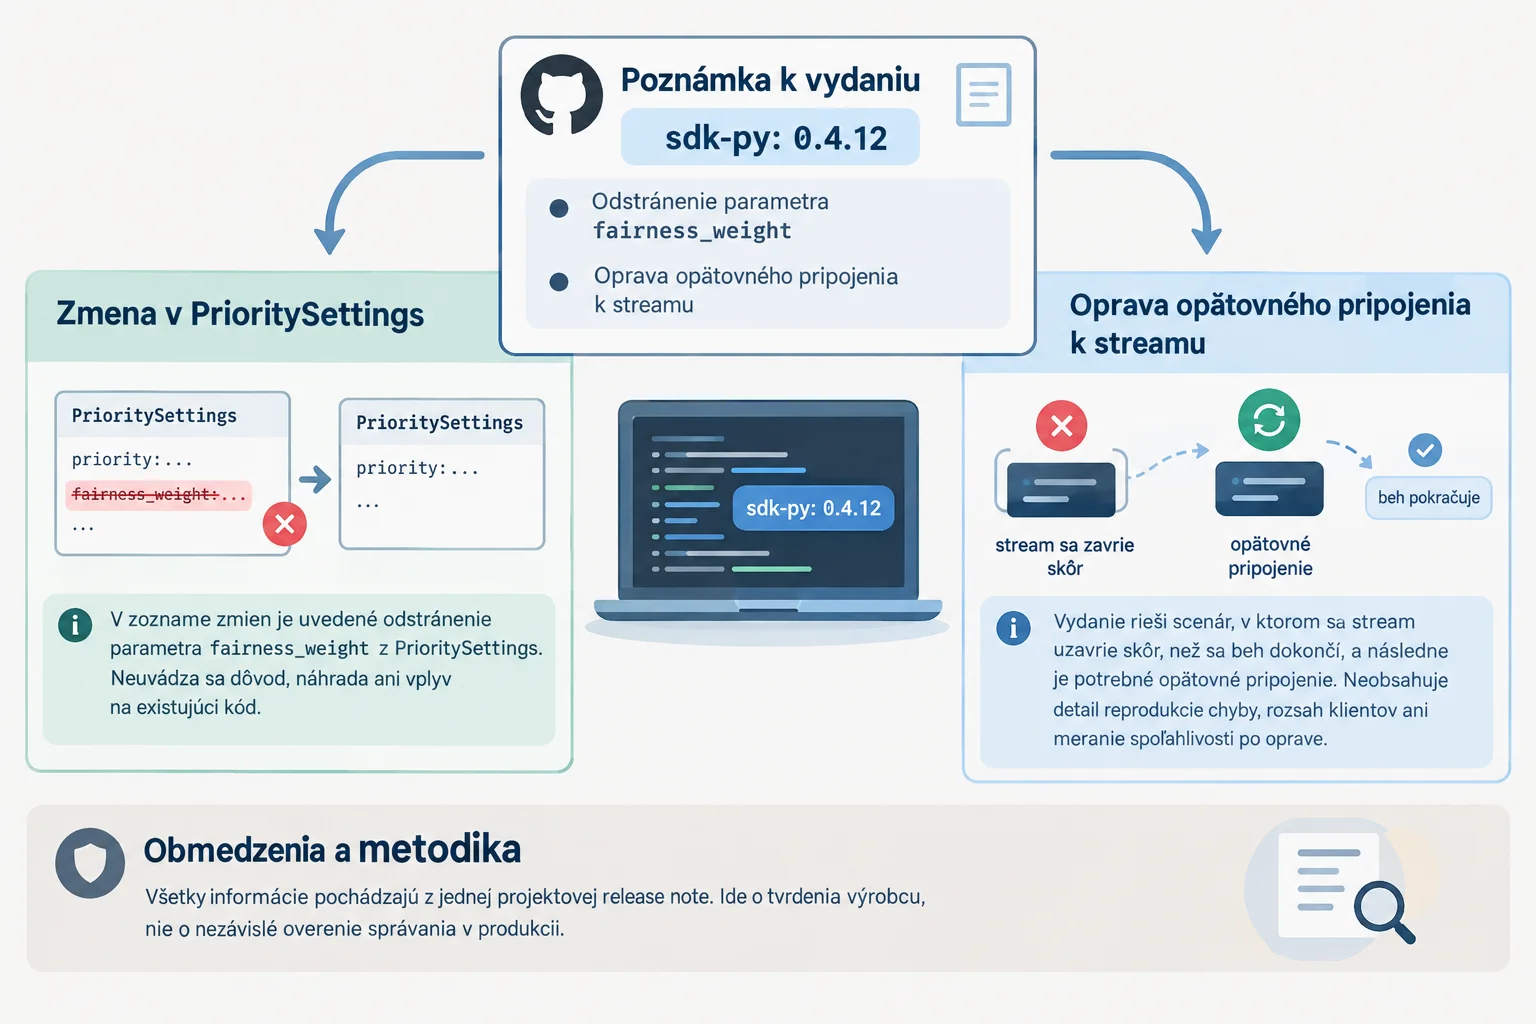
LangGraph podľa poznámky k vydaniu vydal sdk-py 0.4.12 s odstránením jednej voľby a opravou streamu
Poznámka k vydaniu na GitHube uvádza, že vyšlo sdk-py 0.4.12. Zoznam zmien je stručný: odstránenie parametra fairness_weight z PrioritySettings a oprava opätovného pripojenia k run streamu, ktorý sa zavrie skôr, než sa beh skončí.