KInIT: pri slovenskom rozpoznávaní reči je problém skôr v dátach než v modeloch
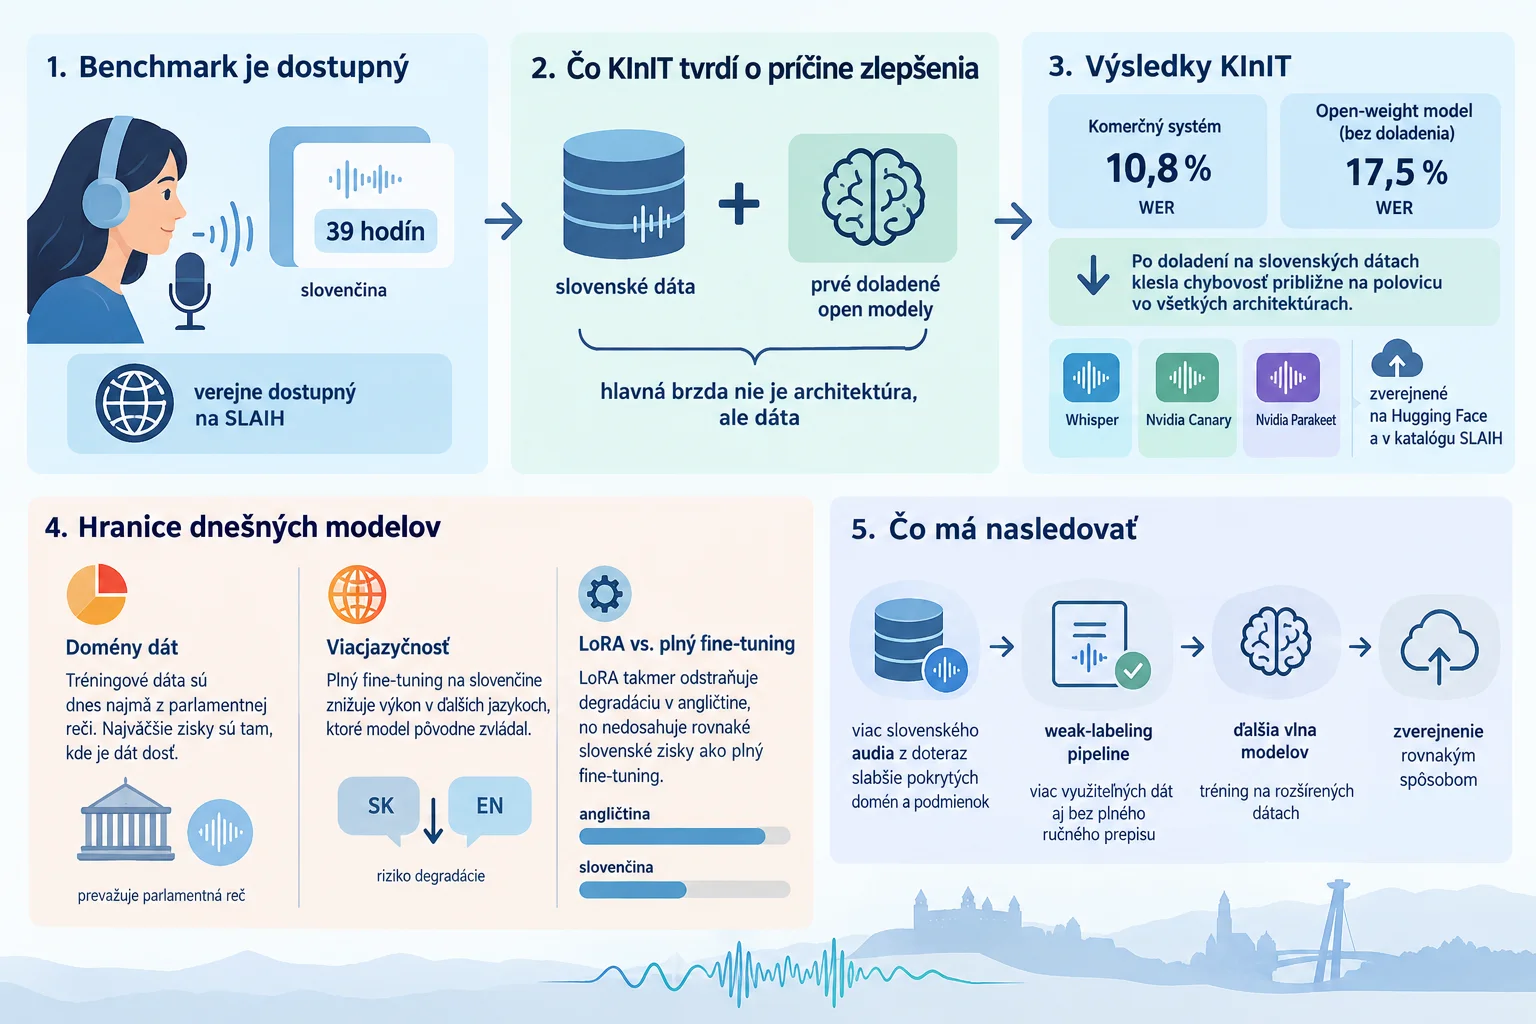
KInIT 22. októbra 2026 uviedol, že zverejnil 39-hodinový slovenský ASR benchmark na SLAIH a prvé doladené otvorené modely. Podľa jeho výsledkov dosiahol na rovnakých dátach najsilnejší komerčný systém 10,8 % word error rate a najlepší bežne dostupný open-weight model 17,5 %, pričom po doladení na slovenčine chybovosť v skúšaných architektúrach klesla približne na polovicu. Inštitút zároveň upozorňuje na dve hranice: úzku dátovú rozmanitosť a zhoršenie výkonu v iných jazykoch po plnom fine-tuningu.
Slovenské rozpoznávanie reči sa podľa KInIT neposúva najmä preto, že mu chýbajú vhodné dáta, nie nutne nové architektúry modelov. Inštitút preto zverejnil 39-hodinový benchmark pre slovenčinu na SLAIH a zároveň prvé doladené otvorené modely, ktoré majú pomôcť vývojárom stavať hlasové aplikácie priamo pre slovenské použitie.
KInIT tvrdí, že na jeho benchmarku dosiahol najsilnejší komerčný systém 10,8 % word error rate, kým najlepší bežne dostupný open-weight model 17,5 %. Dôležité je, že po doladení na slovenských dátach chybovosť v testovaných architektúrach klesla približne na polovicu, takže rozdiel sa podľa autorov dá zmenšiť skôr zberom a kurátorovaním dát než úplne novým modelovaním.
Výsledok však netreba čítať ako hotové vyriešenie slovenčiny. KInIT sám uvádza, že tréningové dáta sú zatiaľ silno naklonené niekoľkým doménam, najmä parlamentným prejavom, a že plný fine-tuning na slovenčine zhoršuje výkon v iných jazykoch. To je praktický problém najmä tam, kde sa v slovenskej reči mieša angličtina.
Najnovší posun je teda skôr o otvorenom základe než o definitívnom víťazovi. KInIT plánuje ďalšie modely natrénované na väčšom objeme slovenského audia a s využitím weak-labeling pipeline, čo by malo rozšíriť pokrytie mimo dnešných lepšie zastúpených typov nahrávok.
Podrobnosti a podklady
Čo KInIT oznámil
KInIT v texte z 22. októbra 2026 opisuje projekt so zámerom dostať slovenské rozpoznávanie reči do pásma, kde je použiteľné pre praktické aplikácie, a zároveň výsledné modely sprístupniť otvorene. Zdroj výslovne spája tému s bežnými scenármi ako poznámky zo stretnutí, archívy médií, prístupnostné nástroje či analytika zákazníckej podpory, no samotný nový oznam je konkrétne o zverejnení benchmarku a prvých doladených modelov pre slovenčinu.
Ako je zostavený benchmark
Jadrom podkladu je nový benchmark pre slovenčinu. KInIT uvádza, že vybudoval Slovak ASR Benchmark publikovaný na SLAIH. Podľa zdroja má 39 hodín kurátorovaného audia a je rozvrstvený podľa domény, typu reči a rodu hovoriaceho tak, aby výsledok nestál na jedinom zdroji. Zároveň dve tretiny dát nesú pridaný šum vo viacerých úrovniach náročnosti, takže benchmark má byť zámerne bližšie reálnym hlučným podmienkam než testy založené iba na čistých nahrávkach.
Aké výsledky KInIT uvádza
KInIT tvrdí, že benchmark ukázal citeľný rozdiel medzi komerčnými a otvorenými systémami. V jeho vyhodnotení naprieč 22 modelmi dosiahol najsilnejší komerčný systém 10,8 % word error rate, zatiaľ čo najlepší open-weight model dostupný bez ďalšieho doladenia 17,5 %. Zdroj to interpretuje ako rozdiel takmer siedmich bodov pri rovnakých dátach a rovnakom skórovaní. Keďže ide o vlastné meranie autorov, je vhodné tieto čísla čítať ako zdokumentované výsledky KInIT, nie ako nezávisle potvrdené poradie celého trhu.
Čo prinieslo doladenie na slovenčine
Podľa KInIT sa zásadná zmena ukázala po doladení modelov na slovenských dátach. Inštitút píše, že v prvej vlne fine-tuning experimentov klesla chybovosť približne na polovicu vo všetkých architektúrach, ktoré skúšal, a že to stačilo aj na preskupenie poradia v rebríčku. Prvé verzie týchto doladených modelov sú podľa zdroja zverejnené na Hugging Face a uvedené v katalógu SLAIH. KInIT zároveň vysvetľuje, že vybral architektúry Whisper, Nvidia Canary a Nvidia Parakeet, teda modely, ktoré už pred doladením slovenčinu aspoň rozumne podporovali.
Hlavné limity dnešných verzií
Zdroj zároveň presne menuje dve hlavné obmedzenia. Prvým je dátová rozmanitosť: tréningové dáta sú podľa KInIT ovládané malým počtom domén, hlavne parlamentnou rečou, takže najlepšie zisky sa prirodzene objavujú tam, kde sú dáta dobre zastúpené. Druhým je zabúdanie iných jazykov: plný fine-tuning na slovenčine zhoršuje výkon v ďalších jazykoch, ktoré základný model pôvodne zvládal. KInIT dodáva, že LoRA doladenie takmer odstraňuje degradáciu v angličtine, ale zatiaľ nedosahuje rovnaké slovenské zisky ako plný fine-tuning. Pri reálnej slovenskej reči, kde sa často mieša angličtina, je to podstatná praktická hranica.
Čo má nasledovať
Ďalší krok je zatiaľ plán, nie hotový výsledok. KInIT uvádza, že od tréningu aktuálnych modelov nazbieral výrazne viac slovenského audia z domén a podmienok, ktoré doterajší tréning nepokrýval, a že weak-labeling pipeline má rozšíriť využiteľné dáta aj na nahrávky, ktoré si nemôže dovoliť ručne prepísať. Nasledujúca vlna modelov má byť podľa zdroja natrénovaná práve na týchto rozšírených dátach a zverejnená rovnakým spôsobom.
Zdroje
Súvisiace
Ďalšie články k téme
KInIT tvrdí, že slovenské dáta vedia výrazne zlepšiť prepis reči
Na SLAIH je podľa oznámenia dostupný prvý špecializovaný benchmark rozpoznávania reči pre slovenčinu. KInIT zároveň uvádza, že pri doladení otvorených modelov na slovenských dátach klesla chybovosť približne na polovicu, no dnešné verzie majú aj jasné limity v pokrytí domén a vo viacjazyčnom použití.
KInIT opísal benchmark slovenských speech-to-text modelov pre Slovak Telekom
KInIT uvádza, že pre Slovak Telekom pripravil nezávislý benchmark speech-to-text modelov pre slovenčinu so zameraním na telekomunikačnú doménu. Podľa zdroja porovnal viac než 20 modelov na 354 hodinách slovenského audia a hodnotil nielen celkovú presnosť prepisu, ale aj čísla, telco terminológiu a odolnosť voči šumu.
KInIT zhrnul výstupy projektu lorAI: od slovenského benchmarku sk-bench po PEFT-Bench
KInIT 26. októbra 2026 zverejnil stránku „Research powered by lorAI“, na ktorej sumarizuje publikácie podporené projektom lorAI a ďalšie práce s partnermi lorAI. Podľa KInIT záber týchto výstupov siaha od efektívnych LLM a fine-tuningu po auditing, benchmarking a human-centered AI; medzi konkrétnymi príkladmi uvádza aj slovenský benchmark sk-bench a benchmark PEFT-Bench pre parameter-efficient fine-tuning.
SLAIH upozorňuje na päť zdrojov pre slovenčinu v AI: od multimodálneho modelu po rečové a férovostné datasety
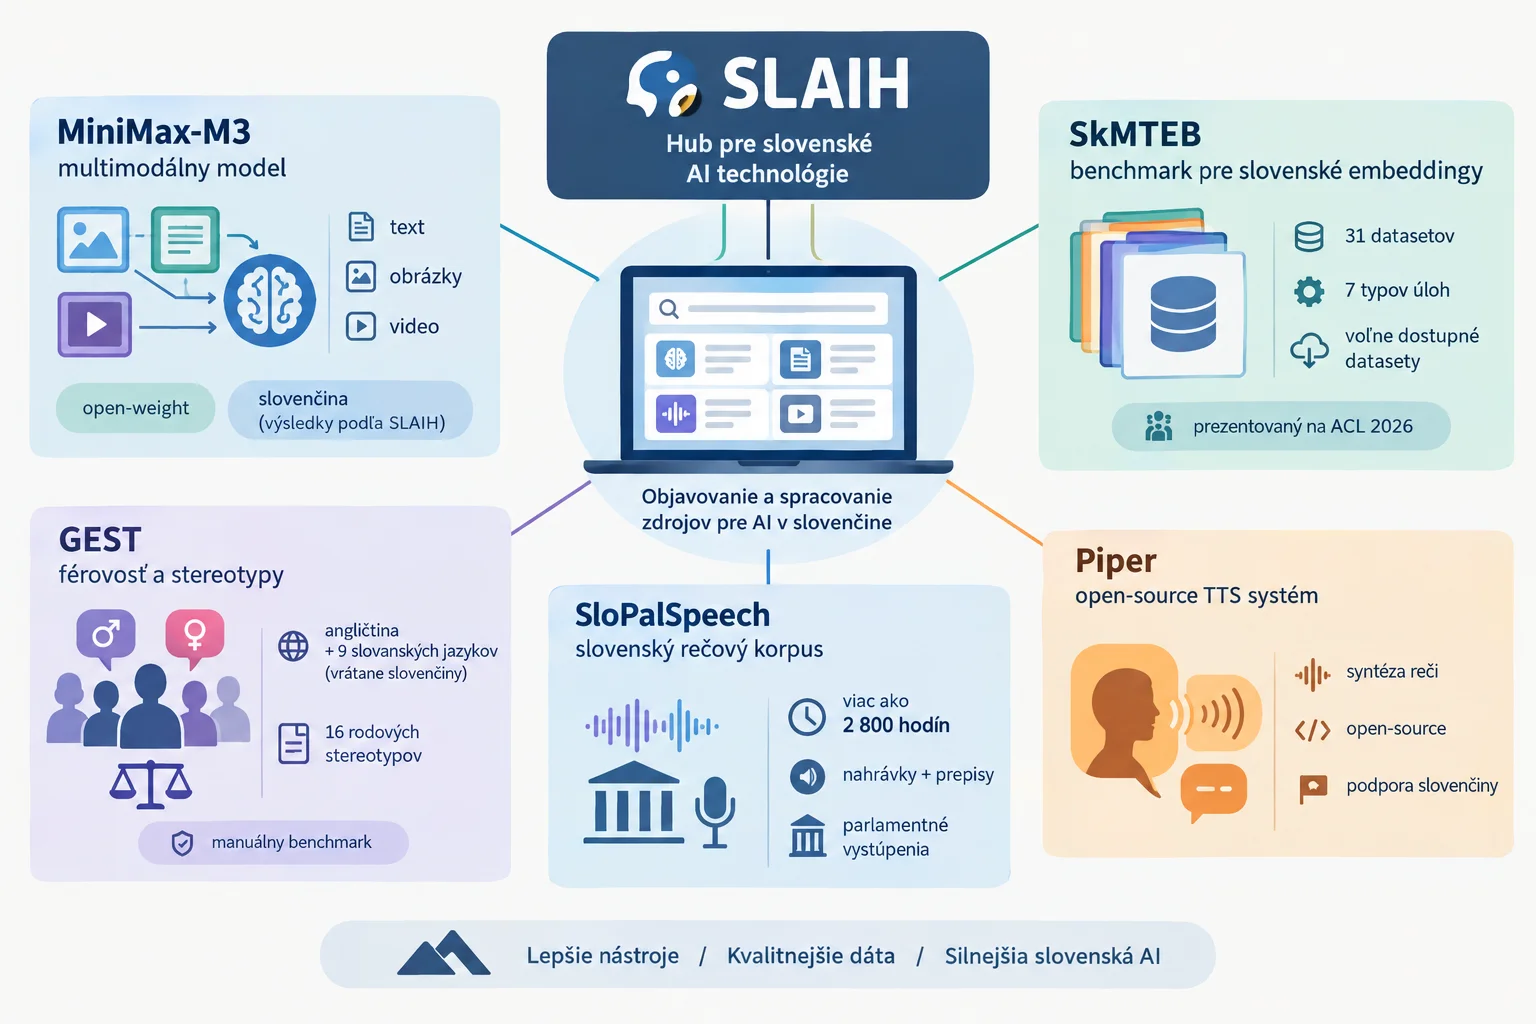
SLAIH vo svojom oznámení vyzdvihol päť prírastkov v katalógu pre slovenské jazykové technológie: multimodálny model MiniMax-M3, embeddingový benchmark SkMTEB, benchmark rodových stereotypov GEST, rečový korpus SloPalSpeech a open-source TTS systém Piper. Pri každej položke ide o opis a parametre, ktoré uvádza samotné SLAIH.