KInIT opísal benchmark slovenských speech-to-text modelov pre Slovak Telekom
KInIT uvádza, že pre Slovak Telekom pripravil nezávislý benchmark speech-to-text modelov pre slovenčinu so zameraním na telekomunikačnú doménu. Podľa zdroja porovnal viac než 20 modelov na 354 hodinách slovenského audia a hodnotil nielen celkovú presnosť prepisu, ale aj čísla, telco terminológiu a odolnosť voči šumu.
KInIT zverejnil opis projektu, v ktorom pre Slovak Telekom pripravil benchmark slovenských speech-to-text modelov so zameraním na telekomunikačnú doménu. Pointa je jednoduchá: pri slovenčine podľa zdroja doteraz chýbal spoločný benchmark, takže firmy sa pri výbere technológie nemohli opierať o porovnanie na rovnakých dátach.
Podľa KInIT benchmark stál na 354 hodinách slovenského audia s prepismi a zahŕňal viac než 20 modelov, komerčných aj open-weight. Nešlo pritom len o jednu všeobecnú metriku. Zdroj uvádza, že hodnotenie sledovalo aj to, ako modely prepisujú čísla, dátumy a identifikátory, ako rozpoznávajú telco pojmy a ako sa zhoršujú pri šume.
Praktický význam je v tom, že takýto benchmark má podľa KInIT a partnera slúžiť ako objektívny základ pri výbere technológie na analýzu zákazníckych hovorov. Dodaný podklad však neobsahuje tabuľku výsledkov, poradie modelov ani konkrétne skóre, preto z neho nemožno vyvodiť, ktorý systém vyšiel najlepšie.
KInIT zároveň opisuje aj možný ďalší krok: lacnejšie označovanie anonymizovaných nahrávok kombináciou viacerých silných modelov a ľudského overenia na vzorke. Takto pripravené dáta by sa podľa zdroja dali použiť na doladenie open-weight modelov pre telco prostredie a na testovanie celého reťazca od audia po analytické výstupy.
Podrobnosti a podklady
Čo je nové a aký problém mal benchmark riešiť
Primárny zdroj opisuje projekt s názvom „Slovak Speech-to-Text Model Benchmark“ pre partnera Slovak Telekom. KInIT jeho cieľ formuluje ako zaplnenie medzery v slovenčine: vytvoriť nezávislý benchmark speech-to-text modelov pre slovenský jazyk so špeciálnym dôrazom na telekomunikačnú doménu a dodať podklad pre výber vhodného riešenia. Z textu zároveň vyplýva, že problémom nebola iba samotná presnosť prepisu, ale absencia spoločného porovnania na rovnakých slovenských dátach.
Dáta a rozsah hodnotenia
KInIT uvádza, že zozbieral a kurátoroval 354 hodín slovenského audia s prepismi naprieč viacerými doménami. Zdroj menuje kombináciu verejných datasetov, dát dodaných Slovak Telekomom a nových datasetov vytvorených v KInIT vrátane zasadnutí mestských zastupiteľstiev, čítaných literárnych textov a skriptovaných dialógov call centra. Na týchto dátach podľa opisu vyhodnotili viac než 20 speech-to-text modelov, a to komerčné služby aj open-weight modely.
Ako benchmark meral prakticky dôležité vlastnosti
Mechanizmus hodnotenia bol viacvrstvový. Zdroj výslovne uvádza celkovú presnosť prepisu pre všeobecnú aj doménovo špecifickú slovenskú reč. Osobitne sledoval čísla, teda spoľahlivosť prepisu súm, dátumov a identifikátorov pomocou špecializovaných metrík na úrovni číslic. Ďalšia vrstva sa týkala telco terminológie, kde sa meralo rozpoznanie doménových výrazov cez precision a recall pre jednotlivé termíny. Štvrtá časť sa zamerala na odolnosť voči rušeniu: KInIT píše, že simuloval šesť typov skreslenia audia pri viacerých intenzitách a sledoval, ako sa modely degradujú.
Praktický význam podľa KInIT a partnera
Podľa KInIT hlavným výstupom projektu bol detailný benchmark report, ktorý má Slovak Telekomu poskytnúť objektívne porovnanie dostupných speech-to-text riešení pre slovenčinu. Zdroj to interpretuje ako prechod od výberu podľa dôvery k výberu podľa dôkazov. Rovnakú interpretáciu podporuje aj citácia zástupcu Slovak Telekomu, ktorý benchmark opisuje ako základ pre rozhodovanie o technológii na analýzu zákazníckych konverzácií a o ďalších investíciách. Ide však stále o tvrdenia zúčastnených strán, nie o nezávislé externé overenie.
Navrhované pokračovanie projektu
Text opisuje aj nadväzujúci návrh: proces označovania anonymizovaných nahrávok call centra kombináciou viacerých silných modelov a ľudského overenia na vzorke. KInIT tvrdí, že takto možno získať interné doménové dáta za zlomok ceny ručného prepisu. Takéto dáta by sa potom dali použiť na doladenie open-weight modelov pre telco doménu a na end-to-end hodnotenie celého analytického pipeline od audia po výsledné poznatky.
Hranice toho, čo sa dá z podkladu potvrdiť
Dodaný podklad neobsahuje výsledkové tabuľky, konkrétne skóre ani poradie modelov. Z článku preto nemožno zistiť, ktorý speech-to-text systém dopadol najlepšie, aké boli rozdiely medzi modelmi ani aké kompromisy vznikli medzi všeobecnou presnosťou, číslami, terminológiou a šumom. Rovnako tu nie je verejný reprodukovateľný dataset ani nezávislé testovanie. Najpresnejšie je preto tento materiál čítať ako zdokumentovaný opis benchmarku a jeho metodiky, nie ako verejné finálne poradie modelov.
Zdroje
Súvisiace
Ďalšie články k téme
KInIT: pri slovenskom rozpoznávaní reči je problém skôr v dátach než v modeloch
KInIT 22. októbra 2026 uviedol, že zverejnil 39-hodinový slovenský ASR benchmark na SLAIH a prvé doladené otvorené modely. Podľa jeho výsledkov dosiahol na rovnakých dátach najsilnejší komerčný systém 10,8 % word error rate a najlepší bežne dostupný open-weight model 17,5 %, pričom po doladení na slovenčine chybovosť v skúšaných architektúrach klesla približne na polovicu. Inštitút zároveň upozorňuje na dve hranice: úzku dátovú rozmanitosť a zhoršenie výkonu v iných jazykoch po plnom fine-tuningu.
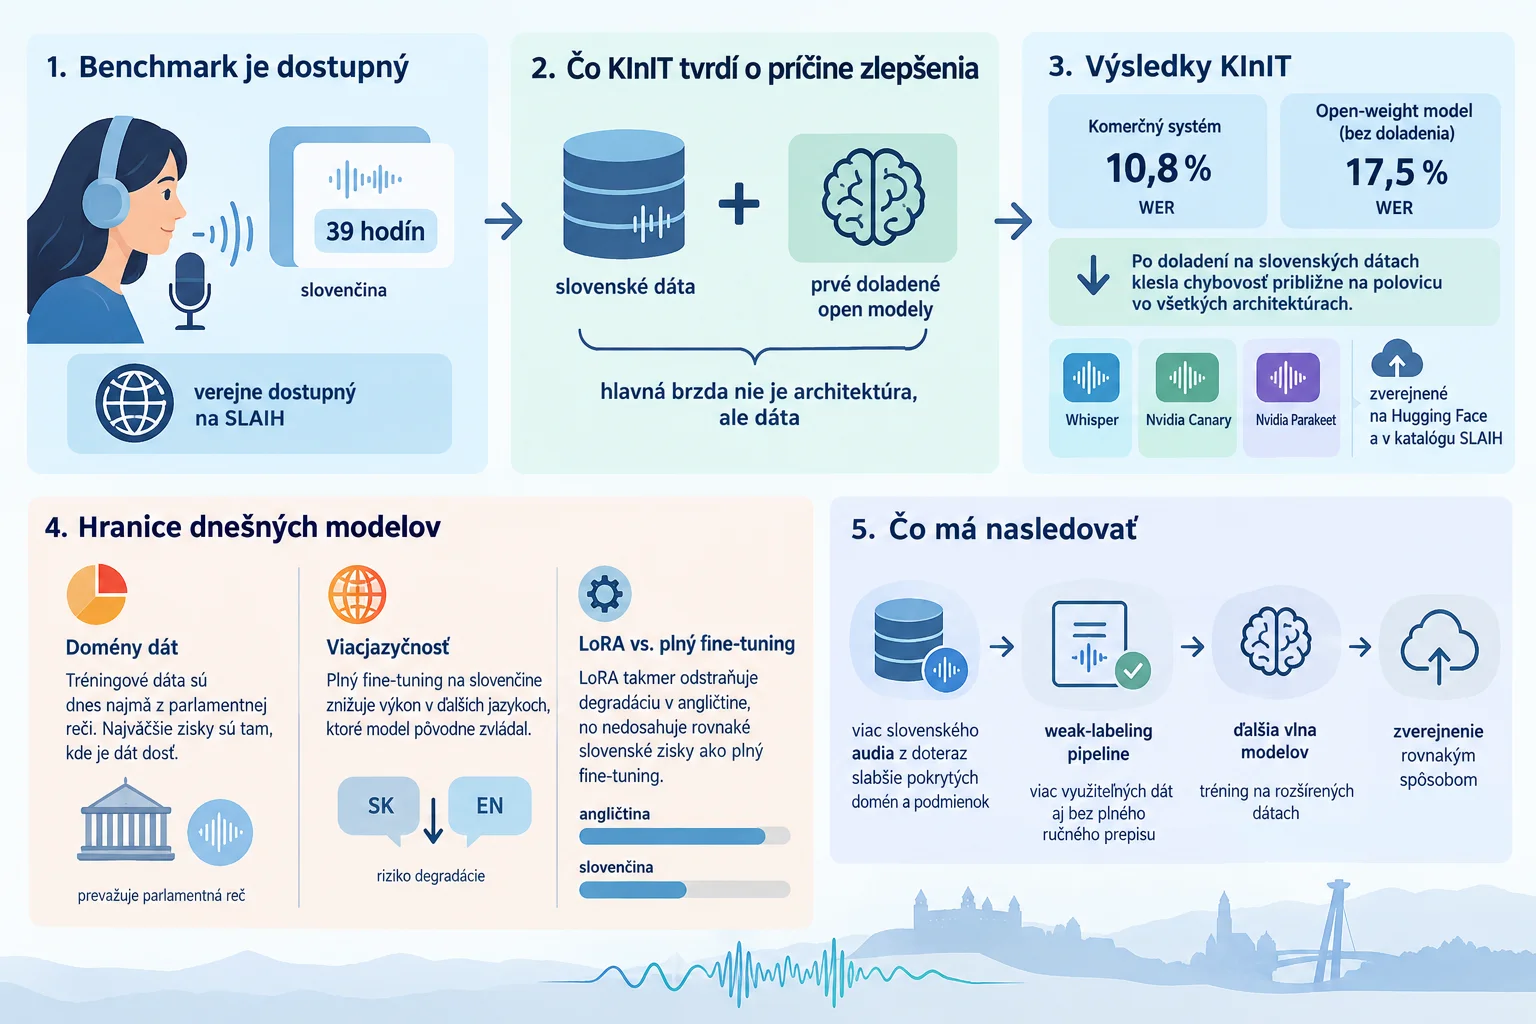
KInIT tvrdí, že slovenské dáta vedia výrazne zlepšiť prepis reči
Na SLAIH je podľa oznámenia dostupný prvý špecializovaný benchmark rozpoznávania reči pre slovenčinu. KInIT zároveň uvádza, že pri doladení otvorených modelov na slovenských dátach klesla chybovosť približne na polovicu, no dnešné verzie majú aj jasné limity v pokrytí domén a vo viacjazyčnom použití.
KInIT zhrnul výstupy projektu lorAI: od slovenského benchmarku sk-bench po PEFT-Bench
KInIT 26. októbra 2026 zverejnil stránku „Research powered by lorAI“, na ktorej sumarizuje publikácie podporené projektom lorAI a ďalšie práce s partnermi lorAI. Podľa KInIT záber týchto výstupov siaha od efektívnych LLM a fine-tuningu po auditing, benchmarking a human-centered AI; medzi konkrétnymi príkladmi uvádza aj slovenský benchmark sk-bench a benchmark PEFT-Bench pre parameter-efficient fine-tuning.
KInIT opísal prototyp sémantického vyhľadávania pre SVOP na Slovensku
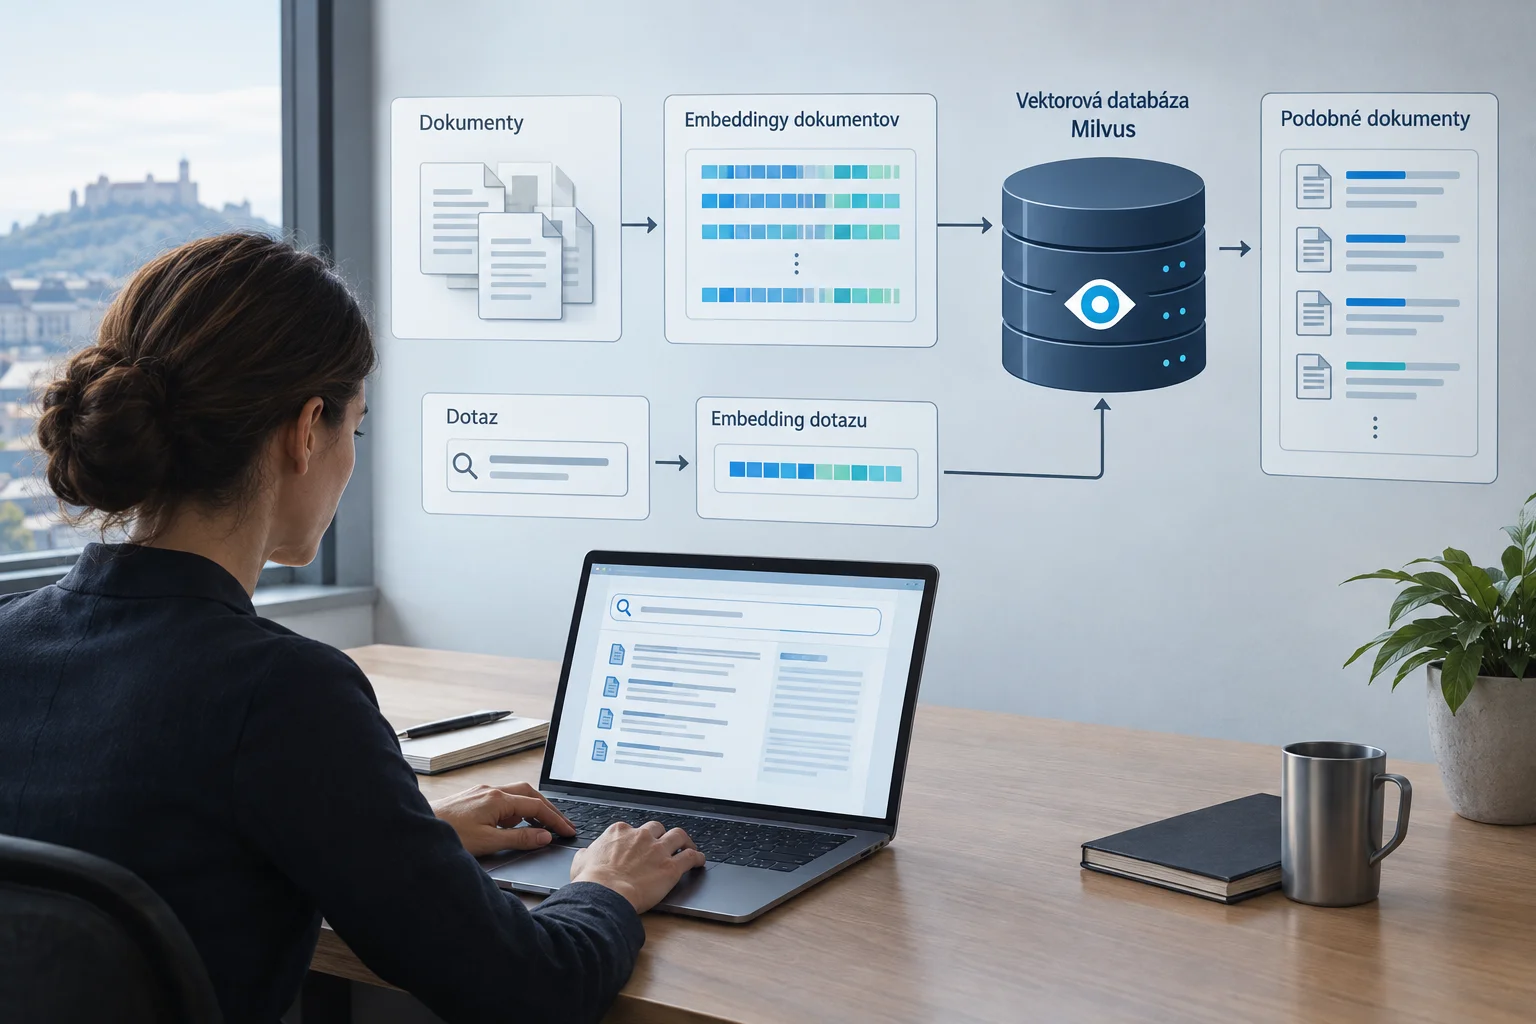
Kempelen Institute of Intelligent Technologies zverejnil opis trojmesačného projektu pre partnera SVOP, v ktorom nahradil čisto slovné fulltextové vyhľadávanie prototypom sémantického vyhľadávania. Podklad ukazuje konkrétnu architektúru s embeddingmi dokumentov, vektorovou databázou Milvus a prevodom dotazu do rovnakého vektorového priestoru, no bez zverejnených metrík presnosti či latencie.