KInIT tvrdí, že slovenské dáta vedia výrazne zlepšiť prepis reči
Na SLAIH je podľa oznámenia dostupný prvý špecializovaný benchmark rozpoznávania reči pre slovenčinu. KInIT zároveň uvádza, že pri doladení otvorených modelov na slovenských dátach klesla chybovosť približne na polovicu, no dnešné verzie majú aj jasné limity v pokrytí domén a vo viacjazyčnom použití.
Slovenské rozpoznávanie reči dostalo nový verejný referenčný bod. Na SLAIH je podľa oznámenia dostupný prvý špecializovaný benchmark automatického rozpoznávania reči pre slovenčinu a KInIT k nemu pridal aj prvé doladené otvorené modely pre slovenské použitie. Praktický odkaz je jednoduchý: pri slovenčine sa už nemusí hovoriť len všeobecne o tom, ktorý systém „asi funguje“, ale dá sa porovnávať na spoločnom základe.
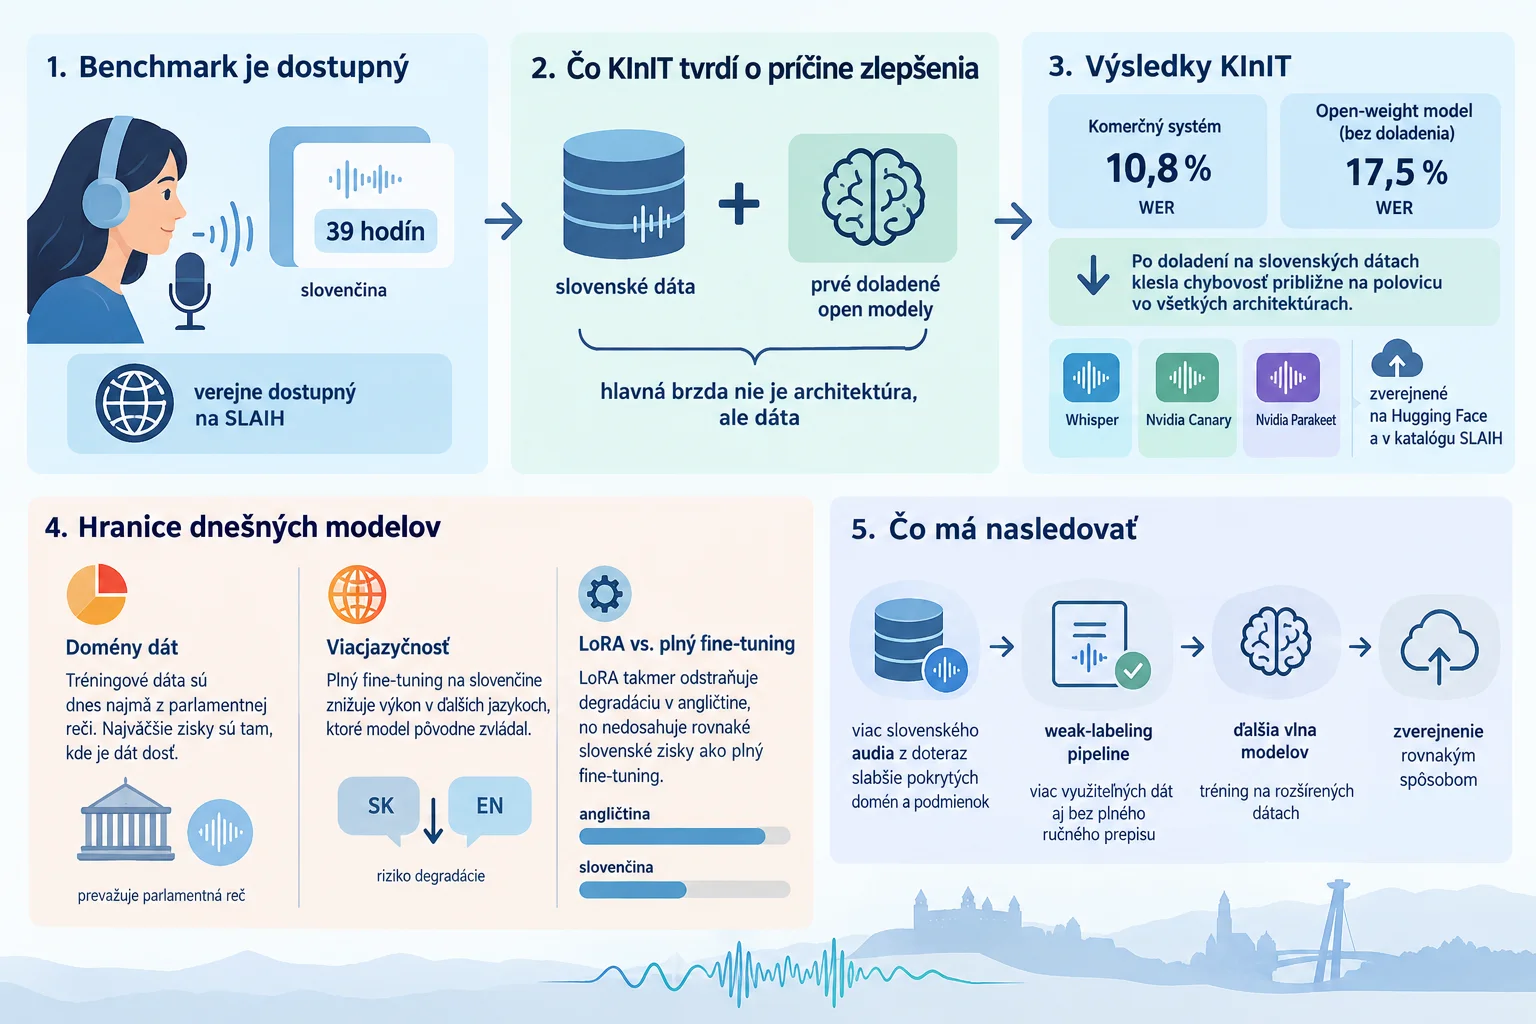
Najsilnejšie tvrdenie KInIT nie je o novej architektúre, ale o dátach. Inštitút uvádza, že na jeho benchmarku mal najsilnejší komerčný systém 10,8 % word error rate, kým najlepší bežne dostupný open-weight model bez ďalšieho doladenia 17,5 %. Po doladení na slovenských dátach vraj chybovosť v skúšaných architektúrach klesla približne na polovicu. To naznačuje, že pri slovenčine môže byť rozhodujúce skôr kvalitné doménové dáta než úplne nový model.
Nie je to však hotové riešenie pre každý scenár. KInIT zároveň upozorňuje, že tréningové dáta sú zatiaľ silno naklonené niekoľkým doménam, najmä parlamentnej reči, a plný fine-tuning na slovenčine zhoršuje výkon v iných jazykoch. To je dôležité najmä tam, kde sa v praxi mieša slovenčina s angličtinou. Ďalšia vlna modelov má preto podľa plánu využiť viac slovenského audia aj weak-labeling pipeline.
Podrobnosti a podklady
Čo je nové
SLAIH vo svojom prehľade noviniek uvádza položku „Prvý benchmark rozpoznávania reči pre slovenčinu je dostupný na SLAIH“ a dopĺňa, že ide o „prvý špecializovaný benchmark automatického rozpoznávania reči pre slovenčinu“. To je najpevnejšie doložená časť novinky: benchmark bol oznámený ako verejne dostupný zdroj pre slovenské speech-to-text hodnotenie.
Čo KInIT tvrdí o príčine zlepšenia
Podľa KInIT je jadrom nového vydania 39-hodinový benchmark pre slovenčinu na SLAIH a zároveň prvé doladené otvorené modely. KInIT tento krok interpretuje tak, že hlavnou brzdou slovenského rozpoznávania reči nie sú nevyhnutne nové architektúry, ale skôr vhodné dáta. Keďže ide o tvrdenia autora projektu, treba ich čítať ako zdokumentované vyjadrenia KInIT, nie ako nezávisle potvrdený stav celého trhu.
Aké výsledky KInIT uvádza
KInIT vo vlastnom vyhodnotení naprieč 22 modelmi uvádza, že najsilnejší komerčný systém dosiahol 10,8 % word error rate a najlepší open-weight model bez ďalšieho doladenia 17,5 %. Zároveň píše, že po doladení na slovenských dátach klesla chybovosť približne na polovicu vo všetkých skúšaných architektúrach a že prvé verzie týchto modelov zverejnil na Hugging Face a uviedol v katalógu SLAIH. Spomenuté sú architektúry Whisper, Nvidia Canary a Nvidia Parakeet. Tieto čísla a závery však pochádzajú z merania KInIT, nie z externého nezávislého benchmarku tretej strany.
Hranice dnešných modelov
Dôležitou časťou príbehu sú obmedzenia. KInIT uvádza, že tréningové dáta sú dnes ovládané malým počtom domén, najmä parlamentnou rečou, takže najväčšie zisky sa prirodzene prejavia tam, kde je dát dosť. Druhý limit je viacjazyčnosť: plný fine-tuning na slovenčine zhoršuje výkon v ďalších jazykoch, ktoré pôvodný model zvládal. KInIT dodáva, že LoRA doladenie takmer odstraňuje degradáciu v angličtine, no zatiaľ nedosahuje rovnaké slovenské zisky ako plný fine-tuning. To je prakticky podstatné v scenároch, kde sa v jednej nahrávke mieša slovenčina s angličtinou.
Čo má nasledovať
Ďalší krok je zatiaľ plán. KInIT píše, že od tréningu aktuálnych modelov nazbieral viac slovenského audia z doteraz slabšie pokrytých domén a podmienok a že weak-labeling pipeline má rozšíriť množstvo využiteľných dát aj bez plného ručného prepisu. Nasledujúca vlna modelov má byť podľa tohto plánu natrénovaná na rozšírených dátach a zverejnená rovnakým spôsobom.
Zdroje
Súvisiace
Ďalšie články k téme
KInIT: pri slovenskom rozpoznávaní reči je problém skôr v dátach než v modeloch
KInIT 22. októbra 2026 uviedol, že zverejnil 39-hodinový slovenský ASR benchmark na SLAIH a prvé doladené otvorené modely. Podľa jeho výsledkov dosiahol na rovnakých dátach najsilnejší komerčný systém 10,8 % word error rate a najlepší bežne dostupný open-weight model 17,5 %, pričom po doladení na slovenčine chybovosť v skúšaných architektúrach klesla približne na polovicu. Inštitút zároveň upozorňuje na dve hranice: úzku dátovú rozmanitosť a zhoršenie výkonu v iných jazykoch po plnom fine-tuningu.
KInIT opísal benchmark slovenských speech-to-text modelov pre Slovak Telekom
KInIT uvádza, že pre Slovak Telekom pripravil nezávislý benchmark speech-to-text modelov pre slovenčinu so zameraním na telekomunikačnú doménu. Podľa zdroja porovnal viac než 20 modelov na 354 hodinách slovenského audia a hodnotil nielen celkovú presnosť prepisu, ale aj čísla, telco terminológiu a odolnosť voči šumu.
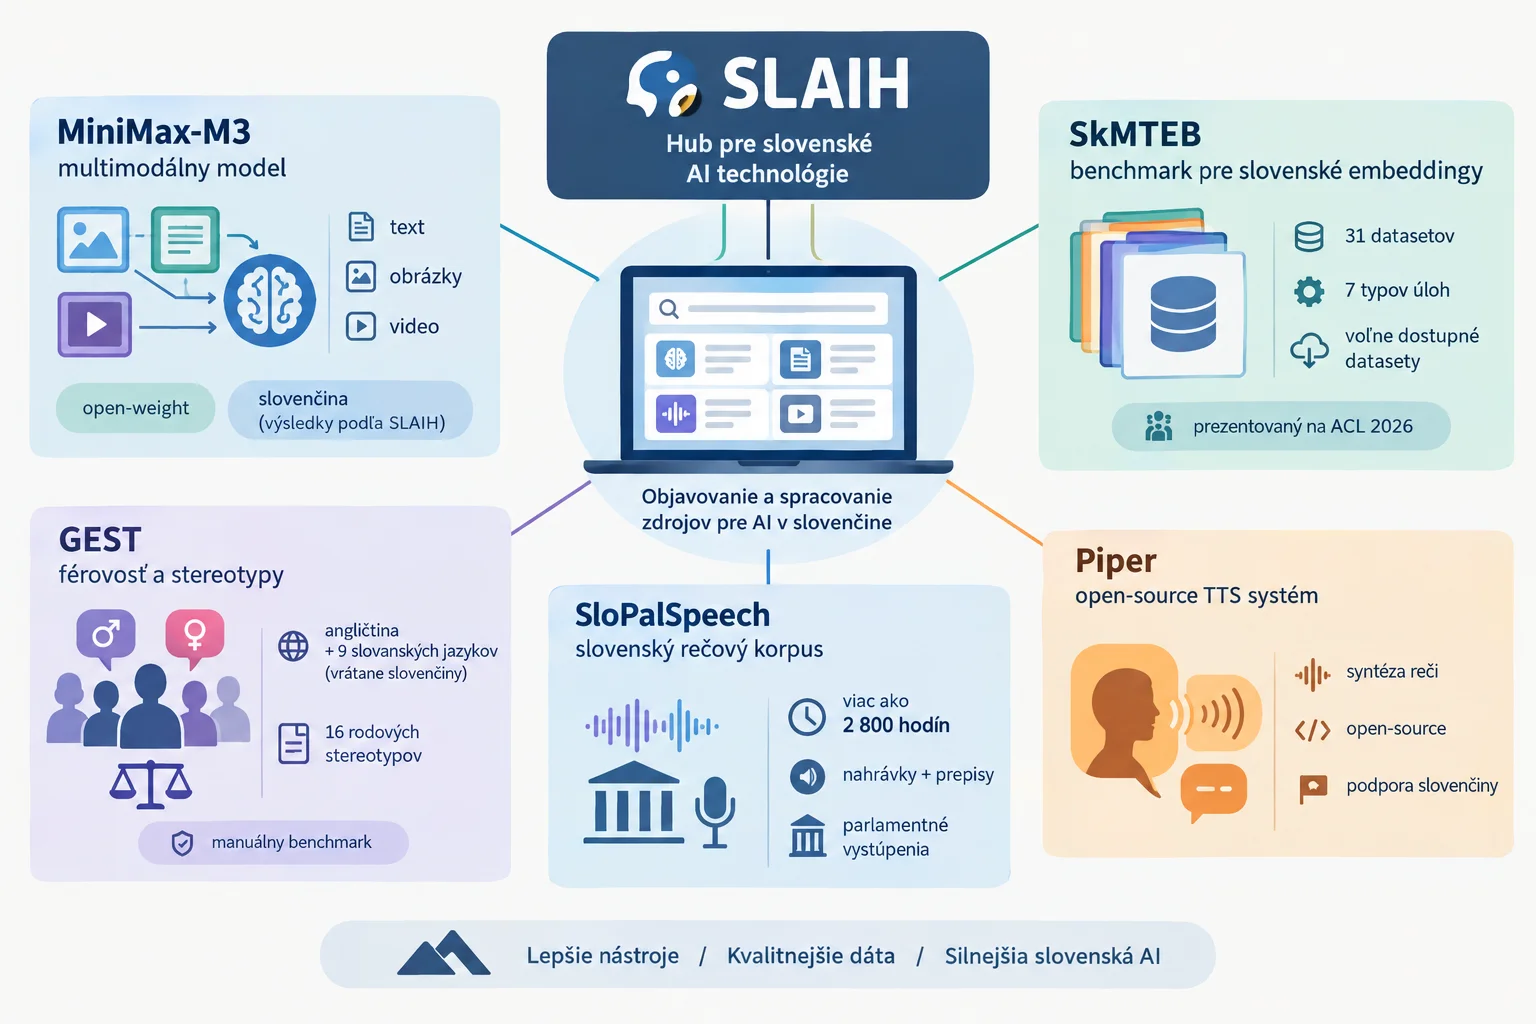
SLAIH upozorňuje na päť zdrojov pre slovenčinu v AI: od multimodálneho modelu po rečové a férovostné datasety
SLAIH vo svojom oznámení vyzdvihol päť prírastkov v katalógu pre slovenské jazykové technológie: multimodálny model MiniMax-M3, embeddingový benchmark SkMTEB, benchmark rodových stereotypov GEST, rečový korpus SloPalSpeech a open-source TTS systém Piper. Pri každej položke ide o opis a parametre, ktoré uvádza samotné SLAIH.
KInIT zhrnul výstupy projektu lorAI: od slovenského benchmarku sk-bench po PEFT-Bench
KInIT 26. októbra 2026 zverejnil stránku „Research powered by lorAI“, na ktorej sumarizuje publikácie podporené projektom lorAI a ďalšie práce s partnermi lorAI. Podľa KInIT záber týchto výstupov siaha od efektívnych LLM a fine-tuningu po auditing, benchmarking a human-centered AI; medzi konkrétnymi príkladmi uvádza aj slovenský benchmark sk-bench a benchmark PEFT-Bench pre parameter-efficient fine-tuning.