SLAIH upozorňuje na päť zdrojov pre slovenčinu v AI: od multimodálneho modelu po rečové a férovostné datasety
SLAIH vo svojom oznámení vyzdvihol päť prírastkov v katalógu pre slovenské jazykové technológie: multimodálny model MiniMax-M3, embeddingový benchmark SkMTEB, benchmark rodových stereotypov GEST, rečový korpus SloPalSpeech a open-source TTS systém Piper. Pri každej položke ide o opis a parametre, ktoré uvádza samotné SLAIH.
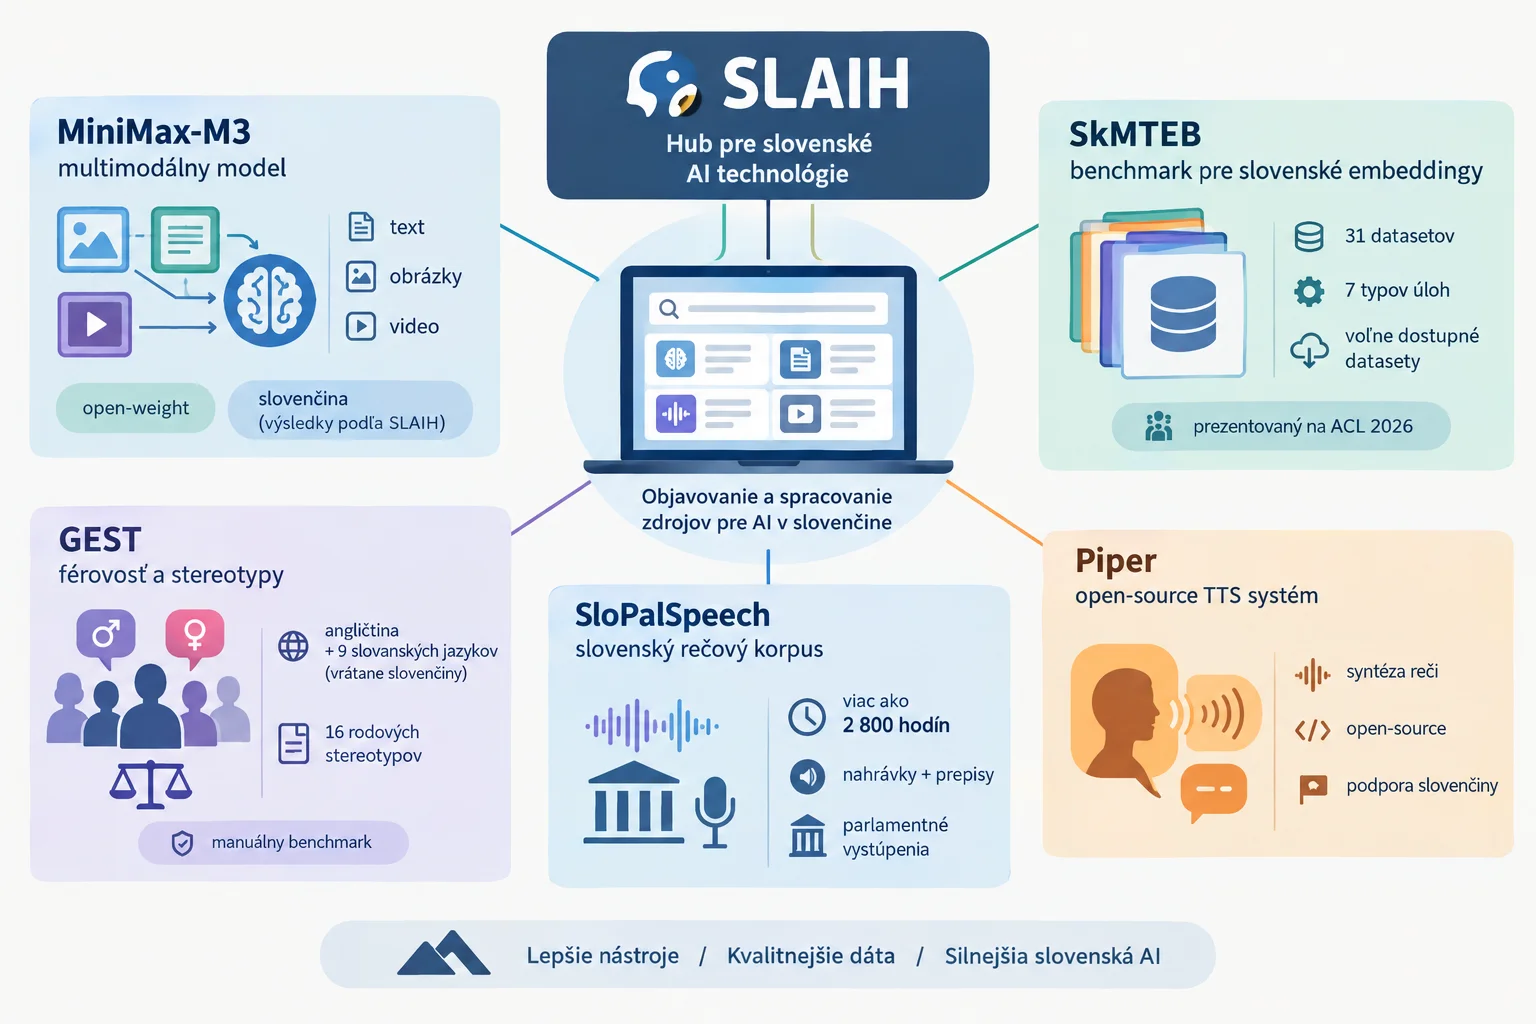
SLAIH zverejnil oznámenie, v ktorom upozorňuje na päť zdrojov zo svojho katalógu pre umelú inteligenciu a spracovanie prirodzeného jazyka v slovenčine. Výber pokrýva viacero praktických oblastí naraz: multimodálne modely, textové embeddingy, hodnotenie stereotypov, rozpoznávanie reči aj syntézu reči. Nejde teda o jednu novinku, ale skôr o stručný orientačný prehľad toho, čo môže byť užitočné pre vývojárov a výskumníkov pracujúcich so slovenčinou.
Najširšie záberom pôsobí MiniMax-M3. SLAIH ho opisuje ako multimodálny foundation model pre text, obrázky aj video, sprístupnený ako open-weight riešenie na nekomerčné využitie. Zároveň dodáva, že podľa prvých hodnotení dosahuje veľmi dobré výsledky aj na slovenčine, čo z neho robí zaujímavú alternatívu najmä pre tých, ktorí skúšajú viacjazyčných asistentov alebo prácu s dokumentmi.
Silná časť prehľadu sa týka dát a hodnotenia modelov. SkMTEB je podľa SLAIH prvý komplexný benchmark pre slovenské textové embeddingy, ktorý hodnotí modely na 31 datasetoch v siedmich typoch úloh, pričom samotné datasety sú voľne dostupné. GEST zase cieli na inú otázku: sleduje rodové stereotypy v jazykových modeloch a strojovom preklade naprieč angličtinou a deviatimi slovanskými jazykmi vrátane slovenčiny.
Pri hlasových technológiách SLAIH vyzdvihuje dva odlišné stavebné kamene. SloPalSpeech opisuje ako veľký slovenský rečový korpus z parlamentných vystúpení s viac ako 2 800 hodinami synchronizovaných nahrávok a prepisov. Piper naopak predstavuje hotovejší nástroj: open-source systém na syntézu reči, ktorý podporuje slovenčinu, vie bežať lokálne a hodí sa tam, kde záleží na súkromí, nízkej latencii alebo offline prevádzke.
Hranica tohto prehľadu je dôležitá: vlastnosti, rozsah aj praktické prínosy jednotlivých položiek vychádzajú z oznámenia SLAIH. Článok preto čítajme ako užitočný rozcestník k zdrojom pre slovenské AI a NLP, nie ako nezávislé porovnanie ich výkonu alebo kvality.
Podrobnosti a podklady
Čo presne bolo oznámené
Základ správy je jednoduchý: SLAIH publikoval text, ktorého cieľom je predstaviť „niekoľko nových prírastkov do nášho katalógu, ktoré stoja za pozornosť“. Samotný zdroj zároveň vysvetľuje širší zámer hubu ako miesta, ktoré má uľahčiť objavovanie kvalitných zdrojov pre AI a spracovanie prirodzeného jazyka v slovenčine. Oproti skoršiemu uvedeniu SLAIH ako centrálneho hubu ide v tomto prípade o tematický prehľad konkrétnych položiek z katalógu, nie o nové technické vyhodnotenie alebo samostatné vydanie jedného modelu či datasetu.
MiniMax-M3: multimodálny model, ale len v rámci opisu SLAIH
MiniMax-M3 SLAIH opisuje ako „moderný multimodálny foundation model schopný pracovať s textom, obrázkami aj videom“. Zdroj tiež tvrdí, že model bol sprístupnený ako „open-weight riešenie na nekomerčné využitie“ a že podľa prvých hodnotení „dosahuje veľmi dobré výsledky aj na slovenčine“. To sú podstatné parametre pre čitateľa, ale zároveň ide o zdrojovo pripísané tvrdenia SLAIH; z dodaných podkladov nevyplývajú nezávislé merania ani detail benchmarku, z ktorého by bolo možné tieto schopnosti overiť.
SkMTEB: benchmark aj voľne dostupné datasety
SkMTEB je v oznámení predstavený ako „prvý komplexný benchmark pre slovenské textové embeddingy“ a SLAIH uvádza, že bol „odprezentovaný na ACL 2026“. Najkonkrétnejší technický údaj je rozsah benchmarku: „31 datasetoch pokrývajúcich sedem rôznych typov úloh“. Pre praktické použitie je dôležitá aj ďalšia veta zo zdroja: „samotné datasety sú voľne dostupné“. To znamená, že hodnota položky nespočíva iba v rebríčku modelov, ale aj v tom, že vývojári môžu použiť pripravené slovenské evaluačné dáta bez budovania vlastnej sady od nuly.
GEST: férovosť a stereotypy namiesto hrubého výkonu
GEST sa v texte odlišuje tým, že nerieši primárne výkon, ale skreslenia modelov. SLAIH ho označuje za „manuálne vytvorený benchmark určený na hodnotenie rodových stereotypov v jazykových modeloch a systémoch strojového prekladu“. Rozsah je pomerne jasne ohraničený: angličtina a deväť slovanských jazykov vrátane slovenčiny, pričom dataset obsahuje príklady pre „16 bežných rodových stereotypov“. Pre redakčné spracovanie je podstatné držať sa tejto formulácie a nepripisovať benchmarku výsledky, ktoré v dodanom podklade nie sú.
SloPalSpeech a Piper: dáta pre ASR, nástroj pre TTS
Pri reči sú v oznámení dve rozdielne vrstvy infraštruktúry. SloPalSpeech je podľa SLAIH „rozsiahly slovenský rečový korpus vytvorený z nahrávok parlamentných vystúpení“ a obsahuje „viac ako 2 800 hodín synchronizovaných zvukových nahrávok a prepisov“. Tento opis zapadá aj do širšieho kontextu predchádzajúceho archívneho článku o slovenskom ASR, ktorý upozorňoval na význam dát pre rozpoznávanie reči. Piper je na druhej strane opísaný ako „open-source systém na syntézu reči“ s podporou slovenčiny a desiatok ďalších jazykov; SLAIH pri ňom zdôrazňuje lokálny beh, nízke hardvérové nároky a vhodnosť pre súkromie citlivé alebo offline scenáre.
Metodická hranica článku
Najväčším obmedzením tejto správy je povaha zdroja. Všetkých päť položiek je predstavených v jednom oznámení SLAIH a pri viacerých z nich ide o opis schopností, využitia alebo významu bez nezávislého potvrdenia v dodaných podkladoch. Preto je férové rozlišovať medzi zdokumentovaným faktom, že SLAIH tieto zdroje vyzdvihol vo svojom katalógu, a medzi širšími závermi o ich výkone či trhovom význame, ktoré by si vyžadovali ďalšie externé zdroje.
Zdroje
Súvisiace
Ďalšie články k téme
SLAIH spustil centrálny hub pre slovenské datasety, modely a benchmarky
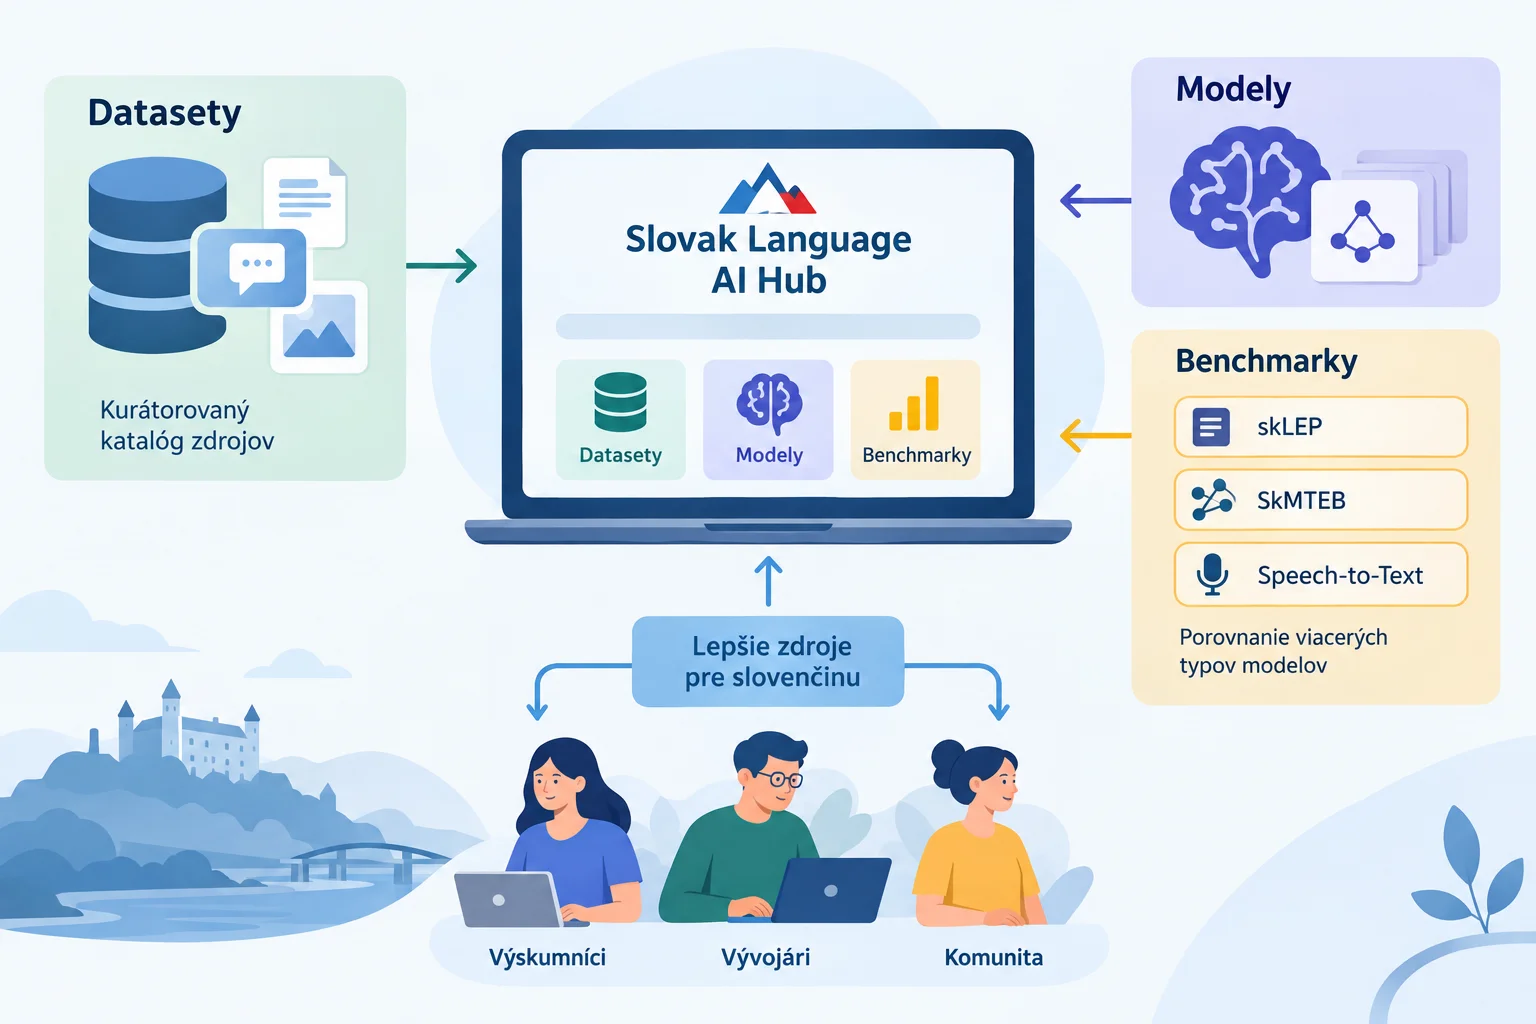
Slovak Language AI Hub podľa svojho oznámenia spustil centrálne miesto pre datasety, modely a benchmarky pre slovenčinu. V prvej verzii uvádza kurátorovaný katalóg zdrojov a výsledky troch benchmarkov: skLEP, SkMTEB a Speech-to-Text.
SLAIH: pri slovenskom prepise reči nestačí jedno číslo z rebríčka
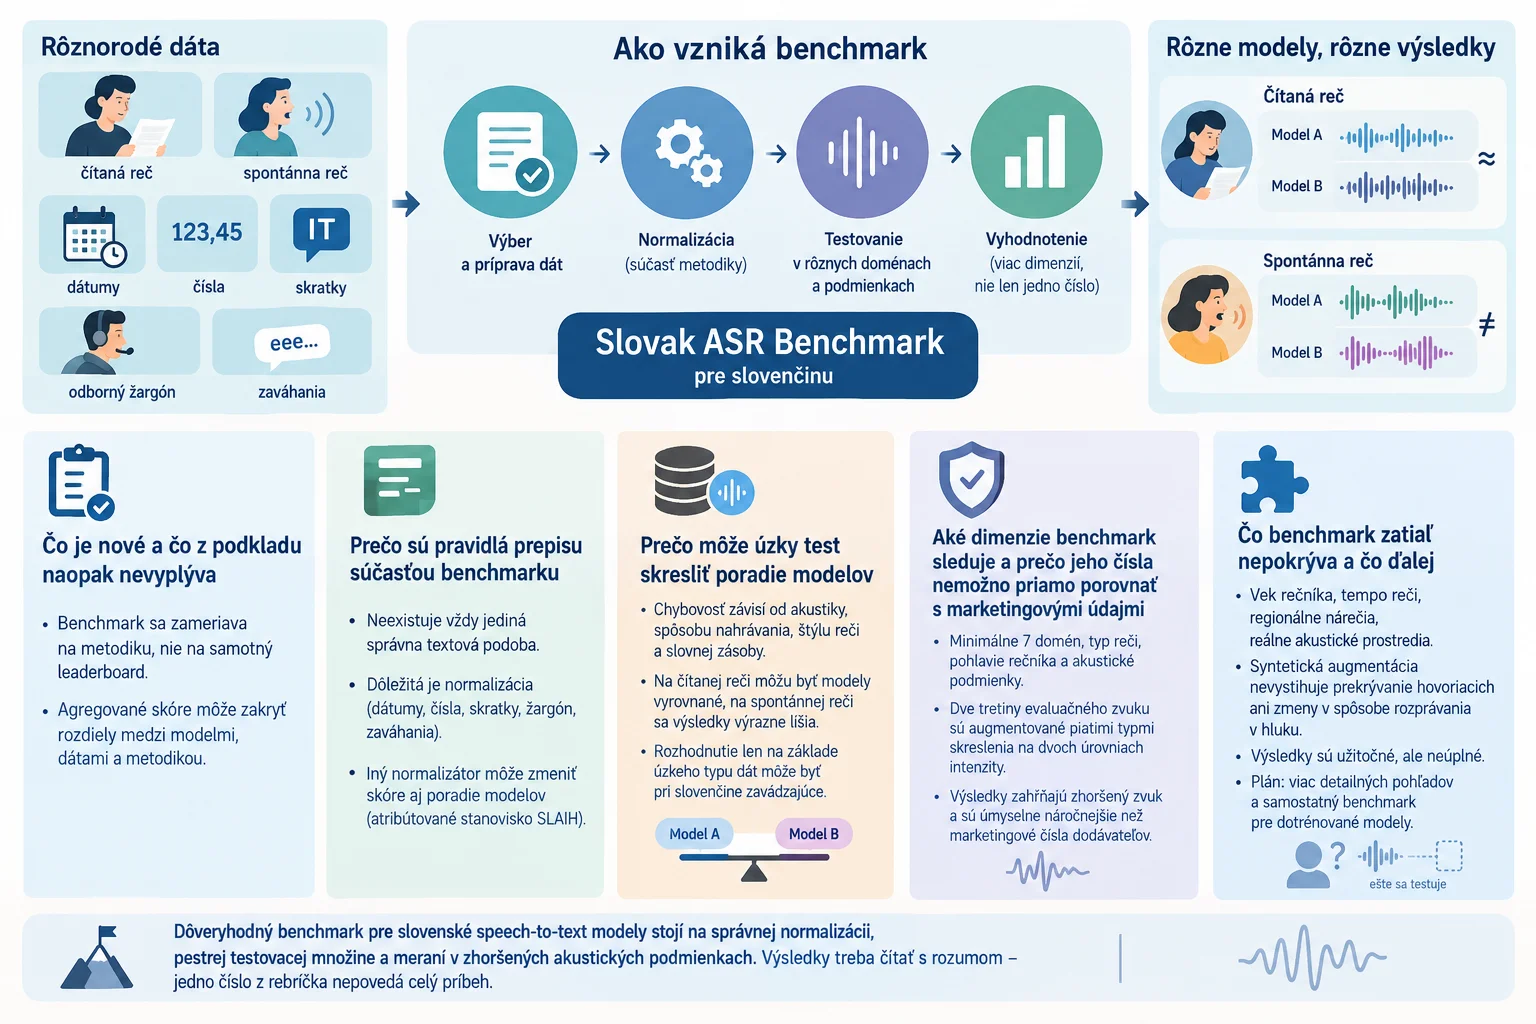
SLAIH opisuje, že dôveryhodný benchmark pre slovenské speech-to-text modely stojí na voľbe normalizácie, pestrej testovacej množine a meraní v zhoršených akustických podmienkach. Organizácia zároveň upozorňuje, že agregované skóre môže zakryť veľké rozdiely medzi čítanou a spontánnou rečou a že dnešný benchmark má aj jasne pomenované obmedzenia.
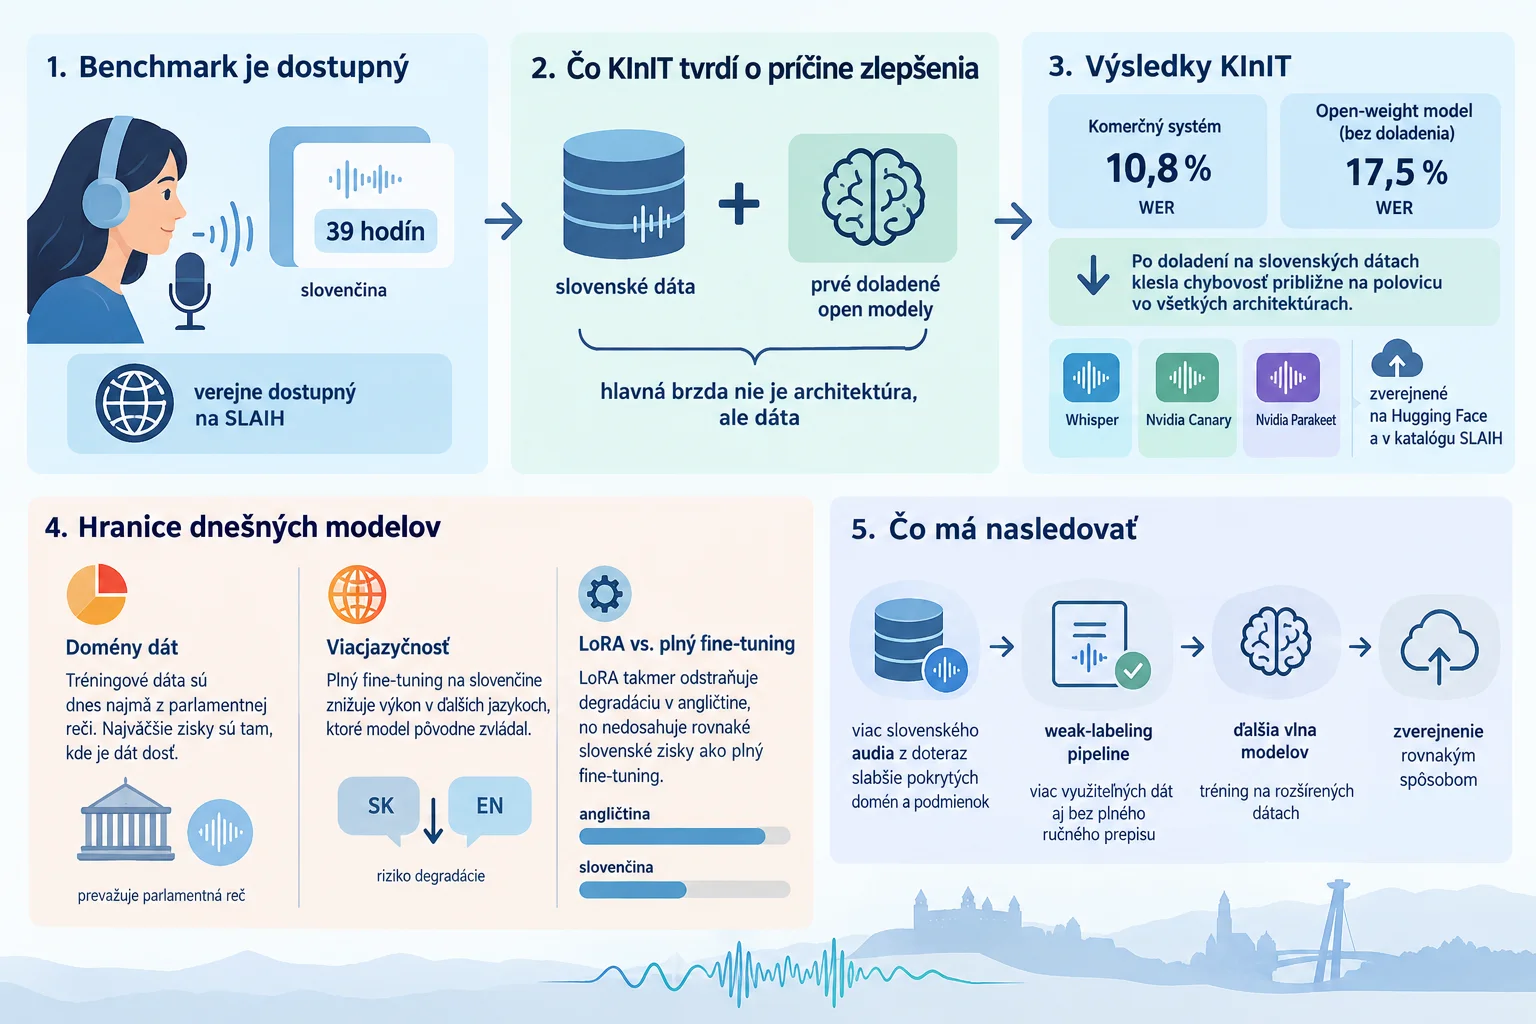
KInIT tvrdí, že slovenské dáta vedia výrazne zlepšiť prepis reči
Na SLAIH je podľa oznámenia dostupný prvý špecializovaný benchmark rozpoznávania reči pre slovenčinu. KInIT zároveň uvádza, že pri doladení otvorených modelov na slovenských dátach klesla chybovosť približne na polovicu, no dnešné verzie majú aj jasné limity v pokrytí domén a vo viacjazyčnom použití.
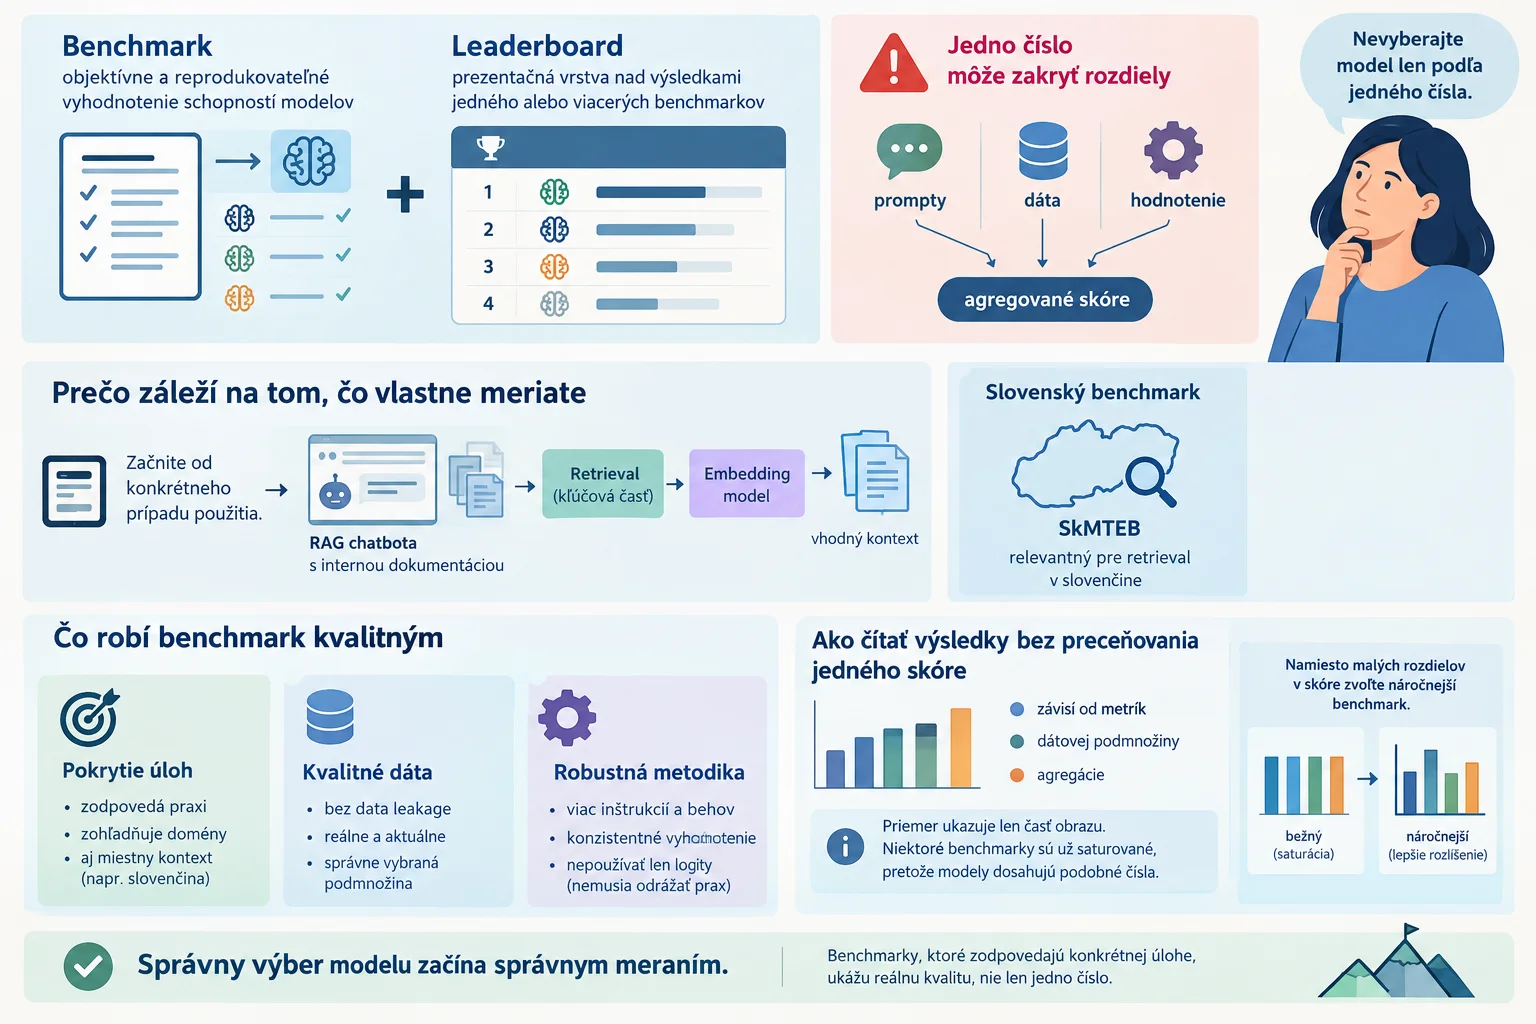
Jedno číslo z AI rebríčka nestačí: SLAIH vysvetľuje, ako čítať benchmarky
SLAIH upozorňuje, že jedno agregované skóre z leaderboardu môže pri výbere AI modelu skryť rozdiely v metodike, dátach aj schopnostiach. Pri praktickom nasadení preto odporúča pozerať sa na benchmarky, ktoré zodpovedajú konkrétnej úlohe, napríklad na slovenské embedding benchmarky pre RAG.