SLAIH: pri slovenskom prepise reči nestačí jedno číslo z rebríčka
SLAIH opisuje, že dôveryhodný benchmark pre slovenské speech-to-text modely stojí na voľbe normalizácie, pestrej testovacej množine a meraní v zhoršených akustických podmienkach. Organizácia zároveň upozorňuje, že agregované skóre môže zakryť veľké rozdiely medzi čítanou a spontánnou rečou a že dnešný benchmark má aj jasne pomenované obmedzenia.
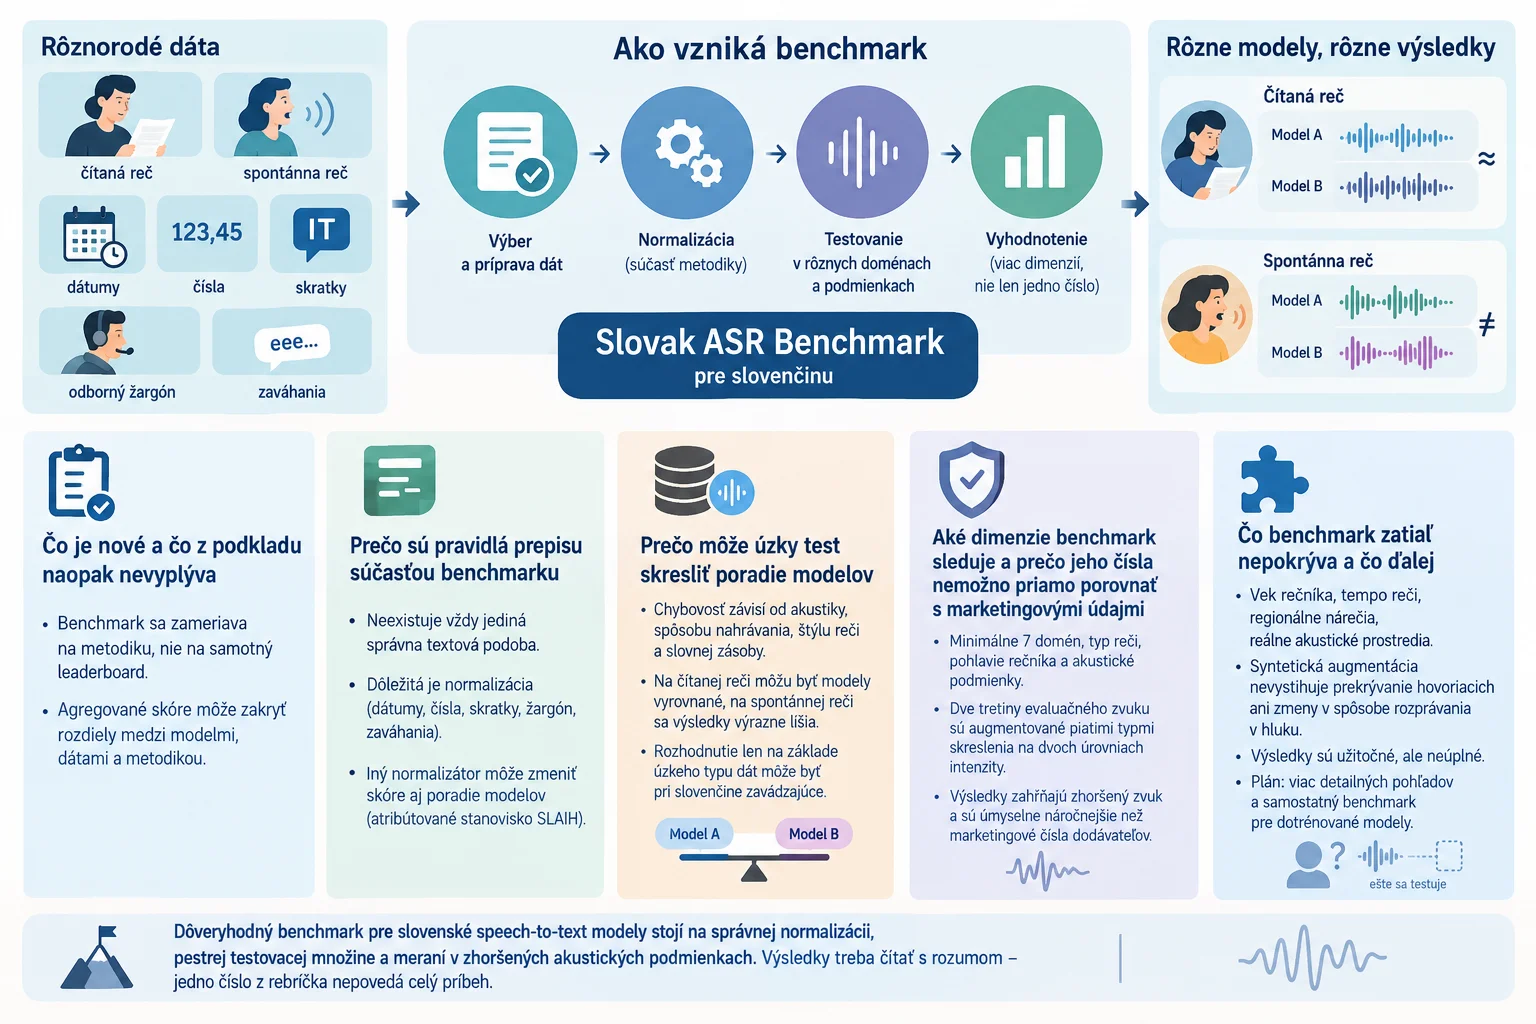
SLAIH zverejnil metodický opis svojho Slovak ASR Benchmarku s jednoduchým, ale dôležitým odkazom: pri slovenčine sa model na rozpoznávanie reči nedá rozumne vyberať len podľa jedného súhrnného čísla. Organizácia píše, že benchmark nevznikol ako prehliadka výsledkov, ale ako pokus ukázať, čo všetko treba urobiť, aby bolo porovnanie modelov vôbec dôveryhodné.
Jedným z kľúčových bodov je normalizácia prepisov. Pri hovorenom dátume, číslach či skratkách môže existovať viac správnych zápisov, takže pravidlá, podľa ktorých sa porovnáva výstup modelu s referenčným prepisom, priamo menia to, čo sa počíta ako chyba. SLAIH preto tvrdí, že dva benchmarky s rovnakými nahrávkami, ale iným normalizátorom, môžu dať odlišné skóre aj odlišné poradie modelov.
Druhý problém je reprezentatívnosť dát. SLAIH uvádza príklad, podľa ktorého sa dva modely na čítanej reči javia takmer rovnako, no pri spontánnej reči sa ich výsledky výrazne rozídu. Z pohľadu nasadenia je to podstatné: ak test príliš pripomína len jeden typ nahrávok, agregované skóre môže pôsobiť presne, ale v praxi zavádzať.
Benchmark preto podľa SLAIH sleduje výkon naprieč doménami, typom reči, pohlavím rečníka aj akustickými podmienkami. Dve tretiny evaluačného zvuku sú navyše zámerne zhoršené viacerými typmi šumu, takže celkové výsledky sú prísnejšie a nedajú sa priamo porovnávať s číslami dodávateľov meranými na čistej reči. Organizácia zároveň otvorene priznáva, že dnešná verzia ešte nepokrýva napríklad vek rečníka, nárečia či skutočné hlučné prostredia.
Podrobnosti a podklady
Čo je nové a čo z podkladu naopak nevyplýva
Primárny zdroj hovorí, že SLAIH vytvoril „Slovak ASR Benchmark“ pre slovenčinu a v sprievodnom texte sa sústredí na metodiku, nie na samotný leaderboard. To je dôležité aj redakčne: podklad podporuje článok o tom, ako benchmark vzniká a čo jeho čísla znamenajú, nie tvrdenie o absolútne najlepšom modeli na trhu. Aj archívny materiál AI INDUSTRY k tejto téme upozorňuje, že jedno agregované skóre môže zakryť rozdiely v dátach a metodike.
Prečo sú pravidlá prepisu súčasťou benchmarku
SLAIH vysvetľuje, že pri prepise reči neexistuje vždy jediná správna textová podoba. Ako príklady uvádza dátumy, čísla, skratky, odborný žargón aj zaváhania rečníka. Preto považuje normalizáciu za súčasť metodiky benchmarku, nie za technický detail po spracovaní dát. Presná hranica platnosti je tu dôležitá: tvrdenie, že iný normalizátor môže zmeniť skóre aj poradie modelov, pochádza od SLAIH a článok ho má prezentovať ako atribútované metodické stanovisko organizácie.
Prečo môže úzky test skresliť poradie modelov
Zdroj zdôrazňuje, že jeden zdroj dát nestačí, pretože chybovosť ASR závisí od akustiky, spôsobu nahrávania, štýlu reči aj slovnej zásoby. Ako konkrétny príklad SLAIH uvádza dvojicu modelov Omnilingual ASR LLM 7B a Whisper large v3: na čítanej reči sú podľa textu prakticky vyrovnané, no na spontánnej reči sa ich výsledky výrazne odlišujú. Z toho vyplýva obmedzený, ale praktický záver: nákupné alebo integračné rozhodnutie postavené len na úzkom type dát môže byť pri slovenčine zavádzajúce.
Aké dimenzie benchmark sleduje a prečo jeho čísla nemožno priamo porovnať s marketingovými údajmi
Podľa SLAIH benchmark člení výkon minimálne podľa siedmich domén, typu reči, pohlavia rečníka a akustických podmienok. Pri akustike zdroj výslovne uvádza, že dve tretiny evaluačného zvuku sú augmentované piatimi typmi skreslenia na dvoch úrovniach intenzity. Organizácia zároveň upozorňuje, že preto jej celkové výsledky zahŕňajú zhoršený zvuk a sú úmyselne náročnejšie než čísla reportované dodávateľmi na čistej reči. To je silné praktické upozornenie, ale stále ide o tvrdenie samotného tvorcu benchmarku, nie o nezávisle overený štandard trhu.
Obmedzenia benchmarku a ohlásené ďalšie kroky
SLAIH zároveň otvorene opisuje, čo benchmark zatiaľ nepokrýva: vek rečníka, tempo reči, regionálne nárečia a reálne akustické prostredia. Syntetická augmentácia má podľa zdroja limity, lebo nevystihuje napríklad prekrývanie hovoriacich ani zmeny v spôsobe rozprávania v hluku. Preto je vhodné čítať dnešné výsledky ako užitočný, ale neúplný obraz schopností modelov v slovenčine. Zdroj navyše hovorí aj o pláne zverejniť viac detailných pohľadov a pripraviť samostatný benchmark pre dotrénované modely, aby sa neporovnávali skreslene s modelmi bez takejto distribučnej výhody.
Zdroje
Súvisiace
Ďalšie články k téme
KInIT: pri slovenskom rozpoznávaní reči je problém skôr v dátach než v modeloch
KInIT 22. októbra 2026 uviedol, že zverejnil 39-hodinový slovenský ASR benchmark na SLAIH a prvé doladené otvorené modely. Podľa jeho výsledkov dosiahol na rovnakých dátach najsilnejší komerčný systém 10,8 % word error rate a najlepší bežne dostupný open-weight model 17,5 %, pričom po doladení na slovenčine chybovosť v skúšaných architektúrach klesla približne na polovicu. Inštitút zároveň upozorňuje na dve hranice: úzku dátovú rozmanitosť a zhoršenie výkonu v iných jazykoch po plnom fine-tuningu.
SLAIH upozorňuje na päť zdrojov pre slovenčinu v AI: od multimodálneho modelu po rečové a férovostné datasety
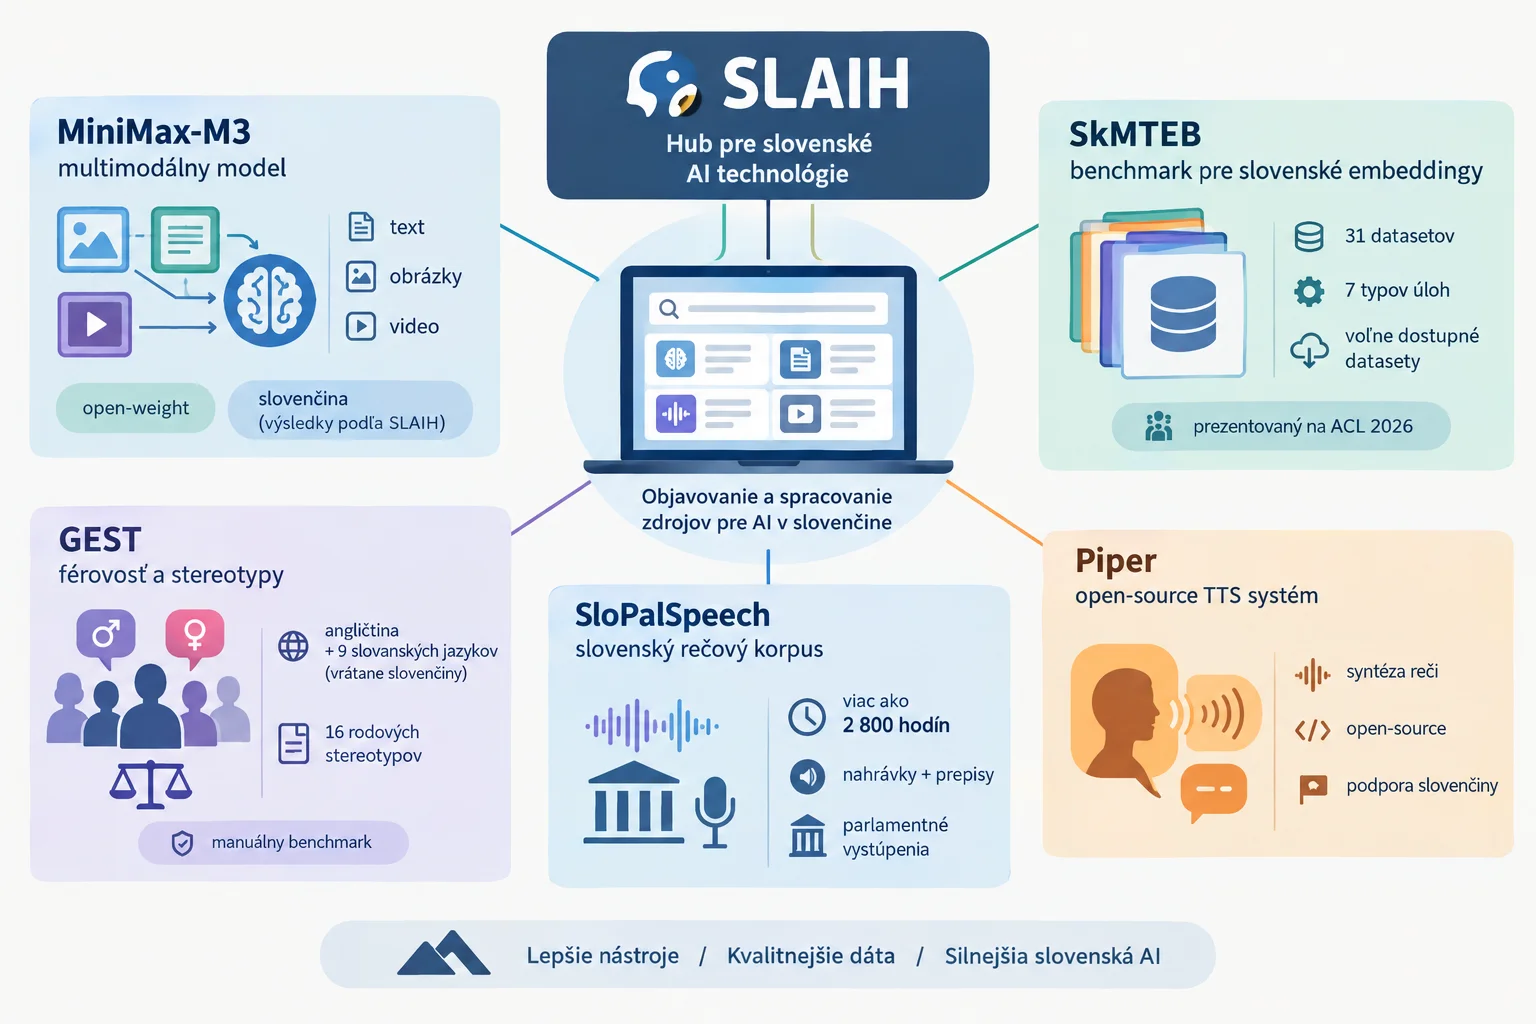
SLAIH vo svojom oznámení vyzdvihol päť prírastkov v katalógu pre slovenské jazykové technológie: multimodálny model MiniMax-M3, embeddingový benchmark SkMTEB, benchmark rodových stereotypov GEST, rečový korpus SloPalSpeech a open-source TTS systém Piper. Pri každej položke ide o opis a parametre, ktoré uvádza samotné SLAIH.
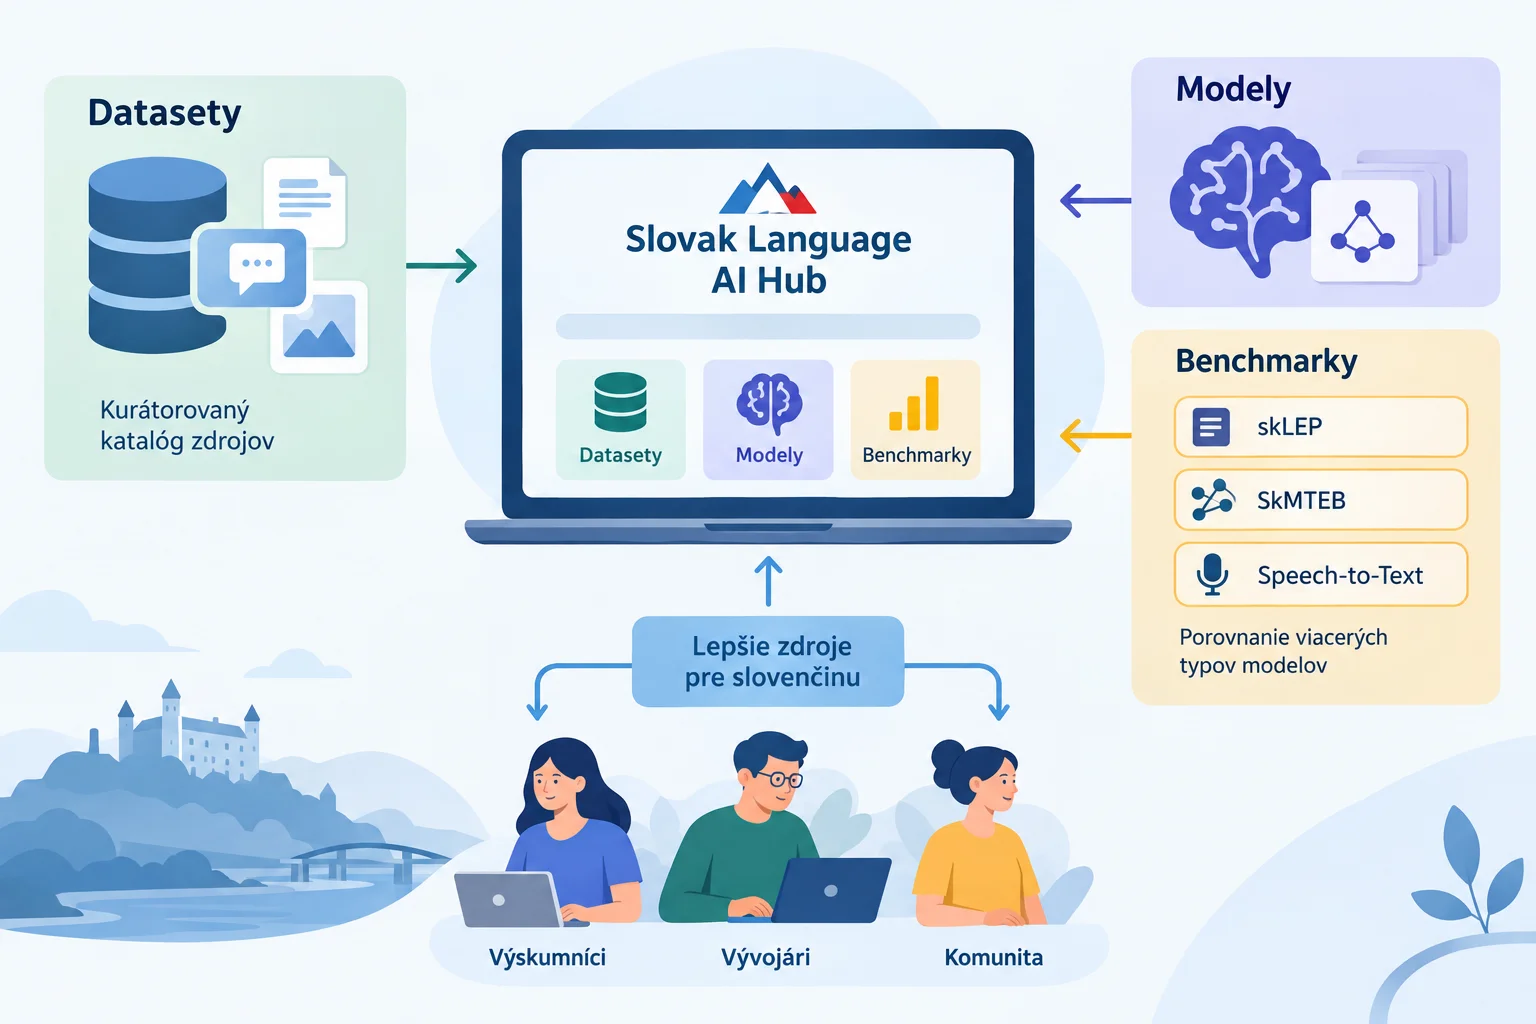
SLAIH spustil centrálny hub pre slovenské datasety, modely a benchmarky
Slovak Language AI Hub podľa svojho oznámenia spustil centrálne miesto pre datasety, modely a benchmarky pre slovenčinu. V prvej verzii uvádza kurátorovaný katalóg zdrojov a výsledky troch benchmarkov: skLEP, SkMTEB a Speech-to-Text.
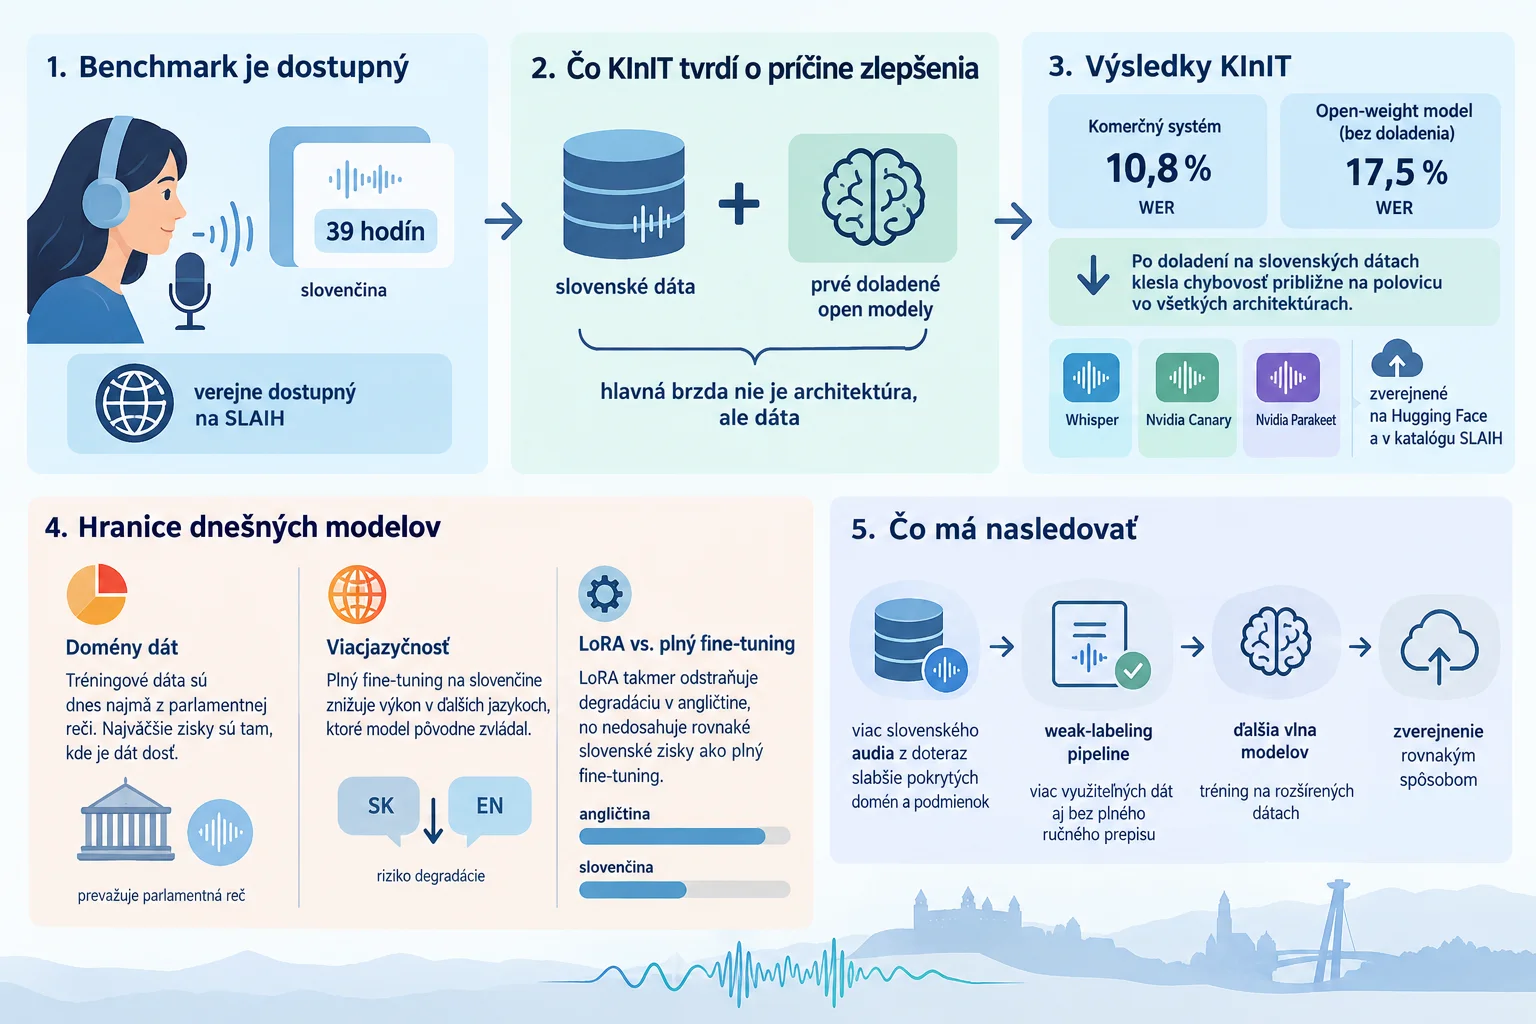
KInIT tvrdí, že slovenské dáta vedia výrazne zlepšiť prepis reči
Na SLAIH je podľa oznámenia dostupný prvý špecializovaný benchmark rozpoznávania reči pre slovenčinu. KInIT zároveň uvádza, že pri doladení otvorených modelov na slovenských dátach klesla chybovosť približne na polovicu, no dnešné verzie majú aj jasné limity v pokrytí domén a vo viacjazyčnom použití.