AI systémy a vývoj
Transformers v5.22.0 prináša FP8 tréning adaptérov a nižšiu pamäťovú špičku pri MoE
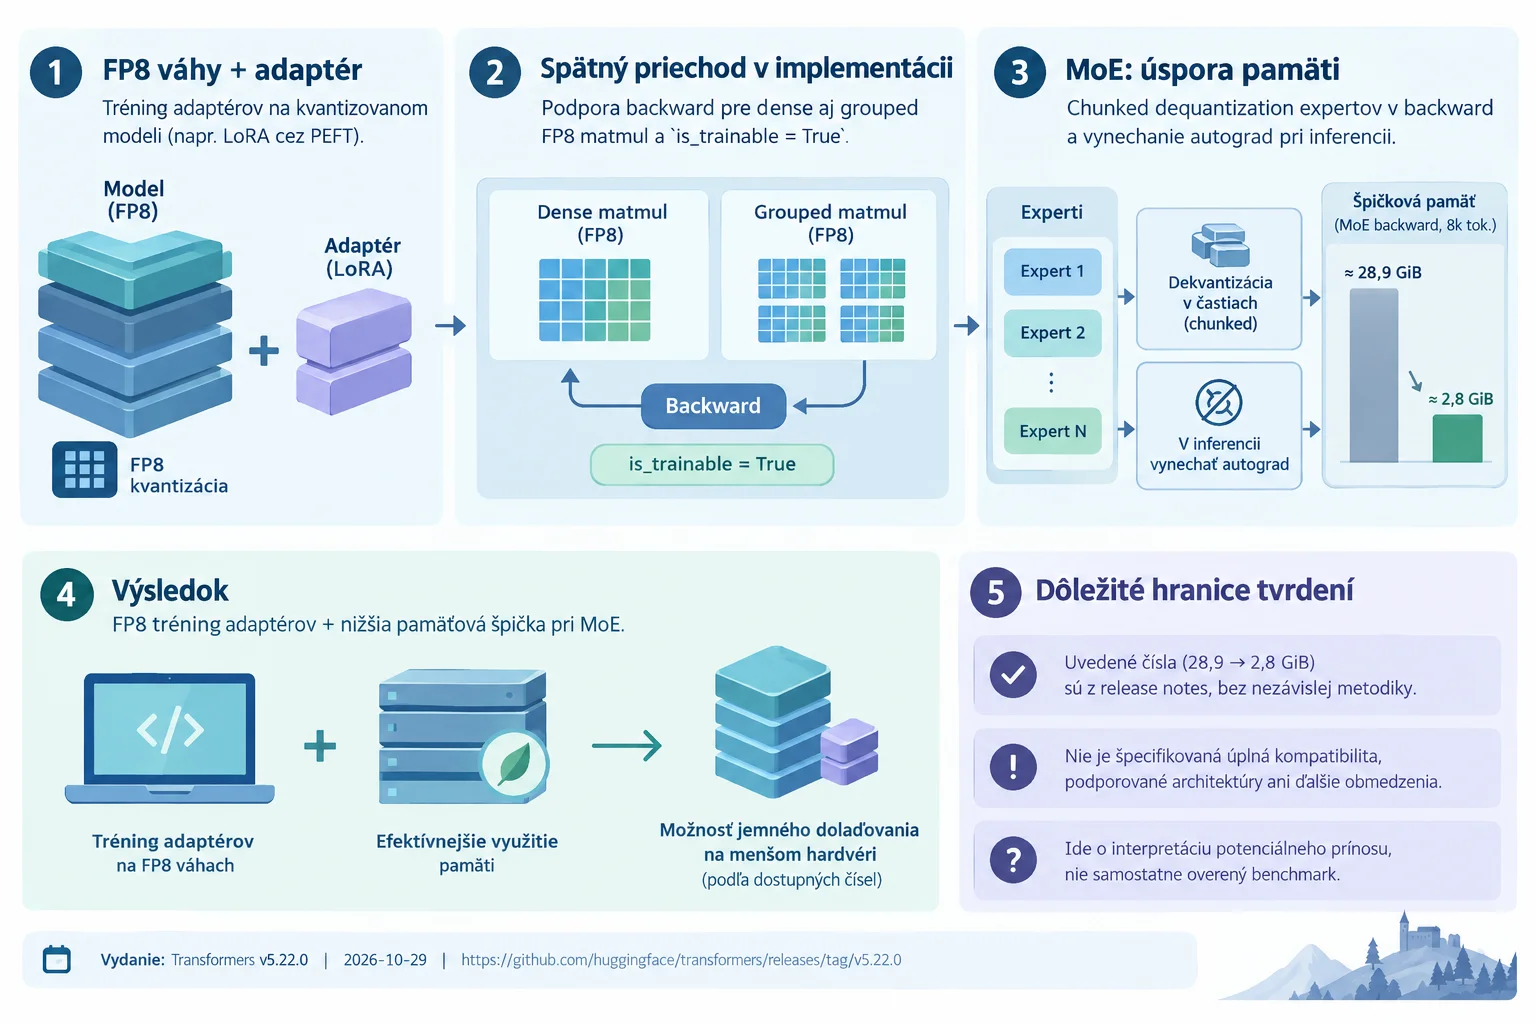
V poznámkach k vydaniu Transformers v5.22.0 Hugging Face uvádza, že FP8 kvantizované modely sa dajú použiť na tréning adaptérov, napríklad LoRA cez PEFT. Zmena stojí na doplnení spätného priechodu pre dense aj grouped FP8 matmul operácie a na tom, že `is_trainable` je teraz `True`. Dokument zároveň tvrdí, že chunked dequantization expertov v backward a vynechanie autograd pri inferencii znižujú špičkovú pamäť v MoE vrstve backward z približne 28,9 GiB na 2,8 GiB pri 8k tokenoch.