KInIT: vysoké skóre ešte neznamená, že multimodálna AI naozaj rozumie obrázkom
KInIT zverejnil 20. októbra 2026 súhrn doktorandského výskumu Ivany Beňovej o multimodálnych modeloch. Podľa autorky môžu modely na jednoduchých benchmarkoch pôsobiť presvedčivo, no pri hľadaní správneho popisu medzi tisíckami možností sa ukáže, že slabšie chápu najmä akcie a vzťahy medzi objektmi.
KInIT publikoval 20. októbra 2026 text, v ktorom Ivana Beňová sumarizuje svoj doktorandský výskum o tom, či modely pracujúce s obrazom a textom skutočne prepájajú to, čo „vidia“ a čítajú. Hlavné posolstvo je opatrné: vysoké čísla v benchmarkoch ešte samy osebe nedokazujú reálne porozumenie.
Podľa autorky sa problém ukáže najmä vtedy, keď sa test zmení z ľahkého výberu medzi dvoma vetami na vyhľadanie správneho popisu medzi tisíckami kandidátov. V takom nastavení modely v jej opise často našli niečo podobné, ale pomýlili si akciu alebo vzťah medzi objektmi.
Beňová píše, že modely bývajú lepšie v rozpoznaní toho, kto je na obrázku, než v pochopení toho, čo presne robí a komu. Práve to je dôležité pre vyhľadávanie obrázkov, moderovanie obsahu, multimodálnych asistentov aj fact-checking, kde chyba v type „kto čo komu urobil“ môže viesť k zlým záverom.
Text zároveň nepredstavuje nezávislý externý test jedného konkrétneho produktu. Je to autorský súhrn výskumu z KInIT, ktorý podľa článku priniesol tri publikované práce, štyri ďalšie podané na posúdenie a verejne dostupný dataset s kódom.
Podrobnosti a podklady
Čo KInIT zverejnil a v akom rámci
Zdrojom je príspevok KInIT s dátumom „Oct 20. 2026“ a názvom „When AI thinks it understands pictures and text: what modern multimodal models can (and cannot) do“. Autorka v ňom píše, že jej doktorandský výskum sa sústredil na medzeru medzi dojmom, že porozumenie obrazu a textu je už vyriešené, a realitou, v ktorej sú multimodálne modely od skutočného prepájania obrazu a textu ešte ďaleko. Ide teda o zdokumentovaný súhrn výskumu od samotnej výskumníčky, nie o nezávislé porovnanie dodané treťou stranou.
Prechod od dvojice možností k vyhľadávaniu v tisícoch viet
Autorka opisuje, že bežné benchmarky často testujú model tak, že má pri jednom obrázku vybrať správny popis len z dvoch možností: jednej správnej a jednej zámerne zmenenej. Vo svojom výskume preto zmenila perspektívu na retrieval, teda úlohu, v ktorej má model nájsť najlepšie sediaci text v celej databáze tisícov viet. Práve tam sa podľa nej ukázalo, že výsledky zo zjednodušených testov môžu preceňovať skutočné porozumenie.
Kde sa vysoké skóre rozpadá
Kľúčový kontrast v texte je číselný, no treba ho čítať ako tvrdenie autorky o skúmaných modeloch. Píše: „On the classic two-option tests, the models we studied picked the correct sentence in eight or nine cases out of ten.“ Hneď nato dodáva, že pri úlohe nájsť zhodný text medzi tisíckami kandidátov „the models succeeded in only about one case out of ten“. Zároveň vysvetľuje, že model často našiel významovo podobný výsledok, ale mýlil sa v akcii alebo vo vzťahu medzi objektmi.
Čo modelom robí problém a prečo na tom záleží
Beňová ďalej tvrdí, že modely zvládajú najlepšie subjekty, horšie objekty a ešte horšie slovesá a vzťahy. V texte to formuluje priamo: „subjects (who?) are the easiest for the models, objects (whom? what?) are much harder, verbs and relations (what is he or she doing?) are even harder.“ Na tomto základe viaže praktický dosah na oblasti ako image search, content moderation, multimodálni asistenti a fact-checking. Hranica platnosti je dôležitá: nejde o dôkaz, že všetky multimodálne modely zlyhávajú rovnako, ale o výskumné zistenia opísané v súhrne KInIT.
Prečo je meranie kvality ťažšie, než vyzerá
Text opisuje aj metodický problém hodnotenia. Pri retrievale sa ukázalo, že nie každý výsledok označený klasickou metrikou za chybu je naozaj sémanticky nesprávny. Preto autorka zapojila ľudských anotátorov a aj ďalší veľký model ako rozhodcu pre dvojice obrázok–popis. Podľa článku sa tak ukázalo, že skutočná kvalita mohla byť lepšia, než naznačovali tvrdé benchmarkové čísla. To je dôležité skôr ako poznámka k metodike hodnotenia než ako finálny verdikt o schopnostiach celej triedy modelov.
Výstupy a obmedzenia zdroja
KInIT v závere sumarizuje výstupy práce takto: „the research produced three published papers, four papers currently under review, and a publicly available dataset and code.“ Článok menuje aj konkrétne línie: guided masking, CV-Probes, retrieval-based evaluation, test „who does what to whom“ a aplikácie vo fact-checkingu. Keďže časť z nich je podľa textu ešte „under review“, najbezpečnejšie je hovoriť o zdokumentovanom výskumnom programe a jeho priebežných výstupoch, nie o úplne uzavretom externom potvrdení všetkých záverov.
Zdroje
Súvisiace
Ďalšie články k téme
KInIT zhrnul výstupy projektu lorAI: od slovenského benchmarku sk-bench po PEFT-Bench
KInIT 26. októbra 2026 zverejnil stránku „Research powered by lorAI“, na ktorej sumarizuje publikácie podporené projektom lorAI a ďalšie práce s partnermi lorAI. Podľa KInIT záber týchto výstupov siaha od efektívnych LLM a fine-tuningu po auditing, benchmarking a human-centered AI; medzi konkrétnymi príkladmi uvádza aj slovenský benchmark sk-bench a benchmark PEFT-Bench pre parameter-efficient fine-tuning.
KInIT: pri slovenskom rozpoznávaní reči je problém skôr v dátach než v modeloch
KInIT 22. októbra 2026 uviedol, že zverejnil 39-hodinový slovenský ASR benchmark na SLAIH a prvé doladené otvorené modely. Podľa jeho výsledkov dosiahol na rovnakých dátach najsilnejší komerčný systém 10,8 % word error rate a najlepší bežne dostupný open-weight model 17,5 %, pričom po doladení na slovenčine chybovosť v skúšaných architektúrach klesla približne na polovicu. Inštitút zároveň upozorňuje na dve hranice: úzku dátovú rozmanitosť a zhoršenie výkonu v iných jazykoch po plnom fine-tuningu.
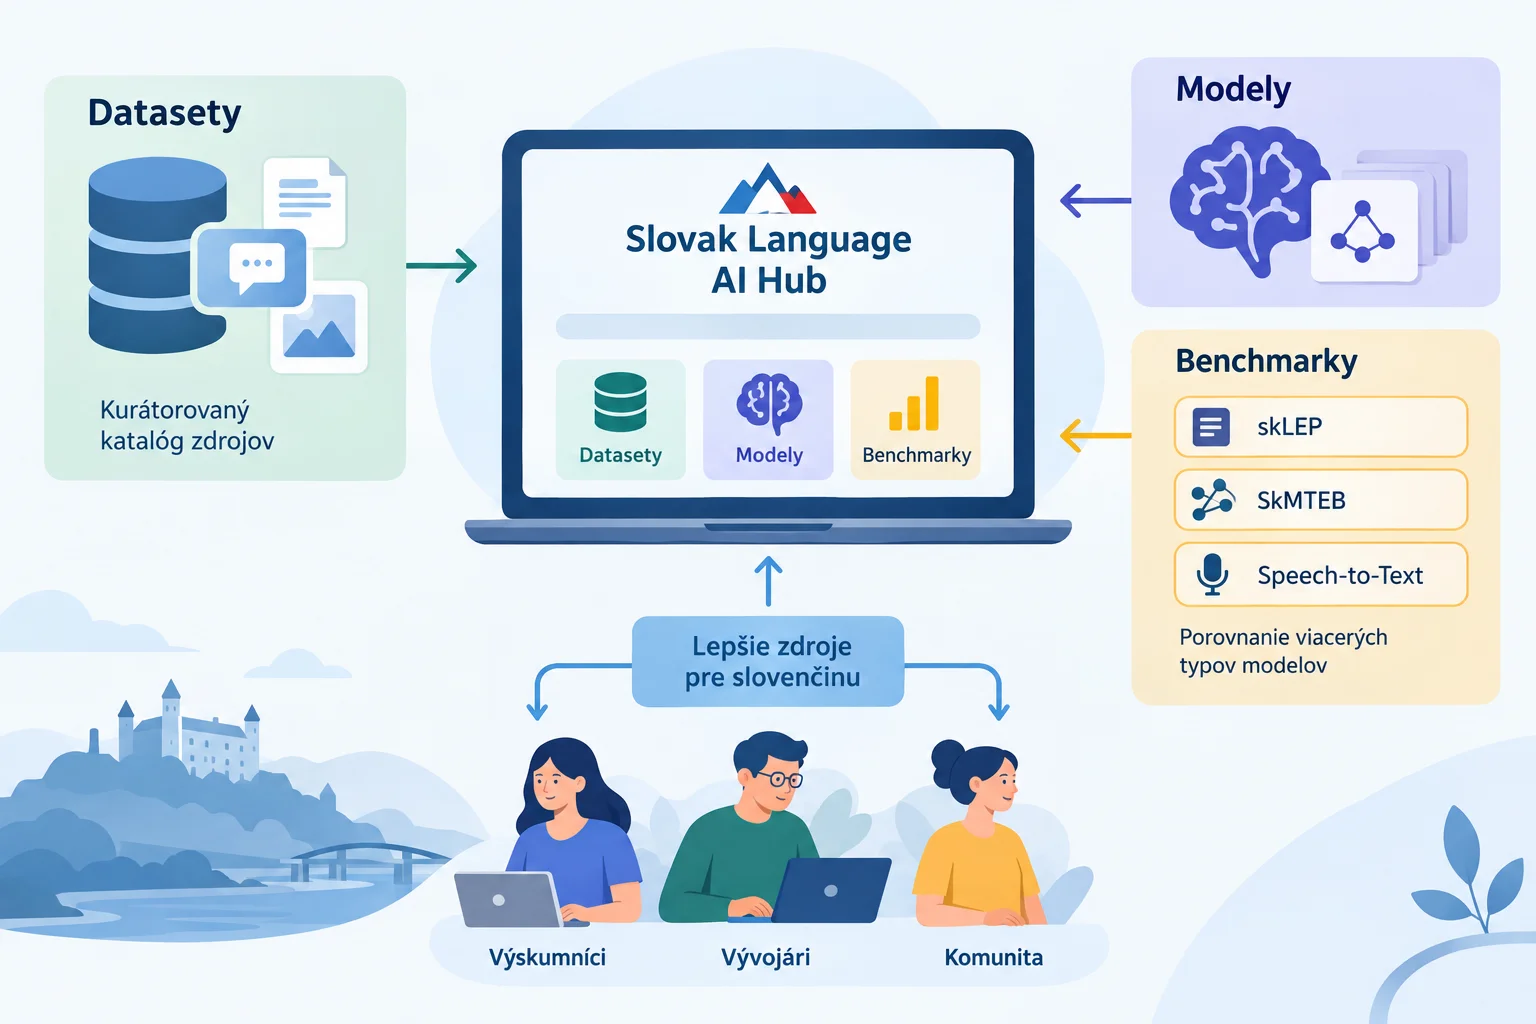
SLAIH spustil centrálny hub pre slovenské datasety, modely a benchmarky
Slovak Language AI Hub podľa svojho oznámenia spustil centrálne miesto pre datasety, modely a benchmarky pre slovenčinu. V prvej verzii uvádza kurátorovaný katalóg zdrojov a výsledky troch benchmarkov: skLEP, SkMTEB a Speech-to-Text.
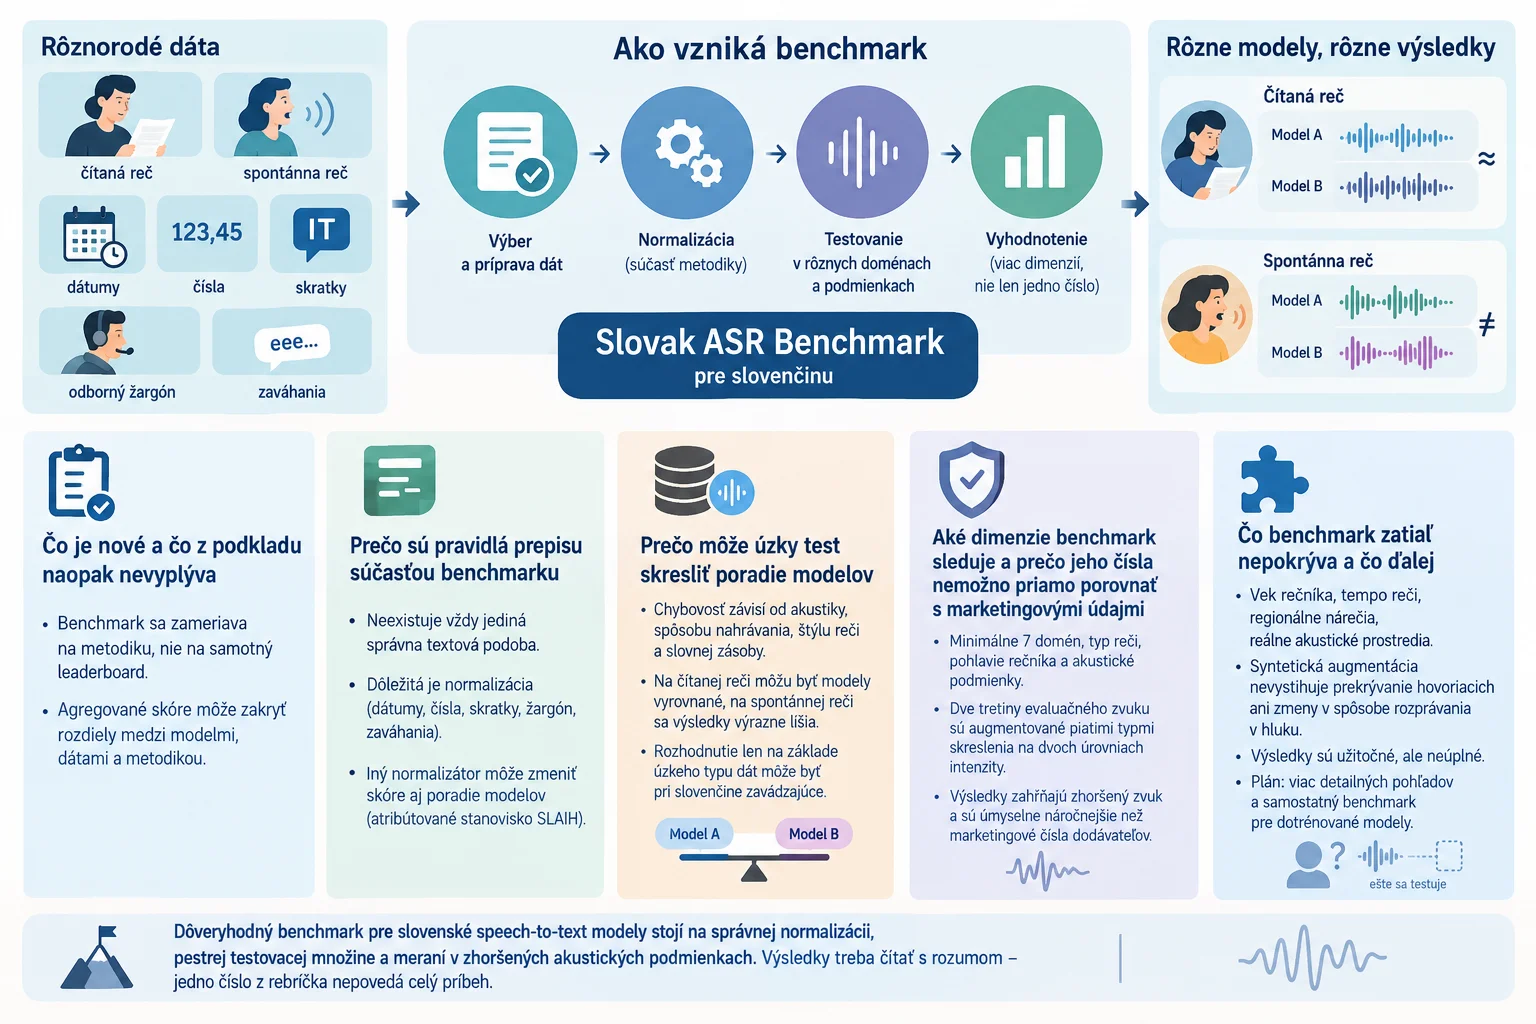
SLAIH: pri slovenskom prepise reči nestačí jedno číslo z rebríčka
SLAIH opisuje, že dôveryhodný benchmark pre slovenské speech-to-text modely stojí na voľbe normalizácie, pestrej testovacej množine a meraní v zhoršených akustických podmienkach. Organizácia zároveň upozorňuje, že agregované skóre môže zakryť veľké rozdiely medzi čítanou a spontánnou rečou a že dnešný benchmark má aj jasne pomenované obmedzenia.