Google opisuje federované učenie s TEE: auditovateľnejšie súkromie a presun tréningu na server
Google Research predstavilo novú generáciu federovaného učenia, v ktorej klienti šifrujú tréningové dáta, prístup povoľujú cez zverejnené politiky a dešifrovanie prebieha len vo workloadoch v Trusted Execution Environments. Firma zároveň tvrdí, že presun výpočtu na server zrýchlil tréning a že Gboard už systém používa pri anglickom a japonskom predikovaní ďalšieho slova; tieto prínosy však v dodaných podkladoch nemajú nezávislé overenie.
Google Research oznámilo novú verziu federovaného učenia, v ktorej sa mení nielen architektúra tréningu, ale aj spôsob, ako sa má overovať súkromie. Podľa firmy systém využíva Trusted Execution Environments (TEE), aby boli anonymizačné záruky externe overiteľné a auditovateľné, pričom časť výpočtu sa presúva zo zariadení na server. To je dôležité preto, že klasické federované učenie sľubuje prácu s decentralizovanými dátami, no zdroj zároveň priznáva starší praktický problém: externý pozorovateľ nevedel overiť, že server dáta neukladá alebo nečíta nad rámec deklarovaného spracovania.
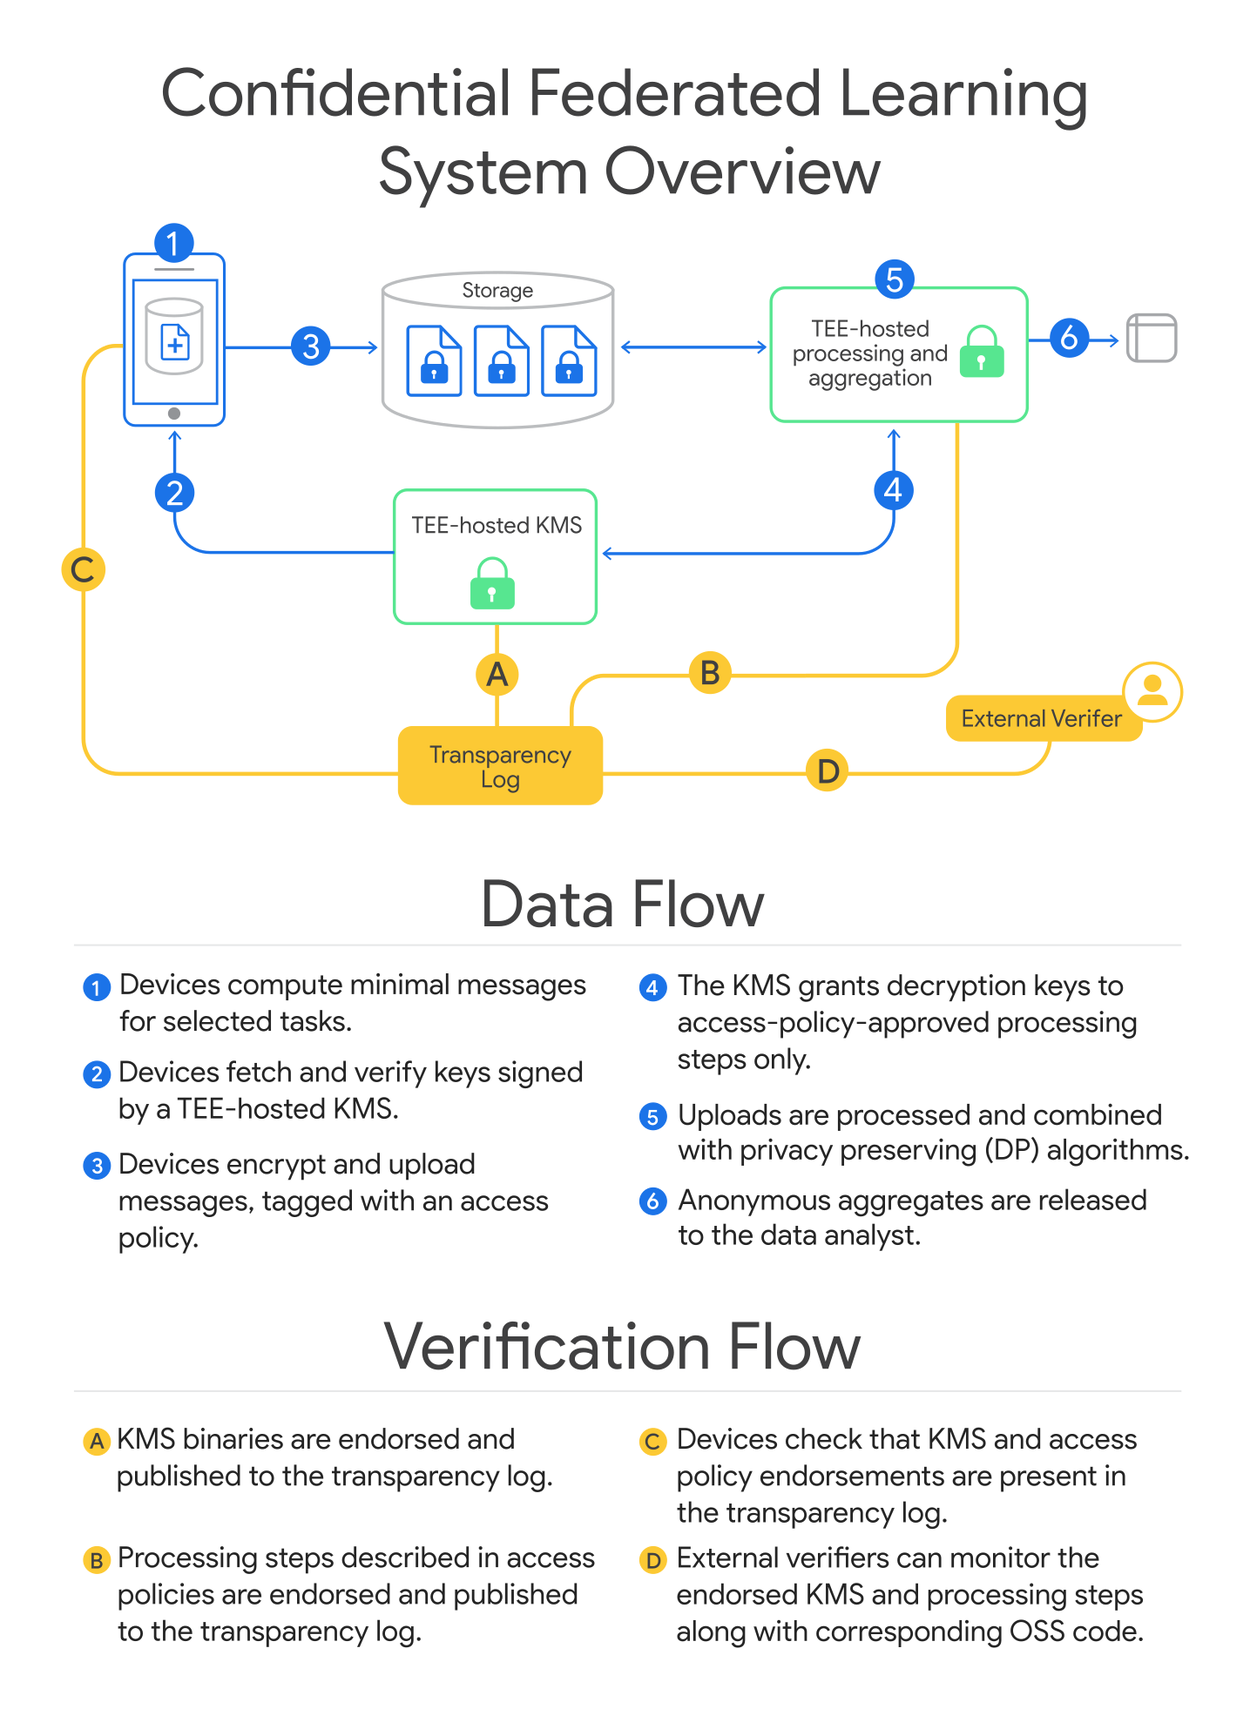
Mechanizmus je v zdroji opísaný pomerne konkrétne. Zariadenia lokálne zašifrujú tréningové príklady a vopred schvália prístupovú politiku, teda zoznam TEE výpočtov, ktoré smú dáta spracovať a uvoľniť z nich iba anonymizované výstupy. Kľúče na dešifrovanie potom vydáva iba TEE-based Key Management System pre workloady, ktoré zodpovedajú tejto politike. Google zároveň píše, že tieto politiky sa zverejňujú v transparentnom logu Rekor a že binárky KMS aj dátového spracovania sa dajú reprodukovateľne zostaviť z open-source kódu, takže audit sa nemá opierať len o sľub prevádzkovateľa.
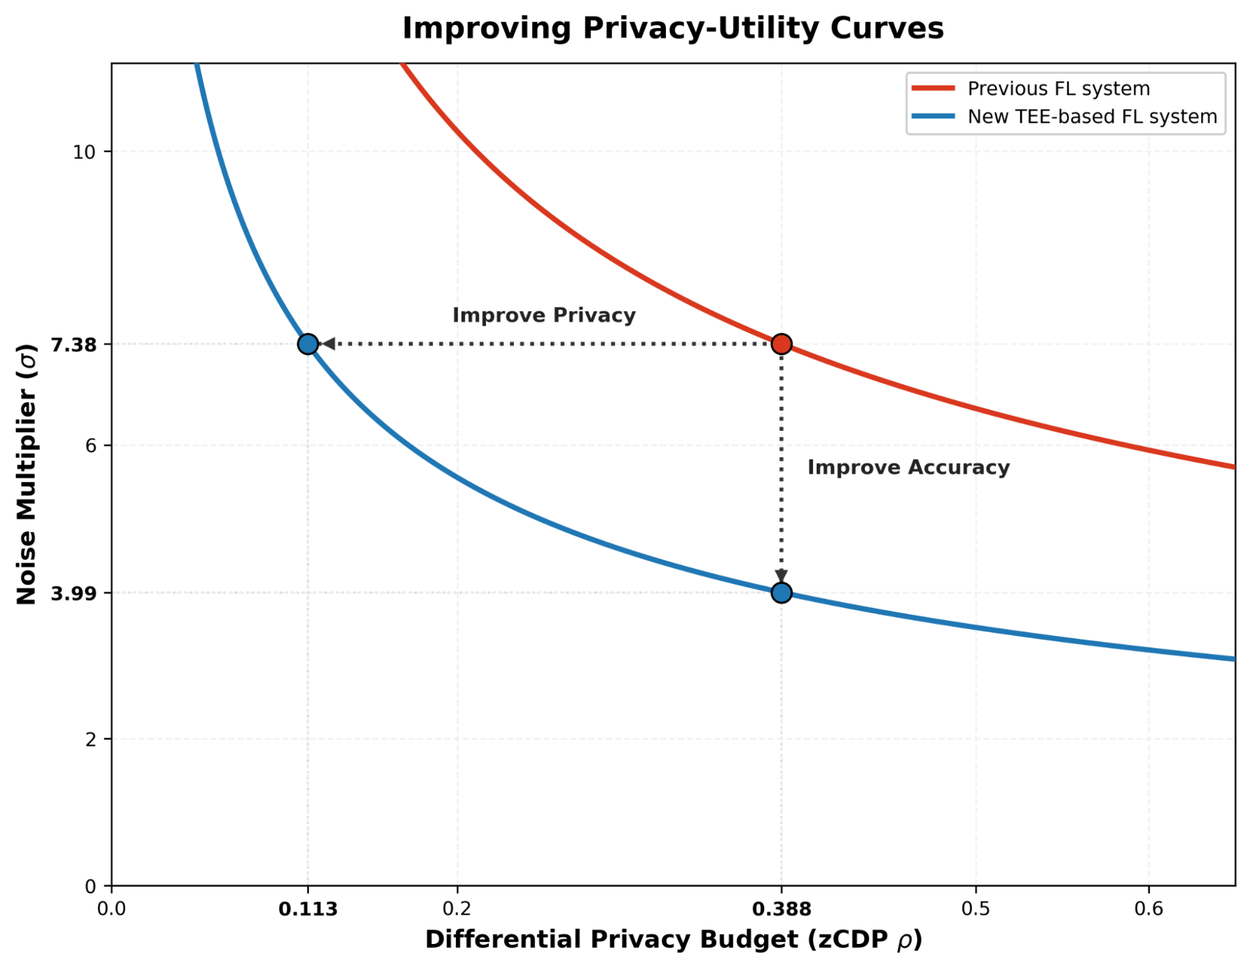
Pre praktické nasadenie je podstatné, že tréningová logika beží ako Python program v TEE, môže paralelizovať úlohy na worker TEE a priebežne uvoľňuje len anonymizované váhy modelu. Google tvrdí, že týmto presunom výpočtu na server odpadá časť obmedzení viazaných na dostupnosť a výkon zariadení. Firma konkrétne uvádza, že Gboard už tento systém nasadilo pre anglické a japonské modely predikcie ďalšieho slova a že zaznamenáva silnejšie súkromie, lepšiu presnosť a výrazné zrýchlenie tréningu. To však treba čítať ako tvrdenia Google: dodané podklady neobsahujú nezávislý audit týchto prínosov ani externé porovnávacie testy.
Podrobnosti a podklady
Čo sa mení oproti staršiemu federovanému učeniu
Základná zmena oproti starším prístupom je dvojitá: auditovateľnosť a presun výpočtu. Primárny zdroj to sumarizuje vetou, že ide o „new Federated Learning system“ poskytujúci „externally verifiable privacy guarantees“ a zároveň presúvajúci výpočet „to the server to improve training speed, accuracy, and device coverage“. Súčasne vysvetľuje, prečo je to posun oproti starším FL systémom: pri skoršom nahrávaní dát na okamžitú agregáciu „there was no way for external observers to verify that the data was never logged or inspected“. Nový systém má podľa Google znižovať potrebu veriť operátorovi servera tým, že súkromiu relevantná logika beží vo verifikovateľných TEE.
Ako funguje mechanizmus: šifrovanie, politika prístupu a KMS
Tok dát a autorizácie je v zdroji rozdelený do viacerých krokov. Klientské zariadenia „locally encrypt training examples and upload them“ a zároveň „pre-authorize an access policy“, ktorá určuje, ktoré TEE výpočty smú dáta spracovať. Táto politika má podľa textu povoľovať len workloady, ktoré uvoľnia anonymizované výsledky. Kľúčovým sprostredkovateľom je Key Management System: „The Key Management System (KMS), which consists of a cluster of TEEs implementing the RAFT consensus protocol, only gives decryption keys to server-side TEE workloads that match the computations in the access policy.“ Samotný dátový processing TEE potom spúšťa Python tréningový program, deleguje paralelizovateľné úlohy na worker TEE a po kolách tréningu ukladá KMS-šifrovaný recovery stav na obnovu po výpadku bez ďalšieho úniku súkromne citlivých informácií.
Ako má prebiehať audit a aké sú hranice tohto modelu
Auditovateľnosť stojí na dvoch explicitne uvedených pilieroch. Po prvé, „The access policies representing these potential future server workloads are published to Rekor, a public transparency log“, takže externí audítori môžu sledovať, ktoré workloady zariadenia môžu potenciálne obsluhovať. Po druhé, „The KMS and data processing binaries used in our FL system can be reproducibly built from open source code published in the Confidential Federated Compute Github repository.“ Zdroj tiež uvádza model dynamického sideloadingu: prístupové politiky priamo opisujú Python program s FL logikou, no niektoré serializované informácie možno do programu nahrávať za behu, aby sa chránili proprietárne architektúry a preprocessing. Hranica platnosti je dôležitá: Google výslovne dodáva, že silné externe overiteľné záruky ostávajú zachované „As long as all privacy-relevant logic remains hardcoded in the Python program“, a text zároveň pripomína obmedzenia súčasnej generácie TEE a riziko side-channel pozorovaní.
Praktický význam pre Gboard a čo zatiaľ nie je nezávisle overené
Pri prevádzkových dopadoch treba rozlišovať medzi doloženým mechanizmom a tvrdeniami autora zdroja o prínose. Google píše, že v novom systéme „only metrics and differentially private model weights are visible to workload operators“ a že šifrované tréningové dáta možno dešifrovať len v TEE workloadoch definovaných politikou a iba obmedzený čas po nahraní. Firma zároveň opisuje, že zber uploadov pred spustením server-side tréningu zmierňuje problém „diurnal variations in device availability impacting training progress“. V časti o Gboard zdroj tvrdí, že systém bol nasadený pre anglické a japonské next-word prediction modely so „stronger privacy guarantees and improved accuracy“. A v časti o rýchlosti dodáva, že skorší tréning mohol trvať „1-2 months each“, kým nový prístup presúva úzke hrdlá na server a vďaka paralelizácii prináša „significant speedups in training time“. Dodané podklady však neobsahujú nezávislé benchmarky, audit ani reprodukciu týchto výsledkov, preto tieto body treba interpretovať ako tvrdenia Google Research.
Čo Google uvádza ako ďalší krok
Zdroj naznačuje aj ďalší smer vývoja. Google píše, že presun výpočtu klientskych gradientov na server „paves the way for training increasingly larger models using FL techniques“ a že dôležitú rolu môžu mať TEE integrované s akcelerátormi. Zároveň uvádza, že infraštruktúra vie verifikovateľne vykonávať aj iné workloady vyjadriteľné v Pythone a že firma experimentuje napríklad so syntetickým generovaním dát či s kombináciou TEE pre arbitrary Python a TEE špecializovaných na funkcie ako LLM inferencia. To sú však v dodanom zdroji plány a experimentálne smery, nie už doložené produkčné výsledky.
Zdroje
Súvisiace
Ďalšie články k téme
Google opísal autofinetune na Cloud TPU: agentické post-training slučky pre SFT a GRPO
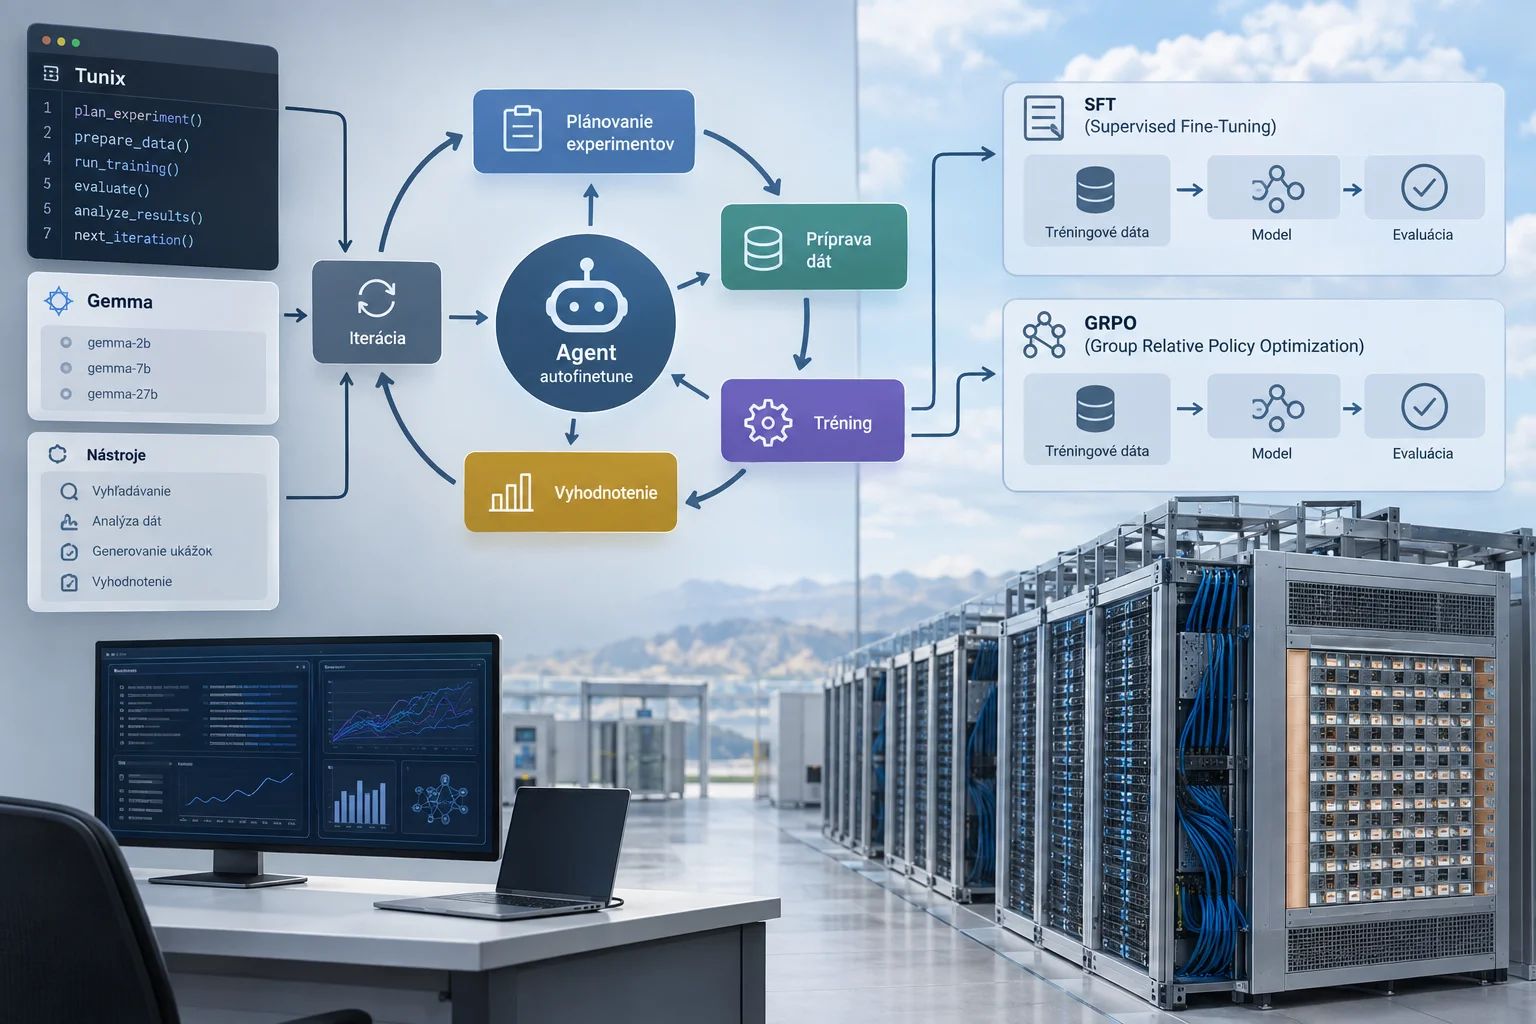
Google Developers Blog 11. septembra 2026 predstavil projekt autofinetune: agentický workflow pre post-training LLM na Cloud TPU s Tunix, Gemma a pomocnými nástrojmi. Podklad ukazuje mechanizmus automatizovaných experimentov pre SFT aj GRPO, no výkonové zlepšenia sú doložené len ako tvrdenia pôvodcu v ukážkových behoch.
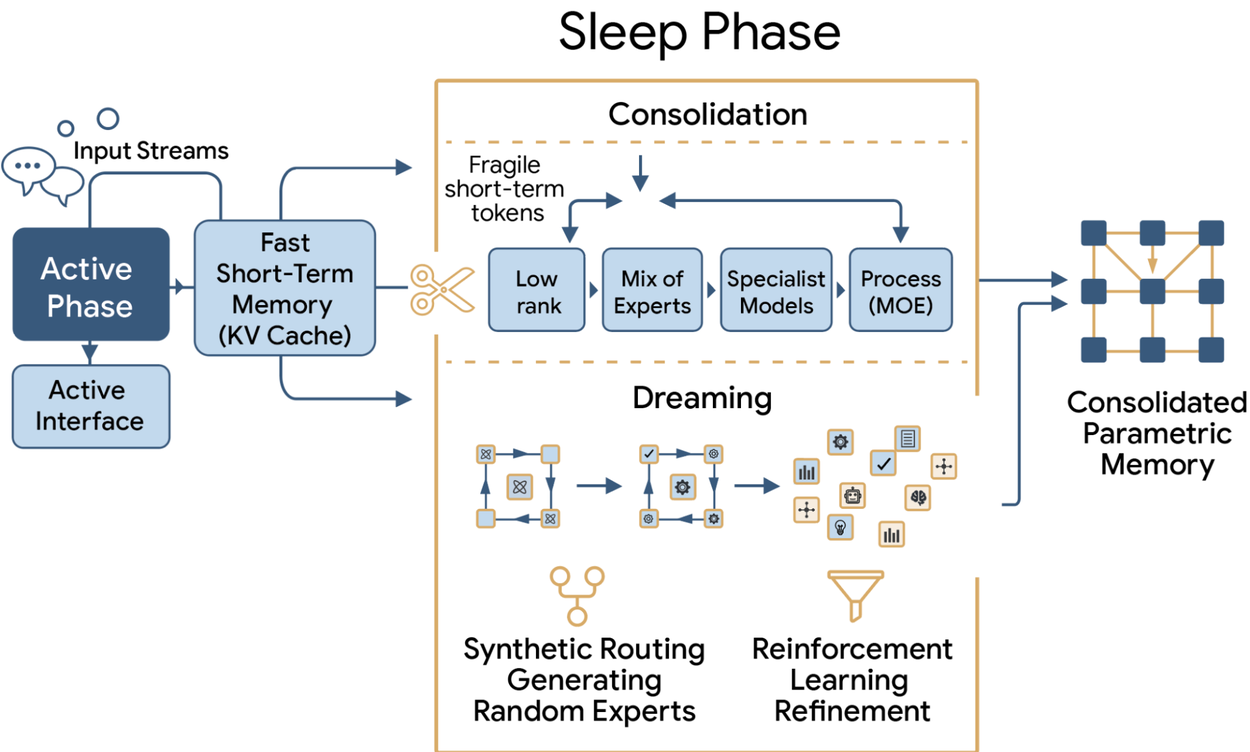
Google Research opisuje „sleep framework“ pre LLM: oddelená fáza spánku má ukladať nové poznatky bez prepísania starých
Google Research predstavilo rámec continual learningu, v ktorom sa model strieda medzi aktívnou fázou a „spánkom“. Počas spánku má konsolidovať krátkodobé stopy do parametrov cez rozšírenie kapacity, distiláciu znalostí a imitation learning; Google zároveň tvrdí zlepšenia pri dlhom kontexte, dopĺňaní faktov aj reasoningu, no v dodaných podkladoch ich nemožno nezávisle overiť.
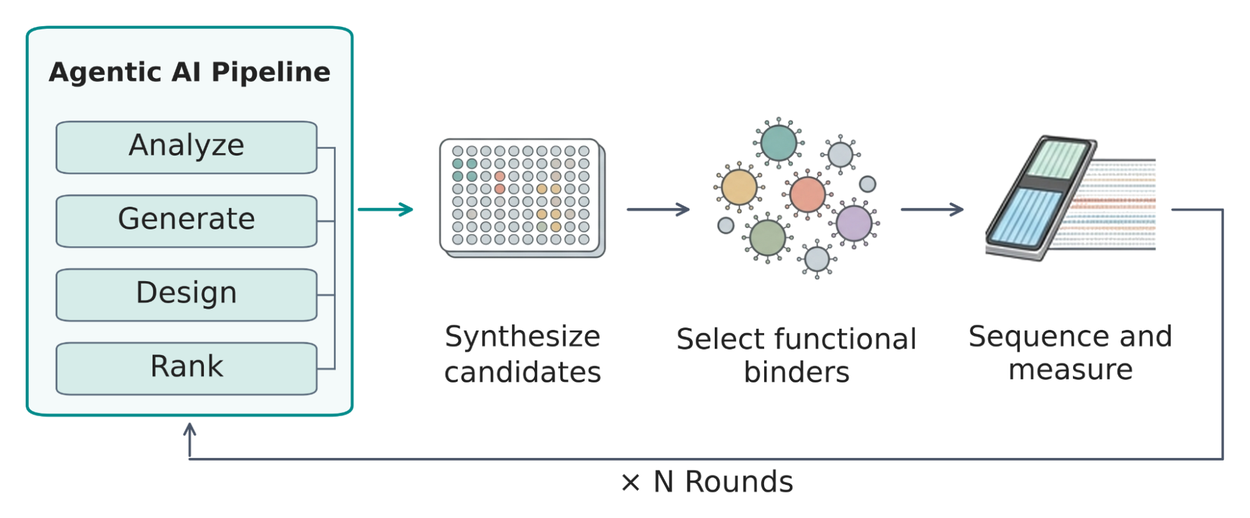
Google Research opisuje stavebné bloky pre autonómne wet laby: digitálne dvojča, uzavreté cykly a bindery pre FAP
Google Research na svojom blogu predstavilo prístup, v ktorom AI agenti neostávajú len pri návrhu molekúl v softvéri, ale sú napojení na laboratórnu robotiku cez framework VERID. Firma zároveň tvrdí, že v uzavretých cykloch zlepšila hit rate aptamérov pre myoglobín a α-thrombín a pri cieli FAP našla bindery so single-digit nanomolar afinitou. V dodaných podkladoch však ide o firemné tvrdenia a opis interného výskumného postupu, nie o nezávislé externé overenie.
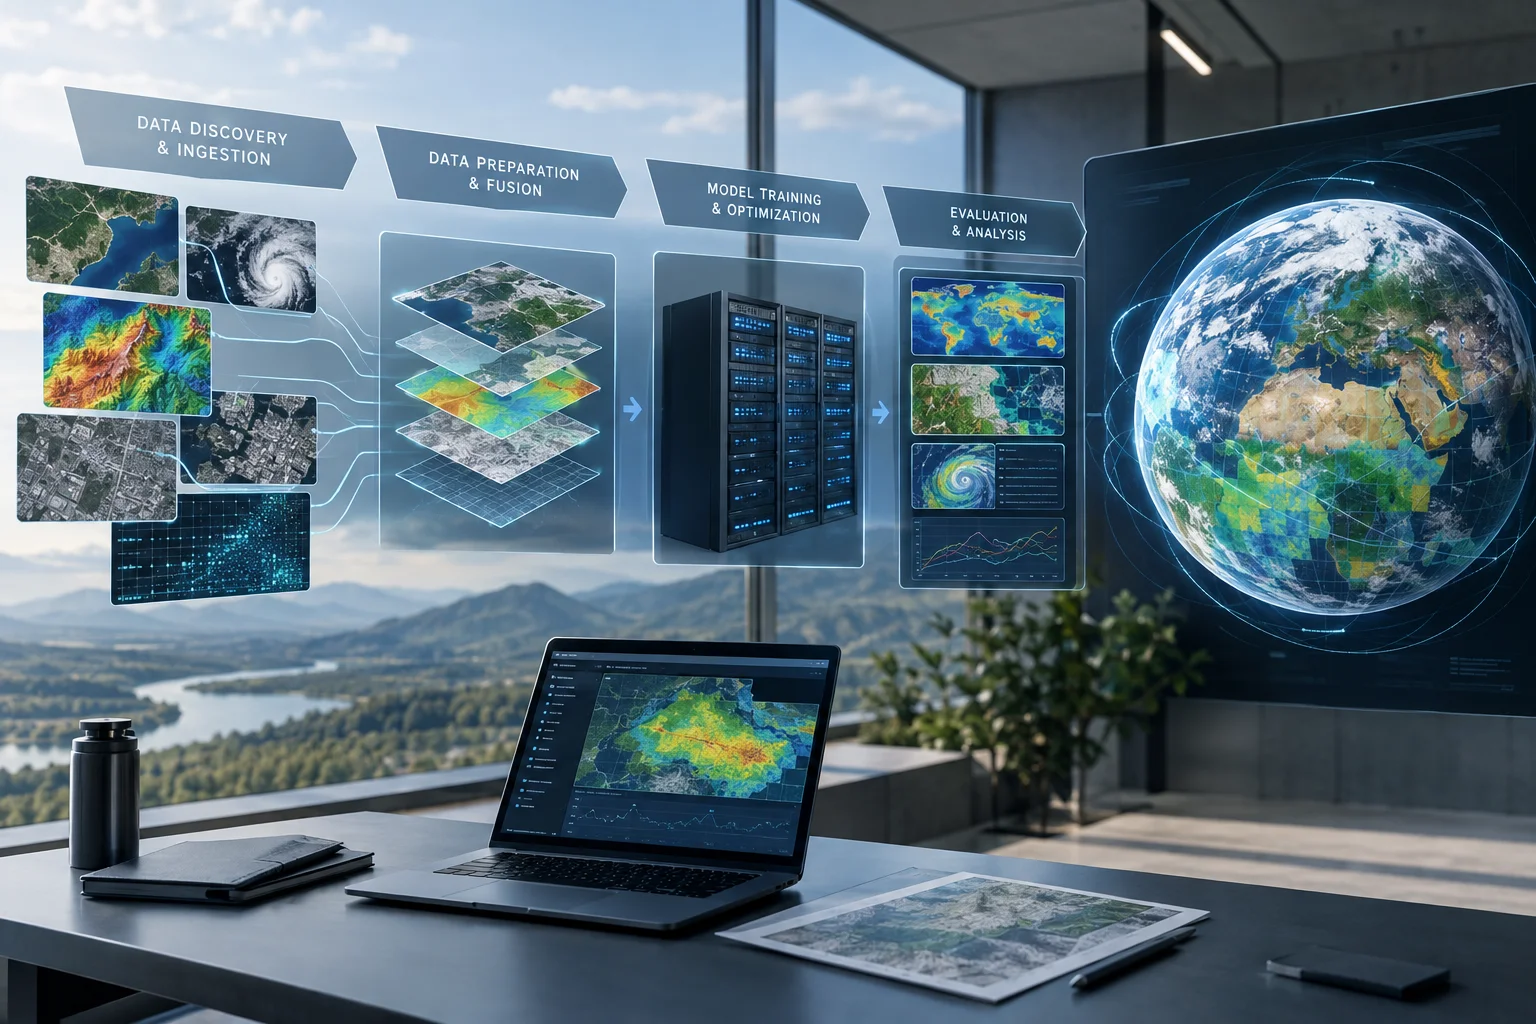
Google Research predstavilo experimentálny Planetary Prediction Engine pre autonómne geopriestorové modelovanie
Google Research 27. augusta 2026 opísalo Planetary Prediction Engine ako experimentálnu výskumnú schopnosť v rámci Earth AI. Systém má autonómne vykonávať celý geopriestorový modelovací workflow od vyhľadania dát po tréning a vyhodnotenie, no dostupnosť ako produkt či API podklad nedokladá.