Liquid AI prináša lokálneho agenta s dvoma miliardami aktívnych parametrov
LFM2.5-24B-A2B rozširuje kontext a podporuje nástroje. Malý aktívny výpočet však neznamená malú veľkosť celého modelu.
Agent môže pracovať aj na vlastnom zariadení
Liquid AI 13. októbra predstavilo LFM2.5-24B-A2B, model určený na viacstupňové úlohy a používanie nástrojov. Má 24 miliárd parametrov, no pri spracovaní tokenu aktivuje približne dve miliardy. Dostupné váhy umožňujú lokálnu prevádzku bez odosielania každej otázky do vzdialeného modelového API.
To je zaujímavé pri práci so súbormi alebo internými údajmi. Samotná lokálna inferencia však nestačí na súkromie celého agenta: vyhľadávanie na internete, externé nástroje alebo telemetria sú samostatné cesty, ktorými môžu údaje odchádzať zo zariadenia.
Výber expertov šetrí výpočet, nie všetku pamäť
Architektúra kombinuje krátke konvolúcie a pozornosť. V blokoch mixture-of-experts vyberá štyroch zo 64 expertov. Kontext sa oproti predchodcovi zväčšil z približne 32-tisíc na 131-tisíc tokenov a rozšíril sa aj slovník. Model pred odpoveďou vytvára fázu uvažovania, ktorá zaberá ďalší čas aj tokeny.
Modelová karta poskytuje konfigurácie pre lokálne agentové nástroje a podporované runtime. Pri spustení sa musí zmestiť celý súbor váh spolu s pracovnou pamäťou. Dve miliardy aktívnych parametrov preto nemožno zamieňať s nárokmi samostatného dvojmiliardového modelu.
Lokálne rozhranie kompatibilné s bežnými chatovacími API umožňuje pripojiť model k existujúcemu agentovému nástroju. Nie je to však iba výmena adresy servera. Nástroj musí rozumieť formátu volania funkcií a správne oddeliť priebežné uvažovanie od konečnej odpovede. Práve tieto integračné detaily rozhodujú, či ukážka funguje aj pri opakovanom pracovnom postupe.
Rýchlosť jednej odpovede a priepustnosť servera
Liquid AI uvádza 184 tokenov za sekundu na Apple M5 Max a vysokú celkovú priepustnosť pri súbežných úlohách na NVIDIA B300. Ide o odlišné režimy merania. Súčet tokenov mnohých klientov nehovorí, ako dlho bude na odpoveď čakať jeden používateľ notebooku.
Vlastný pilot by mal začať jednoduchým pracovným postupom: prečítať súbor, vyhľadať údaj a pripraviť zmenu na kontrolu. Hodnotiť treba správne volanie nástrojov, úspešnosť dokončenia a počet opakovaní. Publikované porovnania ukazujú silné výsledky pri niektorých agentových úlohách, no slabšie pri časti programovacích a znalostných testov. Výber modelu má preto vychádzať z konkrétnej práce, nie iba z nízkeho počtu aktívnych parametrov.
Technický kontext
Stav overenia: Spracované podľa zdroja; redakcia postup nereprodukovala.
Verzie: Zdroj neuvádza konkrétne verzie.
Podmienky použitia: Použitie závisí od konkrétnej konfigurácie a dokumentácie uvedenej v zdrojoch.
Obmedzenia: Redakcia nereprodukovala testy dodávateľov; staršie udalosti sú v texte datované.
Zdroje
Súvisiace
Ďalšie články k téme
Muse Spark Open: otvorené váhy veľkého multimodálneho modelu potrebujú veľkú infraštruktúru
Hugging Face rozoberá architektúru modelu Meta aj podporované spúšťanie. Miliónový kontext má výraznú pamäťovú cenu.
EmbeddingGemma 2 prepája text, obraz a zvuk do jedného vyhľadávania
Menší otvorený model od Googlu vytvára spoločný priestor pre rôzne médiá. Pre lokálny archív je podstatná aj veľkosť vektorového indexu.
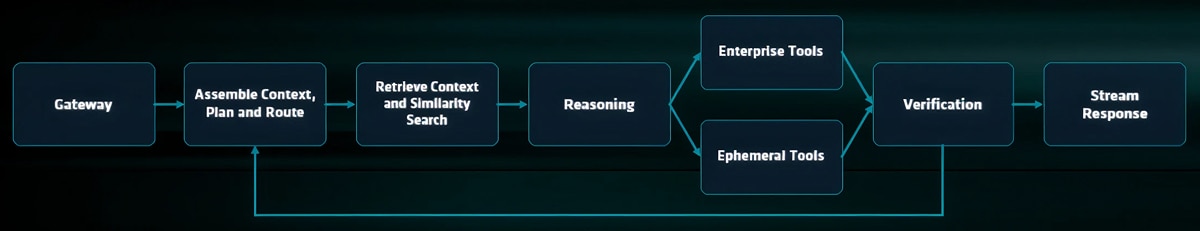
EPYC 9006 rozširuje pamäť aj počet jadier. Agentová AI potrebuje viac než GPU
AMD opisuje platformu Venice s architektúrou Zen 6 a výrobou na 2 nm. CPU obsluhuje vyhľadávanie, databázy a nástroje okolo modelu.
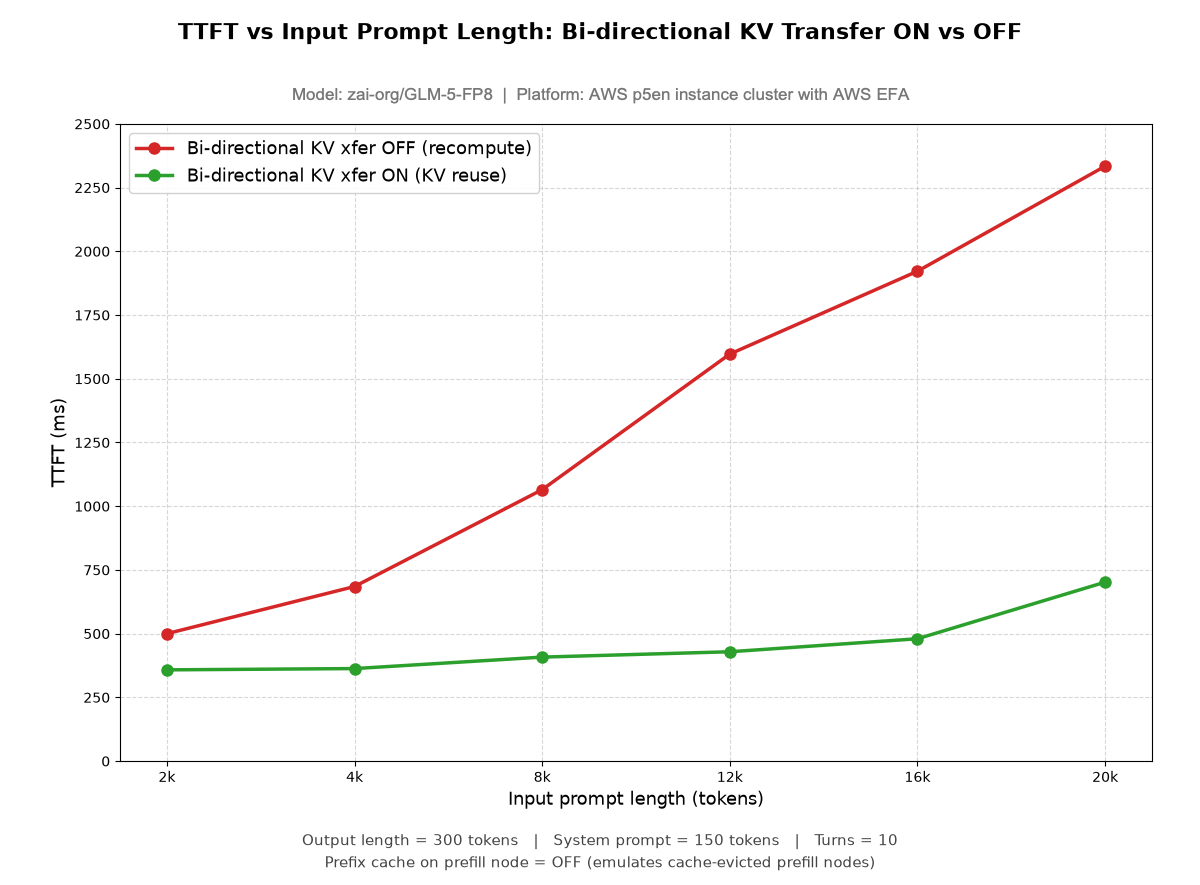
vLLM vracia kontext späť medzi uzlami, aby agent nemusel stále začínať odznova
Obojstranný prenos KV cache cieli na viacťahové konverzácie pri oddelenom spracovaní vstupu a generovaní. Merania ukazujú prínos, ale aj závislosť od dĺžky kontextu a siete.