vLLM vracia kontext späť medzi uzlami, aby agent nemusel stále začínať odznova
Obojstranný prenos KV cache cieli na viacťahové konverzácie pri oddelenom spracovaní vstupu a generovaní. Merania ukazujú prínos, ale aj závislosť od dĺžky kontextu a siete.
Kde sa stráca čas pri ďalšom kole rozhovoru
vLLM v technickom článku z 12. októbra opisuje obojstranný prenos KV cache. Ide o medzivýsledky výpočtov modelu nad už spracovanými tokenmi. Pri oddelených uzloch pre úvodné spracovanie vstupu a následné generovanie sa môže stať, že ďalšia otázka skončí na uzle, ktorý tieto výsledky nemá. Musí potom znovu spracovať narastenú históriu.
Nový postup umožňuje získať uložené bloky aj späť z generovacieho uzla. Smerovač používa identifikátor konverzácie a odovzdáva metadáta o umiestnení; samotné dátové bloky neprechádzajú cez smerovač. Mechanizmus je preto zaujímavý práve pre agentov, ktorí v jednom rozhovore opakovane striedajú nástroje a ďalšie rozhodovanie.
Meranie ukazuje prínos aj jeho hranice
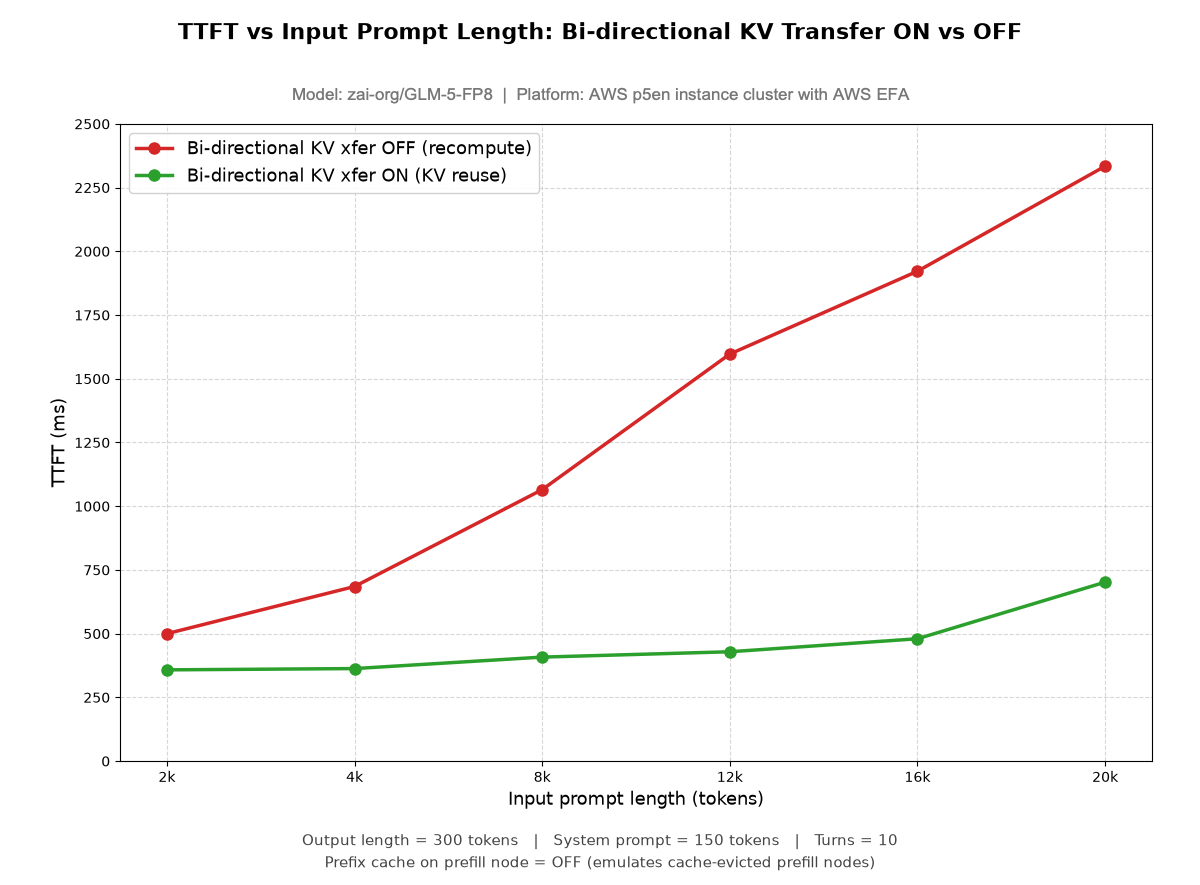
Autori testovali Qwen3-32B a GLM-5-FP8 na konfigurácii s jedným vstupným a jedným generovacím uzlom, na Amazon EC2 P5en s EFA. Na vstupnom uzle vypli prefix cache, aby simulovali chýbajúce lokálne bloky. Pri GLM-5-FP8 a dlhom vstupe uvádzajú pokles času po prvý token z 2 334 na 702 milisekúnd.
Tento výsledok nemožno preniesť na ľubovoľný server ako všeobecné zrýchlenie. Porovnanie zámerne skúma situáciu, keď by sa kontext inak prepočítaval. Ak ho nasadenie už efektívne znovu používa lokálne, priestor na zlepšenie je iný. Dokumentácia NIXL konektora navyše uvádza požiadavky na kompatibilitu a nastavenie prenosov, ktoré musí prevádzkovateľ posúdiť pre svoj model a infraštruktúru.
Výpočty sa šetria za cenu pamäte a komunikácie
Udržané bloky majú obmedzenú životnosť; článok uvádza predvolených 480 sekúnd. Pri krátkom kontexte môže byť prenos drahší než nový výpočet, preto existuje aj nastaviteľný prah opätovného výpočtu, predvolene 64 tokenov.
Pre praktický pilot by sme merali čas po prvý token, čas celej odpovede, obsadenie pamäte a podiel konverzácií, ktoré sa vrátia pred vypršaním blokov. Jedna rýchla odpoveď je iba časť výsledku: dôležité je aj správanie pri súbehu mnohých používateľov.
Prínos tejto zmeny je konkrétny. Namiesto automatického dokupovania výkonu umožňuje overiť, koľko práce infraštruktúra zbytočne opakuje. Uvedené čísla pochádzajú z publikovaného experimentu autorov; vlastné meranie na rovnakej konfigurácii sme nevykonali.
Zdroje
Súvisiace
Ďalšie články k téme
Liquid AI prináša lokálneho agenta s dvoma miliardami aktívnych parametrov
LFM2.5-24B-A2B rozširuje kontext a podporuje nástroje. Malý aktívny výpočet však neznamená malú veľkosť celého modelu.
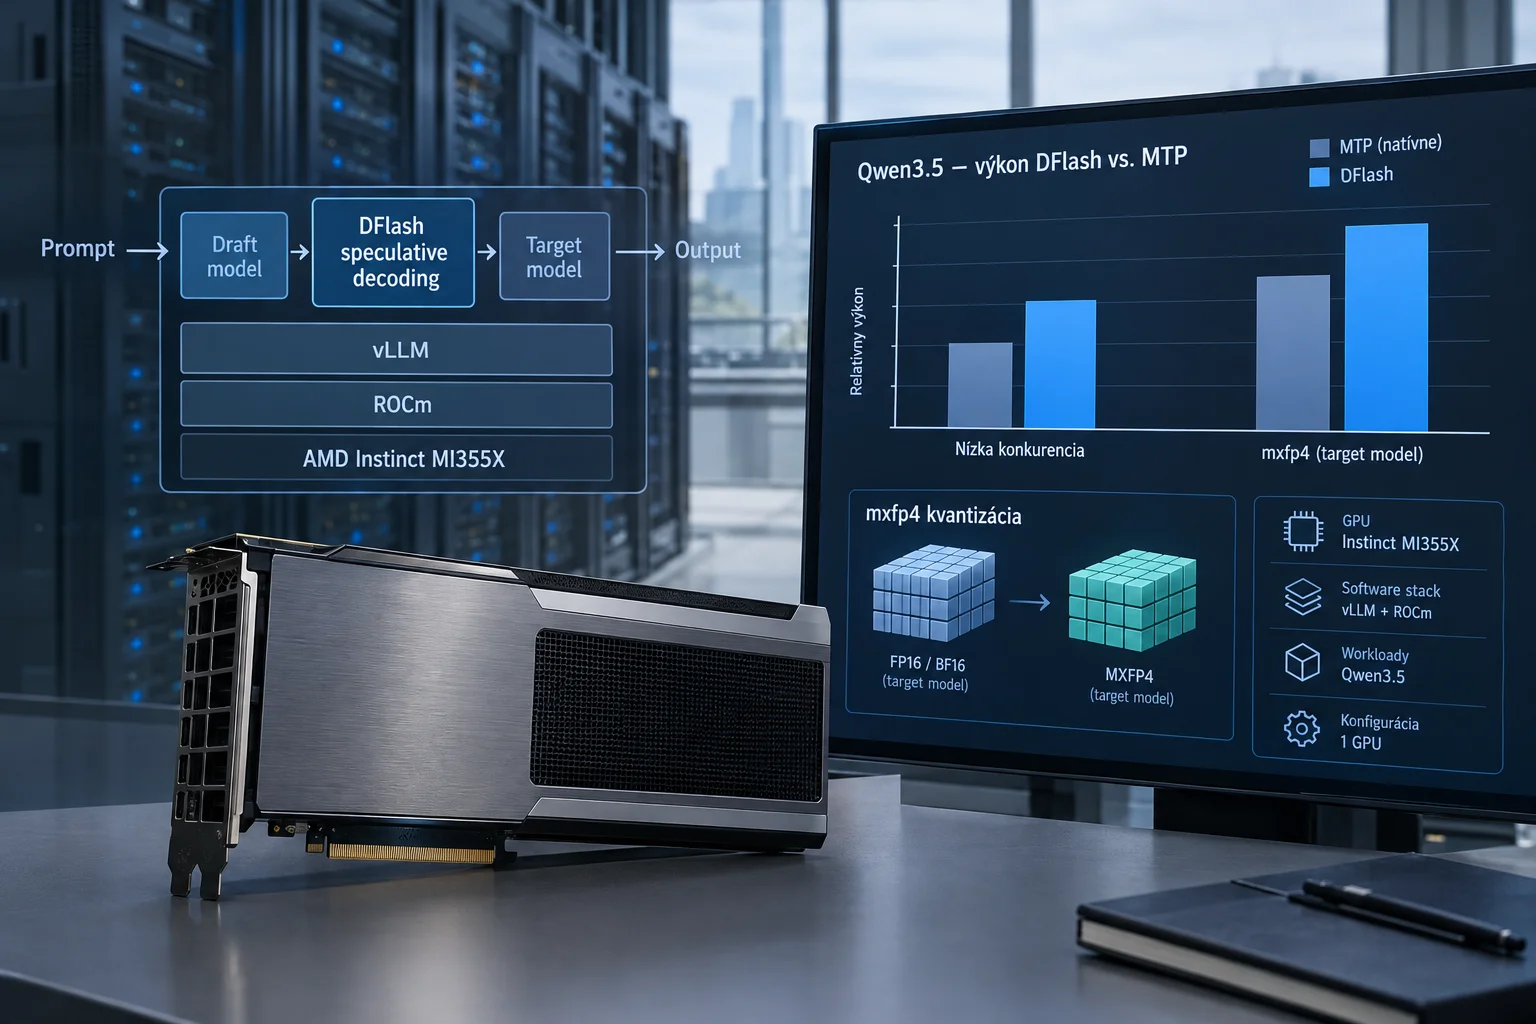
AMD opísalo DFlash vo vLLM na MI355X: na Qwen3.5 porovnáva vyšší výkon než MTP a ďalší zisk s mxfp4
AMD vo firemnom technickom blogu z 16. septembra 2026 popisuje nasadenie DFlash speculative decoding vo vLLM na ROCm pre GPU Instinct MI355X. Podľa benchmarkov výrobcu na modeloch Qwen3.5 DFlash pri nízkej konkurencii prekonáva natívne MTP a pri mxfp4 kvantizácii target modelu sa výkon ďalej zvyšuje, no bez nezávislého overenia a len pre uvedený softvérový stack, workloady a jednu GPU konfiguráciu.
Muse Spark Open: otvorené váhy veľkého multimodálneho modelu potrebujú veľkú infraštruktúru
Hugging Face rozoberá architektúru modelu Meta aj podporované spúšťanie. Miliónový kontext má výraznú pamäťovú cenu.
Rozpočet v LiteLLM potrebuje databázu. Samotná hodnota v konfigurácii nemusí zastaviť výdavky
Dokumentácia proxy upozorňuje na správanie rozpočtov bez databázy a rozlišuje globálne, tímové aj individuálne limity. Pri firemných agentoch treba overiť, ktorý limit sa skutočne uplatní.