AI systémy a vývoj
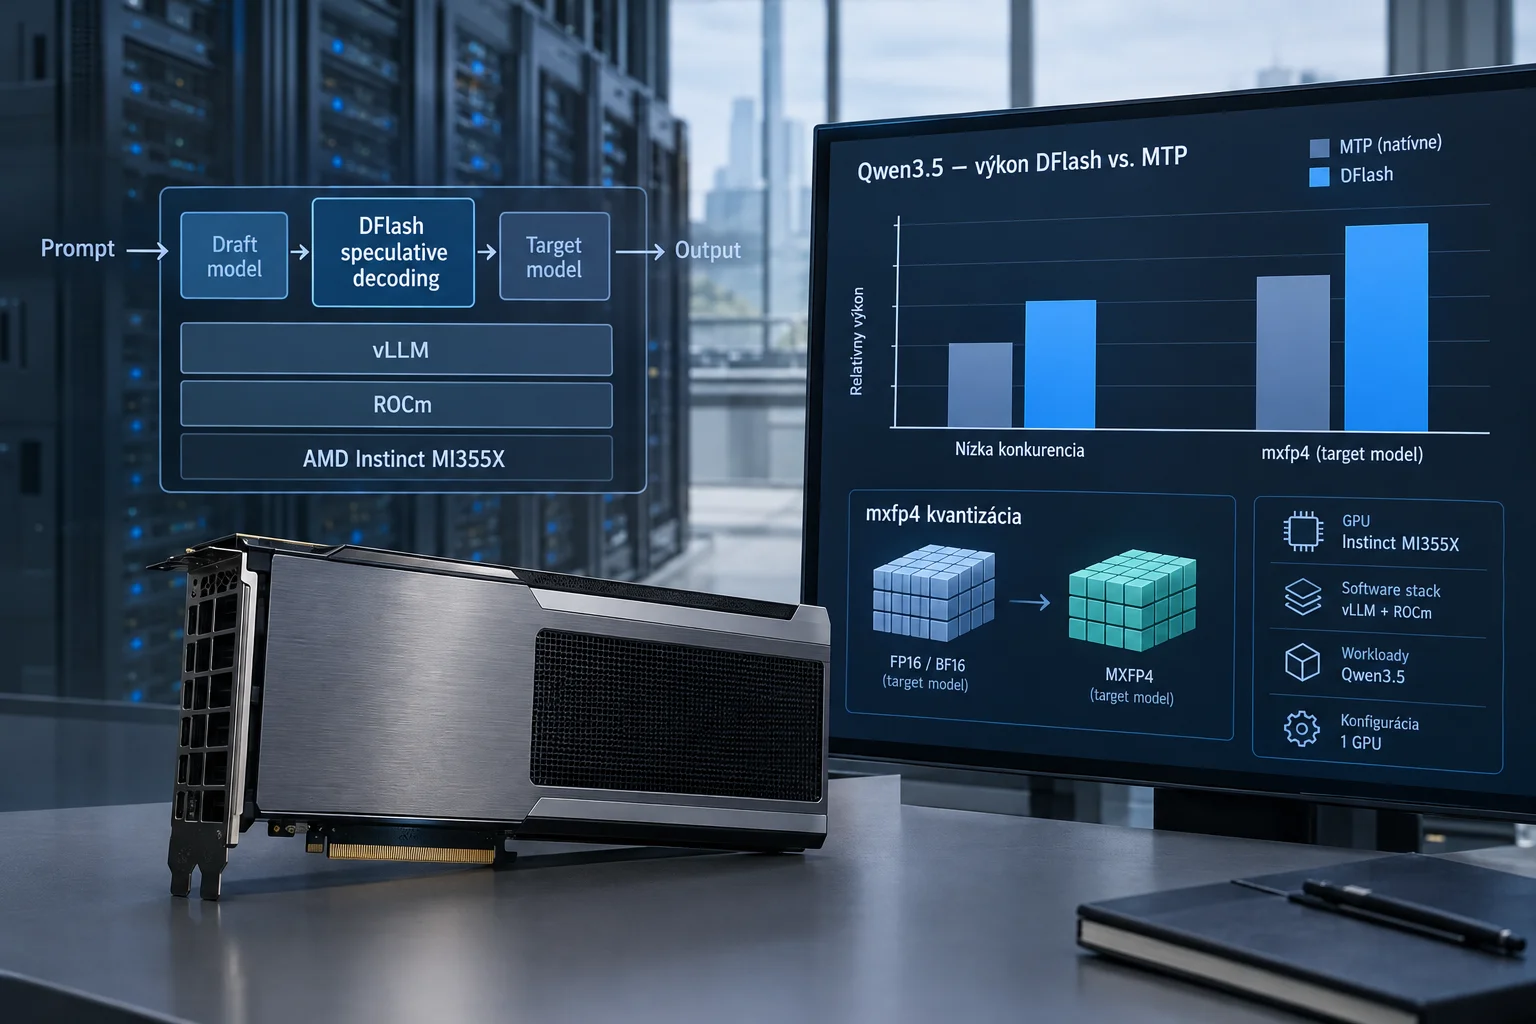
AMD opísalo DFlash vo vLLM na MI355X: na Qwen3.5 porovnáva vyšší výkon než MTP a ďalší zisk s mxfp4
AMD vo firemnom technickom blogu z 16. septembra 2026 popisuje nasadenie DFlash speculative decoding vo vLLM na ROCm pre GPU Instinct MI355X. Podľa benchmarkov výrobcu na modeloch Qwen3.5 DFlash pri nízkej konkurencii prekonáva natívne MTP a pri mxfp4 kvantizácii target modelu sa výkon ďalej zvyšuje, no bez nezávislého overenia a len pre uvedený softvérový stack, workloady a jednu GPU konfiguráciu.