AMD v blogu ROCm vysvetľuje Advanced Thread Trace v rocprofv3 pre profilovanie GPU kernelov
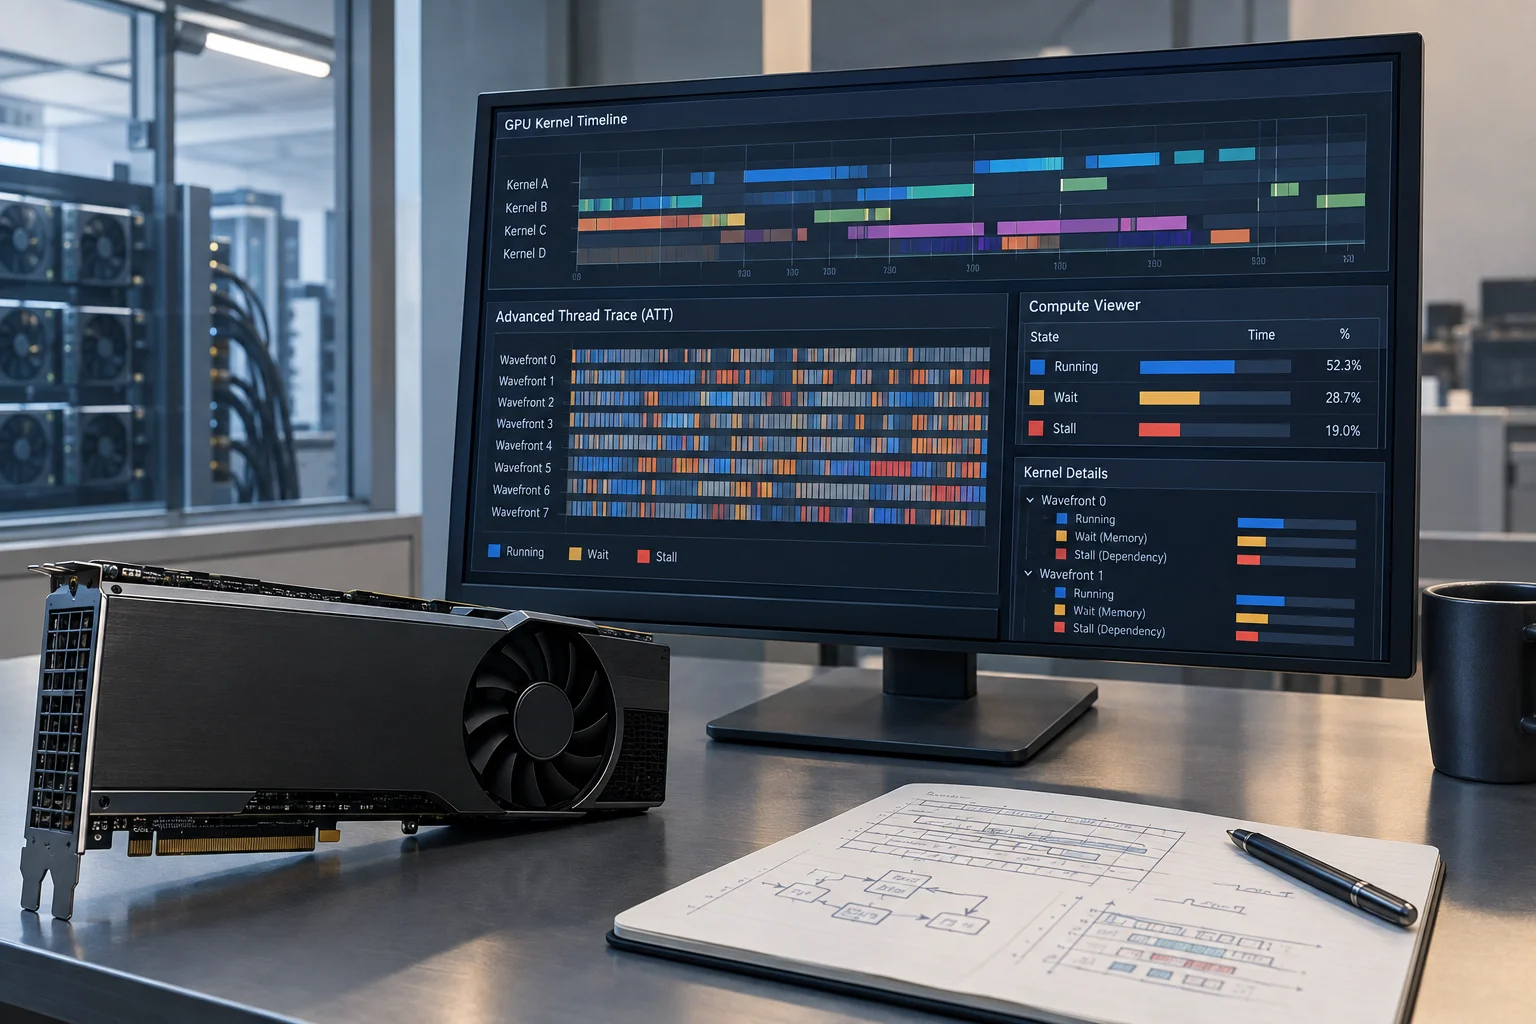
AMD 22. septembra 2026 publikovalo šiesty diel série o profilovaní GPU, zameraný na Advanced Thread Trace v nástroji rocprofv3. Text vysvetľuje, kedy má ATT zmysel, ako čítať stavy wait a stall v ROCprof Compute Viewer a aké hranice má tento nízkoúrovňový pohľad pri ladení kernelov na GPU AMD.
Hlavné poznatky
- ATT v rocprofv3 je podľa AMD nástroj na nízkoúrovňové vysvetlenie správania konkrétneho GPU kernelu, nie všeobecný benchmark výkonu.
- Blog odlišuje stavy wait a stall a ukazuje, že ATT má zmysel po predchádzajúcom zúžení problému vyššími profilermi.
- Podľa AMD je ATT podporované na Instinct MI200/MI300 a Radeon gfx10/gfx11/gfx12; pre popisovaný workflow odporúča ROCm 7.13+.
- Príklady a interpretácie pochádzajú od výrobcu, sú viazané najmä na DGEMM a MI250X a nemajú charakter nezávislého overenia.
Čo AMD zverejnilo
AMD 22. septembra 2026 zverejnilo šiesty diel série Performance Profiling on AMD GPUs, tentoraz venovaný funkcii Advanced Thread Trace (ATT) v nástroji rocprofv3. Podľa textu ide o nízkoúrovňové trasovanie vykonávania wavefrontov na úrovni jednotlivých inštrukcií pre jedno spustenie kernelu alebo len niekoľko jeho behov. Blog ATT nepredstavuje ako nový hardvér ani nezávisle overený benchmark, ale ako odborný návod, ktorý má pomôcť vysvetliť, prečo sa konkrétny kernel na GPU správa výkonnostne určitým spôsobom.
Kedy má ATT podľa AMD zmysel
AMD ATT odporúča skôr pre pokročilých používateľov, ktorí už rozumejú architektúre AMD GPU, plánovaniu, occupancy a aspoň čiastočne aj assembleru. V texte sa výslovne píše, že ATT je vhodné nasadiť až vtedy, keď vyššie vrstvy profilovania, ako rocprof-compute alebo rocprof-sys, už ukázali problémový kernel, ale samy neposkytli jasné vysvetlenie príčiny výkonu. Praktický význam je teda v tom, že ATT neprináša všeobecné zrýchlenie samo osebe, ale pomáha potvrdiť alebo vyvrátiť hypotézu o úzkom hrdle konkrétneho kernelu.
Workflow, ktorý blog opisuje, má tri kroky: zber dát cez thread trace service API v ROCprofiler-SDK, dekódovanie cez ROCprof Trace Decoder API a vizualizáciu v ROCprof Compute Viewer. AMD zároveň upozorňuje, že pri dlho bežiacich kerneloch môže ATT zhromaždiť príliš veľa dát a rocprofv3 môže hlásiť stratu časti trás; v takom prípade odporúča zúžiť zber napríklad na konkrétne iterácie alebo názvy kernelov.
Čo ukazujú príklady DGEMM
Mechanizmus blog vysvetľuje na štyroch implementáciách DGEMM: naivnej verzii, variante s unrollingom, verzii s LDS a kerneli z rocBLAS. Na testovacom systéme s GPU AMD Instinct MI250X ukazuje, že naivný kernel je podľa autorov výrazne viazaný na pamäť a veľkú časť času trávi čakaním na dokončenie pamäťových operácií cez s_waitcnt. ATT tu pomáha rozlíšiť stav „wait“ od stavu „stall“: „wait“ reprezentuje explicitné čakanie na synchronizačný bod, kým „stall“ vzniká pre hazardy, závislosti alebo latenciu pamäte.
Pri unrollingu sa podľa AMD zvýši počet požiadaviek na pamäť „in flight“, takže hotspot sa presúva viac k pamäťovým inštrukciám. Pri použití LDS sa znižujú redundantné a nekoalesované prístupy do globálnej pamäte; časť čakania sa však presúva k bariéram __syncthreads(). V ukážke s rocBLAS blog tvrdí, že kernel cielene používa nižšiu occupancy, aby mal viac registrov na wave, a latenciu skrýva prekrývaním prenosov dát a výpočtu.
Doložená použiteľnosť a limity
Z textu vyplýva, že ATT je už dostupná schopnosť v rámci rocprofv3, nie iba plán: AMD uvádza podporu pre AMD Instinct MI200 a MI300 aj Radeon gfx10, gfx11 a gfx12. Pre nástroje použité v blogu odporúča ROCm 7.13 alebo novší, pričom ATT má byť podporované od ROCm 7.2.0. Zároveň však treba brať vážne hranice zdroja: ide o primárny materiál výrobcu, výsledky sú demonštrované najmä na DGEMM a MI250X a autori výslovne píšu, že výsledky nemusia byť úplne reprodukovateľné na iných konfiguráciách. AI workloady sa v tomto diele neskúmajú; AMD ich spomína len ako plánovanú tému budúcich pokračovaní.
Technický kontext
**Stav overenia: **Spracované podľa zdroja; redakcia postup nereprodukovala.
**Verzie: **ROCm 7.13+, ROCm 7.2.0+
**Dátum pôvodného zdroja: **22. septembra 2026
**Podmienky použitia: **Použitie ATT predpokladá znalosť AMD GPU architektúry, plánovania, occupancy a čítania assembleru. Blog odporúča nasadiť ATT po tom, čo vyššie profilery ako rocprof-compute alebo rocprof-sys identifikovali kernel na ďalšie skúmanie.
**Obmedzenia: **Zdroj je technický blog výrobcu, nie nezávislé porovnanie. Príklady sú na DGEMM a MI250X a AMD uvádza, že výsledky nemusia byť plne reprodukovateľné. ATT profiluje jedno alebo len niekoľko spustení kernelu a pri dlhých kerneloch môže dôjsť k strate časti trás.
Pôvodné zdroje uvedené v archíve
Zdroje
Súvisiace
Ďalšie články k téme
AMD zverejnilo postup pre custom diffusion attention kernel vo FlyDSL na ROCm
AMD na blogu ROCm publikovalo technický rozbor, ako vo FlyDSL navrhnúť a ladiť vlastný diffusion attention kernel pre AMD GPU. Text prináša konkrétne odporúčania pre debug, profiling, MFMA layout, prácu s registrami, LDS aj JIT kompiláciu, no neobsahuje nezávisle overené benchmarky ani kvantifikované výsledky.
AMD sprístupnilo veRL na ROCm pre Instinct GPU a ukázalo firemné merania na MI300 a MI350/MI355
AMD vo firemnom blogu z 8. septembra 2026 opisuje podporu frameworku veRL pre RL post-training na ROCm a GPU Instinct. Novinkou je pripravený kontajner, podpora rollout backendov vLLM a SGLang s AITER a séria výrobcom nameraných validačných behov na MI300 a MI350/MI355. Ide o odborný rozbor primárneho zdroja výrobcu, nie o nezávislé potvrdenie výkonu ani „production-ready“ tvrdení.
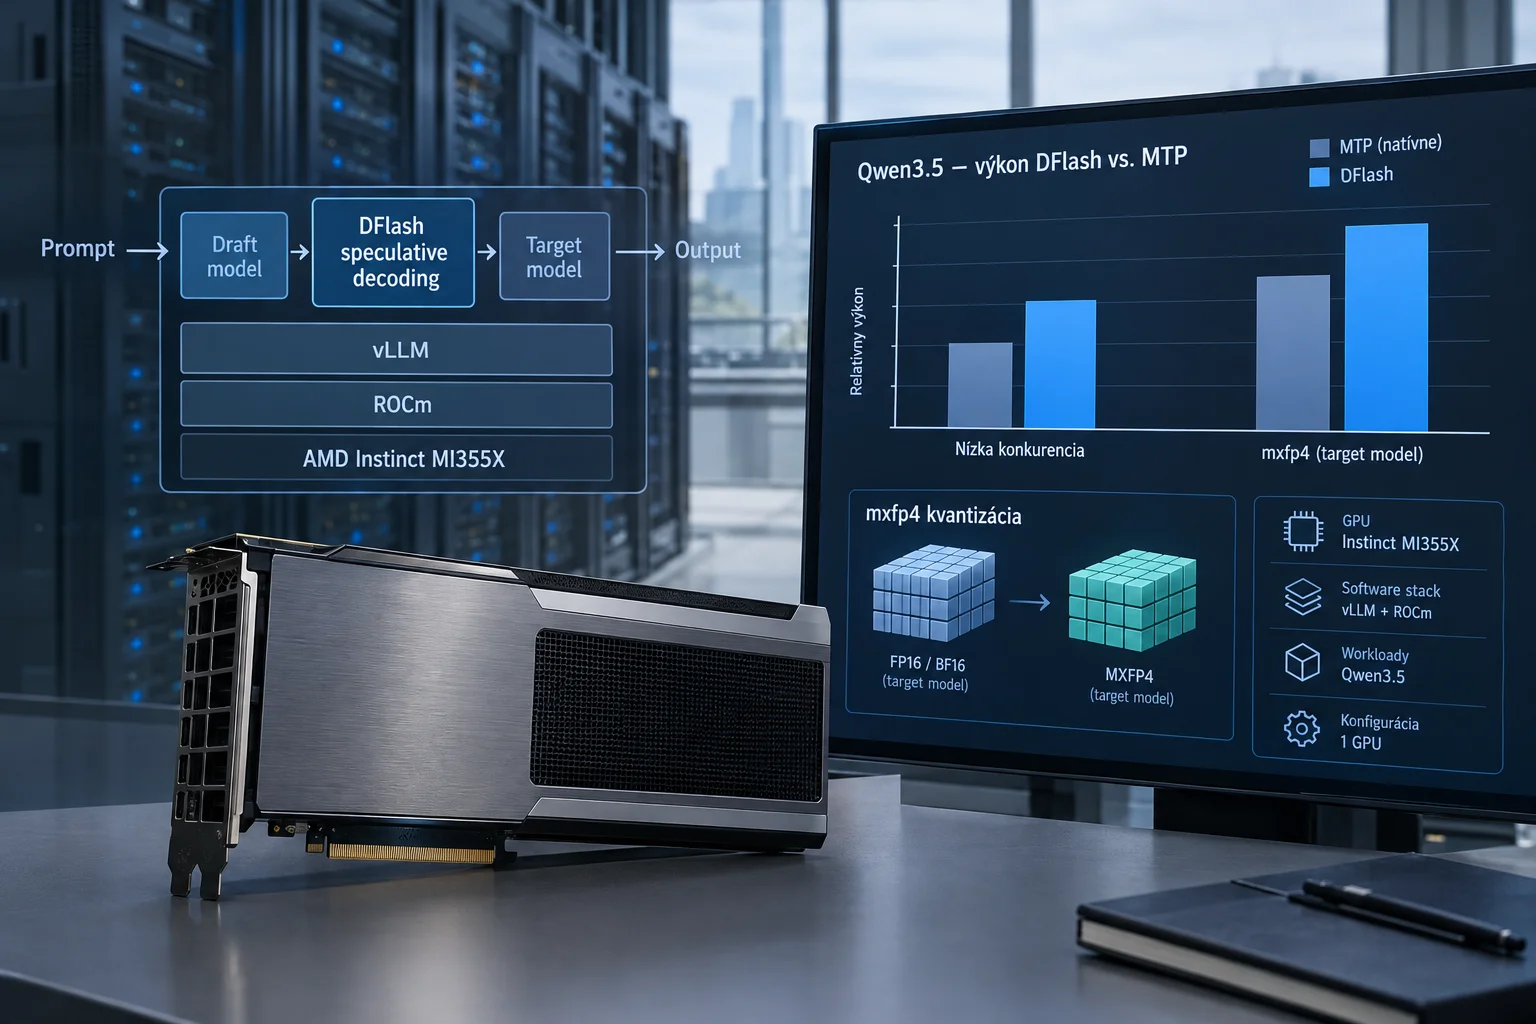
AMD opísalo DFlash vo vLLM na MI355X: na Qwen3.5 porovnáva vyšší výkon než MTP a ďalší zisk s mxfp4
AMD vo firemnom technickom blogu z 16. septembra 2026 popisuje nasadenie DFlash speculative decoding vo vLLM na ROCm pre GPU Instinct MI355X. Podľa benchmarkov výrobcu na modeloch Qwen3.5 DFlash pri nízkej konkurencii prekonáva natívne MTP a pri mxfp4 kvantizácii target modelu sa výkon ďalej zvyšuje, no bez nezávislého overenia a len pre uvedený softvérový stack, workloady a jednu GPU konfiguráciu.
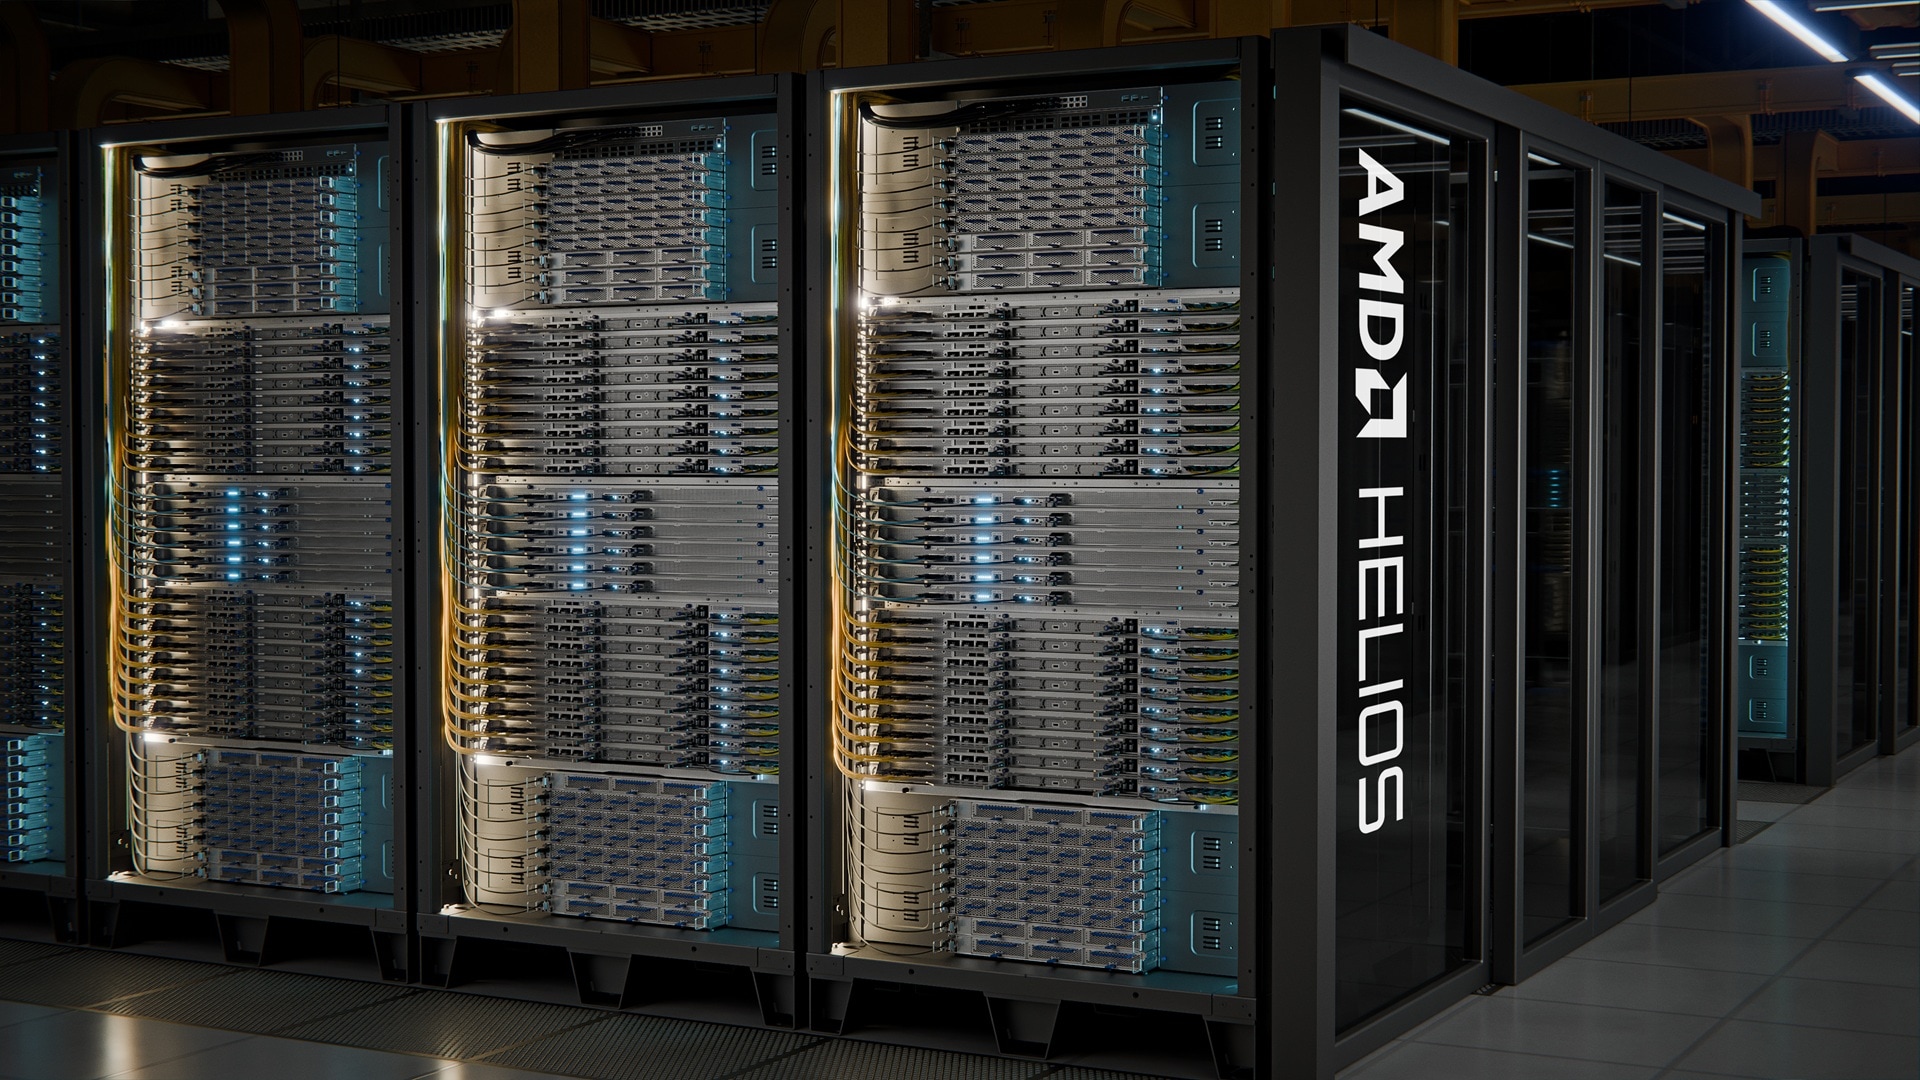
AMD Helios spája GPU, procesory a sieť do jedného AI racku
Pri Heliose AMD predstavuje celý výpočtový celok vrátane siete, chladenia a softvéru. Októbrové materiály ukazujú postup od návrhu cez záťažové skúšky po zákaznícku validáciu.