Zephon udrží poradie tréningových dát aj po zmene počtu GPU
Dátový loader pre TorchTitan rieši skrytý problém experimentov: iné rozdelenie výpočtu môže modelu predložiť iné dáta.
Keď experiment zmení viac než jednu vec
Pri porovnávaní tréningových postupov chce tím meniť napríklad zloženie dát, nie zároveň ich poradie. Lenže po obnovení tréningu na inom počte GPU môže bežný loader rozložiť vzorky inak. Výsledný rozdiel sa potom ľahko pripíše novej metóde, hoci časť zmeny spôsobila infraštruktúra.
Príspevok tímu Zephon na webe PyTorch zo 16. októbra opisuje integráciu do TorchTitan, ktorá má tento problém obmedziť. Systém oddeľuje plán poradia a miešania dát od paralelných operácií, ktoré ich pripravujú pre tréning.
Rovnaké globálne dávky po reštarte
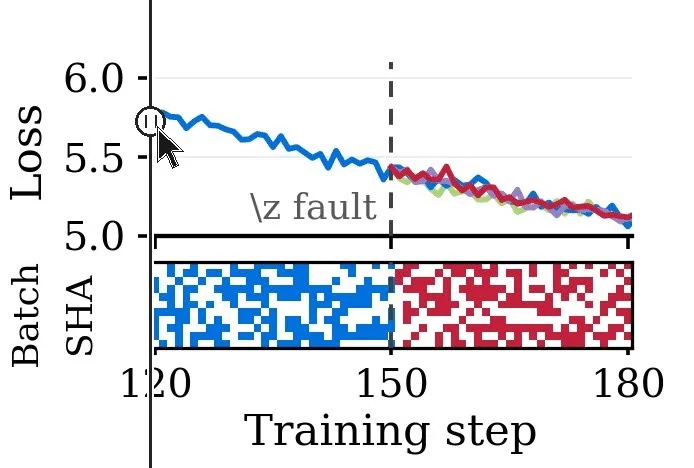
Autori ukazujú tréning modelu s miliardou parametrov na 16 GPU. Zo stavu uloženého v kroku 150 pokračujú na 8, 32 a 64 GPU. Pri Zephone sa zhodujú kontrolné súčty SHA-256 každej globálnej dátovej dávky s pôvodným behom. To je konkrétna kontrola toho, aké vstupy model dostal, nie iba vizuálna podobnosť grafov.
Základ tvorí popis datasetov, WorkSource určujúci ich miešanie a Pipeline pripravujúca tenzory. Tokenizácia, balenie a premiešavanie prebiehajú počas tréningu na CPU. Tím tak nemusí pre každú zmenu experimentu vyrábať ďalšiu kompletnú predspracovanú kópiu korpusu.
Deterministické dáta sú jedna vrstva spoľahlivosti
Zephon cieli na reprodukovateľné dátové dávky pri pružnom prideľovaní výpočtu. Z toho nemožno automaticky odvodiť bitovo identický celý tréning: numerické operácie, knižnice a konfigurácia distribuovaného systému sú ďalšie premenné. Aj pri rovnakej sekvencii dát treba evidovať verzie a nastavenia.
Pre tím používajúci agentov na automatické experimenty je takáto kontrola zvlášť užitočná. Agent môže spustiť množstvo porovnaní, no nesprávne pripísanie výsledku sa iba rýchlejšie zopakuje. Pred nasadením je vhodné skúsiť obnovenie z checkpointu na inom počte zariadení, overiť hashe dávok a sledovať, či príprava dát nebrzdí GPU. Verejný integračný repozitár poskytuje konkrétny východiskový postup, nie náhradu tohto overenia.
Samostatnú pozornosť si zaslúži aj význam miešacích pomerov. Ukážkový postup pracuje s pomerom tokenov, nie s jednoduchým počtom dokumentov. Dve zbierky môžu mať veľmi rozdielne dĺžky záznamov, takže rovnaký počet vzoriek nepredstavuje rovnaký tréningový podiel. Oddelenie plánu a spracovania umožňuje túto voľbu vyjadriť explicitne a pri experimentoch meniť zloženie dát bez prestavby celej prípravnej časti tréningu.
Technický kontext
Stav overenia: Spracované podľa zdroja; redakcia postup nereprodukovala.
Verzie: Zdroj neuvádza konkrétne verzie.
Podmienky použitia: Použitie závisí od konkrétnej konfigurácie a dokumentácie uvedenej v zdrojoch.
Obmedzenia: Redakcia nereprodukovala testy dodávateľov; staršie udalosti sú v texte datované.
Zdroje
Súvisiace
Ďalšie články k téme
Google opísal autofinetune na Cloud TPU: agentické post-training slučky pre SFT a GRPO
Google Developers Blog 11. septembra 2026 predstavil projekt autofinetune: agentický workflow pre post-training LLM na Cloud TPU s Tunix, Gemma a pomocnými nástrojmi. Podklad ukazuje mechanizmus automatizovaných experimentov pre SFT aj GRPO, no výkonové zlepšenia sú doložené len ako tvrdenia pôvodcu v ukážkových behoch.
Muse Spark Open: otvorené váhy veľkého multimodálneho modelu potrebujú veľkú infraštruktúru
Hugging Face rozoberá architektúru modelu Meta aj podporované spúšťanie. Miliónový kontext má výraznú pamäťovú cenu.
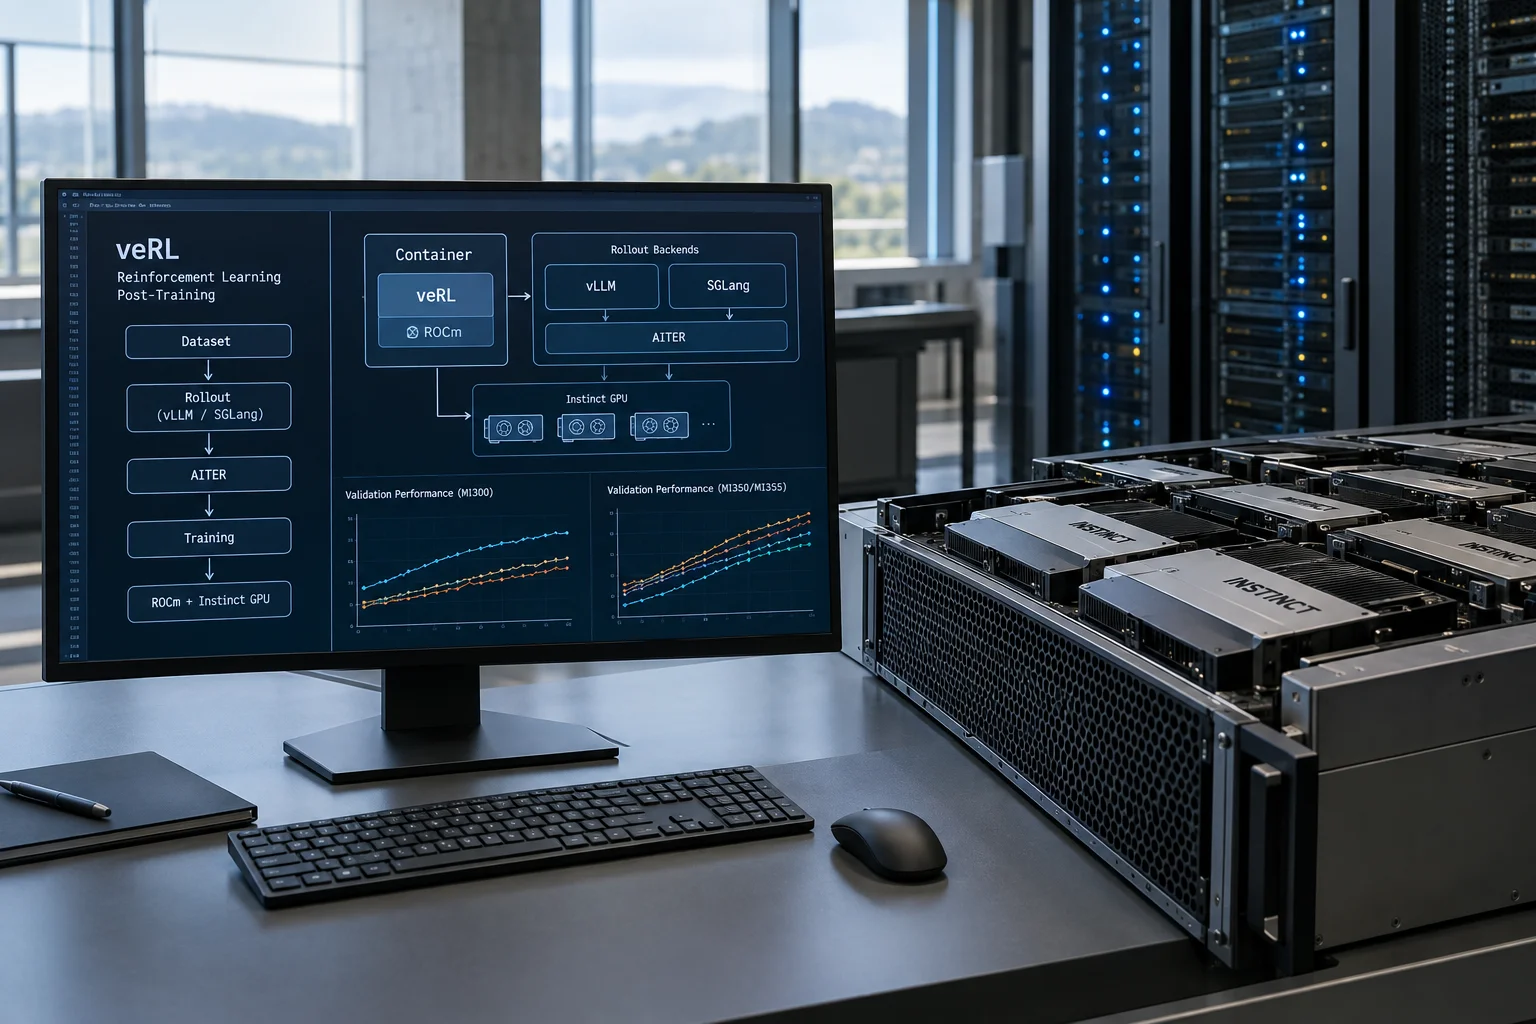
AMD sprístupnilo veRL na ROCm pre Instinct GPU a ukázalo firemné merania na MI300 a MI350/MI355
AMD vo firemnom blogu z 8. septembra 2026 opisuje podporu frameworku veRL pre RL post-training na ROCm a GPU Instinct. Novinkou je pripravený kontajner, podpora rollout backendov vLLM a SGLang s AITER a séria výrobcom nameraných validačných behov na MI300 a MI350/MI355. Ide o odborný rozbor primárneho zdroja výrobcu, nie o nezávislé potvrdenie výkonu ani „production-ready“ tvrdení.
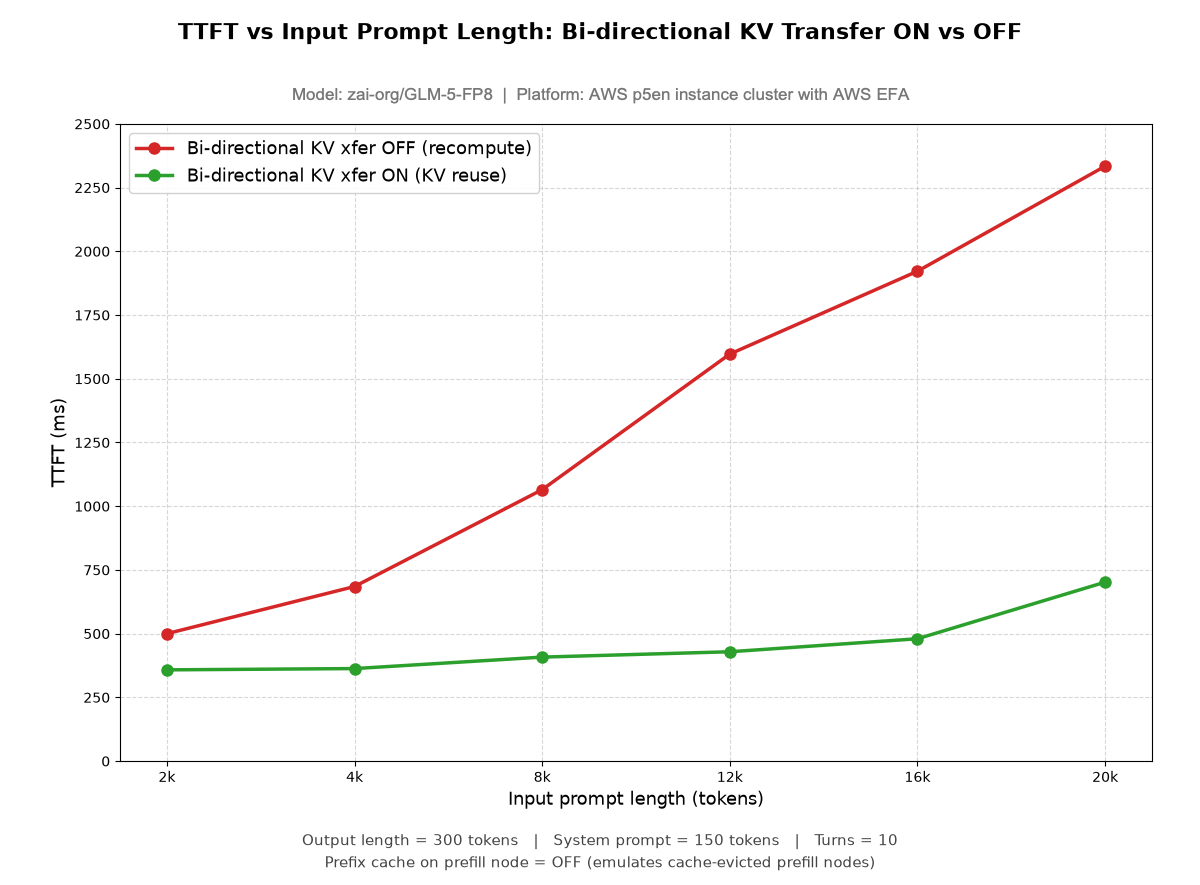
vLLM vracia kontext späť medzi uzlami, aby agent nemusel stále začínať odznova
Obojstranný prenos KV cache cieli na viacťahové konverzácie pri oddelenom spracovaní vstupu a generovaní. Merania ukazujú prínos, ale aj závislosť od dĺžky kontextu a siete.