PyTorch pridáva FlyDSL na AMD MI350: kde sa backend vyberá a kedy zrýchli existujúce API
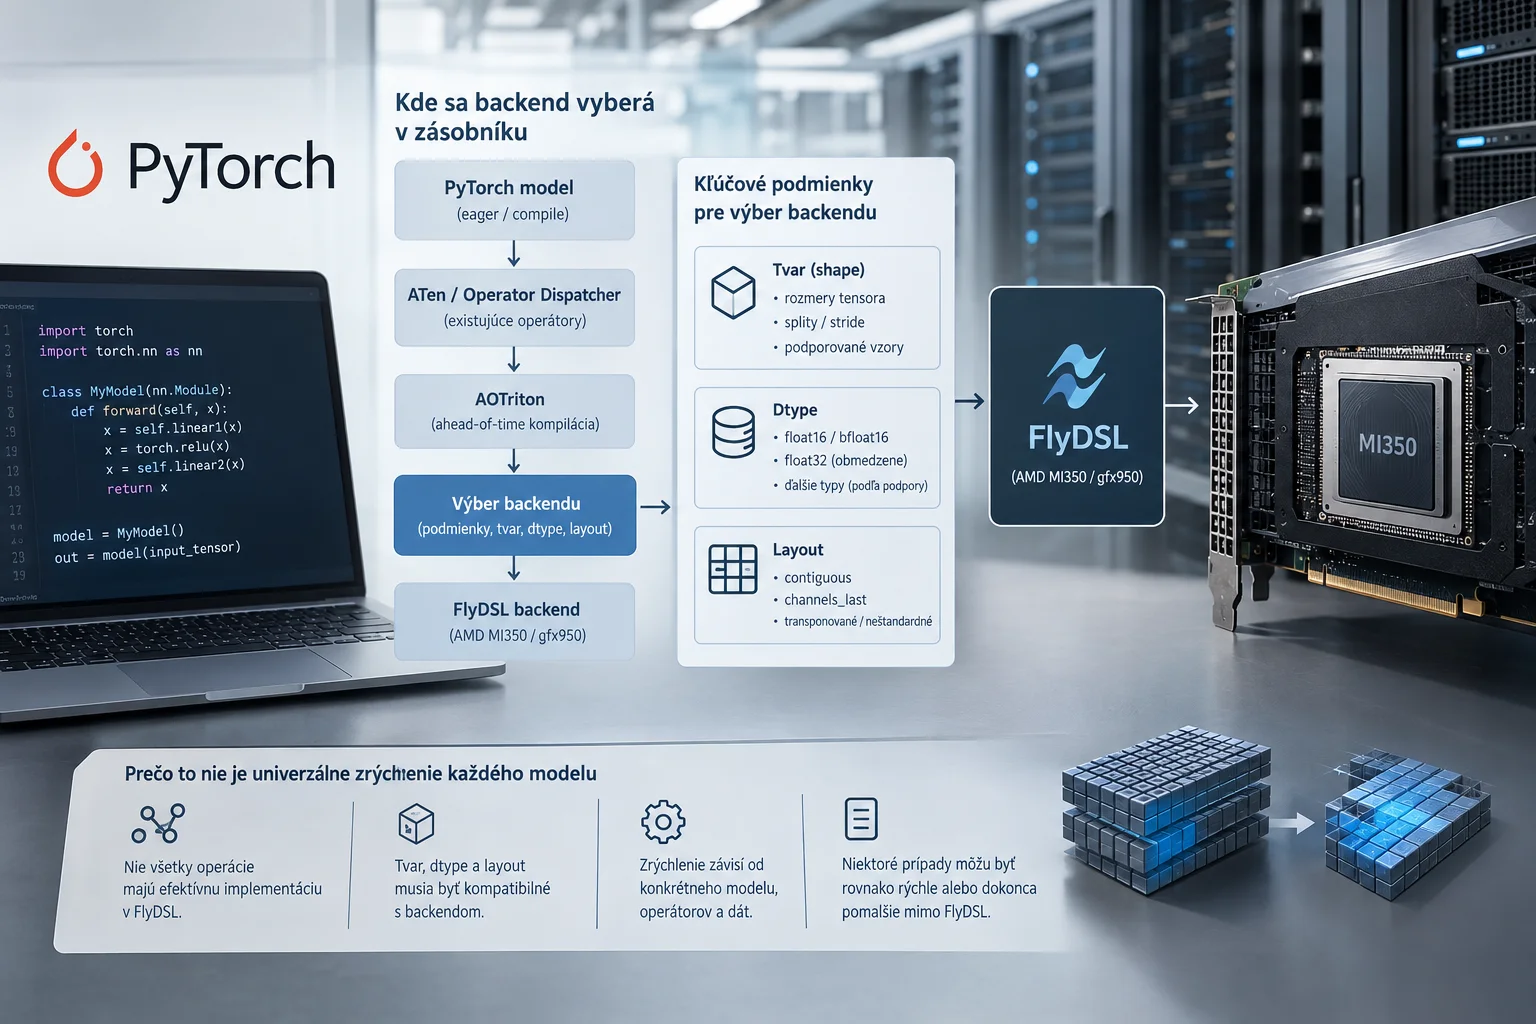
PyTorch podľa oficiálneho technického blogu sprístupňuje na AMD MI350/gfx950 backend FlyDSL cez existujúce operátory a AOTriton. Dôležité nie je len tvrdenie o zrýchlení, ale aj to, kde sa backend v zásobníku vyberá, aké má podmienky tvaru, dtype a layoutu a prečo to nie je univerzálne zrýchlenie každého modelu.
Hlavné poznatky
- FlyDSL sa v PyTorch pripája ako dodatočný backend k existujúcim operátorom, nie ako nové verejné API.
- Rozhodujúci je integračný bod: eager dispatch pre RMSNorm a TopK, TorchInductor pre GEMM a AOTriton pre SDPA.
- Prínos závisí od podporovaného hardvéru, dtype, layoutu a tvaru; pri nevyhovujúcich vstupoch zostávajú pôvodné implementácie.
- Publikované zrýchlenia sú z oficiálneho blogu PyTorch a treba ich čítať ako merania za konkrétnych podmienok, nie ako univerzálny priemer.
Čo sa v PyTorch mení na AMD MI350
PyTorch podľa svojho technického blogu pripája FlyDSL k existujúcim API tak, aby aplikácie nemuseli volať vlastné kernely. Na AMD MI350-series GPU s architektúrou gfx950 sa to týka dense a grouped GEMM, scaled GEMM pre MXFP8 a MXFP4, RMSNorm, TopK a cez AOTriton aj attention v F.scaled_dot_product_attention. Prakticky to znamená, že zmena nespočíva v novom verejnom rozhraní, ale v ďalšom backende, ktorý môže PyTorch použiť pri podporovaných workloadoch. Podľa dokumentácie PyTorch je táto cesta viazaná na preview/nightly buildy a pri časti funkcionality aj na voliteľný runtime flydsl z vetvy 0.3.x, takže nejde o všeobecne opísanú stabilnú cestu pre všetky inštalácie.
Kde sa backend vyberá a prečo je to dôležité
Najdôležitejší mechanizmus je, že FlyDSL nevymieňa celé správanie PyTorch, ale pridáva sa ako kandidát do už existujúcich integračných bodov. Pri eager režime sa podľa blogu podporované volania F.rms_norm a torch.topk môžu automaticky dispatchovať na FlyDSL, ak je backend dostupný, povolený a sú splnené podmienky vstupu; inak zostáva pôvodná implementácia ATen. Pri torch.compile TorchInductor najprv vyfiltruje vhodné dense, grouped a MXFP GEMM workloady, následne benchmarkuje FlyDSL vedľa ATen a Triton, víťaza uloží do cache a spustí najrýchlejší nameraný kernel pre dané zaťaženie. Attention ide inou cestou: F.scaled_dot_product_attention volá AOTriton, ktorý podľa tuning databázy vyberá medzi FlyDSL, Triton a AITER ASM. Praktický význam pre infra tím je v tom, že prínos nezávisí iba od jedného prepínača, ale od konkrétneho operátora, tvaru tensorov, layoutu a od toho, či daný model trávi podstatnú časť času práve v podporovaných operáciách.
Pre dense a grouped GEMM príklad v zdroji výslovne pridáva FlyDSL medzi kandidátov cez import torch._inductor.config as config, config.max_autotune_gemm_backends = "ATEN,TRITON,FLYDSL" a config.flydsl_enable_autotuning = True; kompilovaný výpočet používa torch.compile(mode="max-autotune"). Rovnaké nastavenia zdroj používa aj pre podporované MXFP scaled GEMM. Tieto voľby nezaručujú výber FlyDSL: podľa merania môže vyhrať ATen alebo Triton. Ide o nastavenia Inductora citlivé na verziu nightly, nie o univerzálny prepínač pre eager operácie alebo attention cez AOTriton.
Aké sú podmienky a hranice podpory
Podpora je úzko vymedzená. Blog uvádza cieľ AMD MI350-series s architektúrou gfx950. Dense GEMM a grouped GEMM sú dostupné cez torch.compile, RMSNorm a TopK v eager režime, attention cez AOTriton a MXFP scaled GEMM vyžaduje už kvantizované operandy aj scale tensory. Pri MXFP ceste platí viac obmedzení naraz: používa sa verejné API F.scaled_mm, podporené sú formáty MXFP8 a MXFP4, akumulácia je vo FP32, výstup je FP16 alebo BF16 a redukčný rozmer K musí byť násobkom 128. Navyše Inductor pri tomto type GEMM pred výberom backendu vyžaduje unit stride pozdĺž K pre A aj B, teda v praxi row-major A a column-major B; pri nekompatibilnom vstupe môže vložiť layout copy. Pri attention je výslovne uvedené, že táto vetva nepodporuje FP32, a torch.nn.attention.flex_attention ide vlastnou Triton cestou, nie cez AOTriton. To sú hranice, ktoré rozhodujú, či sa zmena prejaví bez zásahu do modelu, alebo si vynúti úpravu pipeline.
Čo hovoria publikované zrýchlenia a ako ich čítať
PyTorch v blogu publikuje vlastné merania na MI355X/gfx950. Na úrovni operátorov uvádza geometrický priemer zrýchlenia 1,10× pre BF16 dense GEMM oproti rýchlejšiemu z ATen a Triton pri každom tvare, 1,20× pre grouped GEMM oproti Triton, 1,58× pre MXFP8 a 1,68× pre MXFP4 scaled GEMM oproti ATen, pri RMSNorm približne 1,17× až 3,66× podľa prípadov a pre malé K pri TopK 4,82× oproti ATen s vypnutou deterministickou voľbou. Samotný blog zároveň upozorňuje, že ide o kernel-level benchmarky, nie o end-to-end latenciu modelu, a pri attention porovnanie verzie AOTriton 0.14.2b proti 0.13b nezachytáva izolovane iba vplyv FlyDSL, ale aj ďalšie zmeny v Triton, AITER a tuning databázach. V end-to-end A/B testoch vLLM na jednom MI355X s pevnou konfiguráciou autor uvádza zrýchlenie celej požiadavky až 1,13× pre BF16, 2,04× pre MXFP8 a 3,01× pre MXFP4, pričom výsledok závisel od modelu a konkurencie požiadaviek. Pre čitateľa je teda podstatné, že ide o doložený mechanizmus s konkrétnymi podmienkami, nie o sľub plošného zrýchlenia každého PyTorch workloadu.
Technický kontext
Stav overenia: Spracované podľa zdroja; redakcia postup nereprodukovala.
Verzie: AOTriton 0.14.2b, AOTriton 0.13b, flydsl 0.3.x, PyTorch preview/nightly
Podmienky použitia: Vyžaduje sa ROCm-capable prostredie s AMD MI350-series GPU (gfx950). Pre časť funkcionality treba recent ROCm PyTorch nightly; pre eager RMSNorm/TopK a GEMM backend je v blogu uvedený aj voliteľný balík flydsl >=0.3.0,<0.4. SDPA cesta potrebuje PyTorch build naviazaný na AOTriton 0.14.2b alebo novší. Pre GEMM príklady treba výslovne povoliť FlyDSL ako kandidáta v Inductore (`config.max_autotune_gemm_backends = "ATEN,TRITON,FLYDSL"`, `config.flydsl_enable_autotuning = True`) a použiť `torch.compile(mode="max-autotune")`; tieto nightly voľby sa môžu meniť a nenahrádzajú samostatné podmienky eager/SDPA cesty.
Obmedzenia: Podpora je obmedzená na vybrané operácie, dtype a layouty. MXFP scaled GEMM vyžaduje už kvantizované vstupy, block scales a K násobok 128; attention v tejto vetve nepodporuje FP32; flex_attention nejde cez AOTriton. Výsledky výkonu sú zdrojovo podporené, nie nezávisle reprodukované v tomto balíku.
Zdroje
Súvisiace
Ďalšie články k téme
AMD zverejnilo postup pre custom diffusion attention kernel vo FlyDSL na ROCm
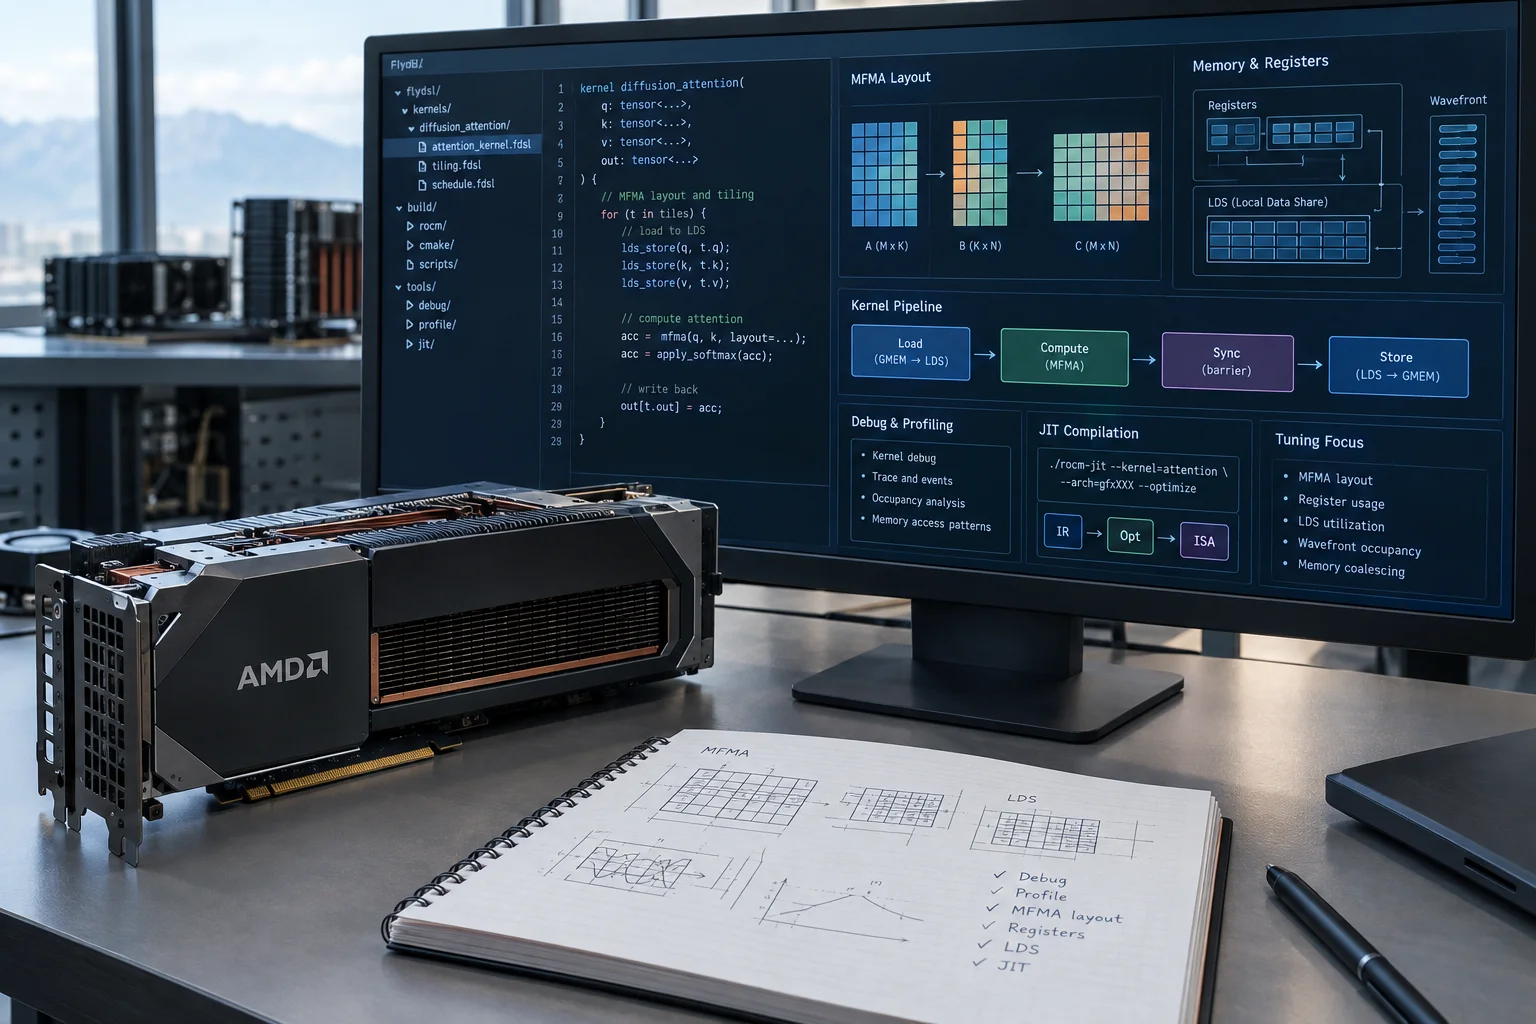
AMD na blogu ROCm publikovalo technický rozbor, ako vo FlyDSL navrhnúť a ladiť vlastný diffusion attention kernel pre AMD GPU. Text prináša konkrétne odporúčania pre debug, profiling, MFMA layout, prácu s registrami, LDS aj JIT kompiláciu, no neobsahuje nezávisle overené benchmarky ani kvantifikované výsledky.
AMD sprístupnilo veRL na ROCm pre Instinct GPU a ukázalo firemné merania na MI300 a MI350/MI355
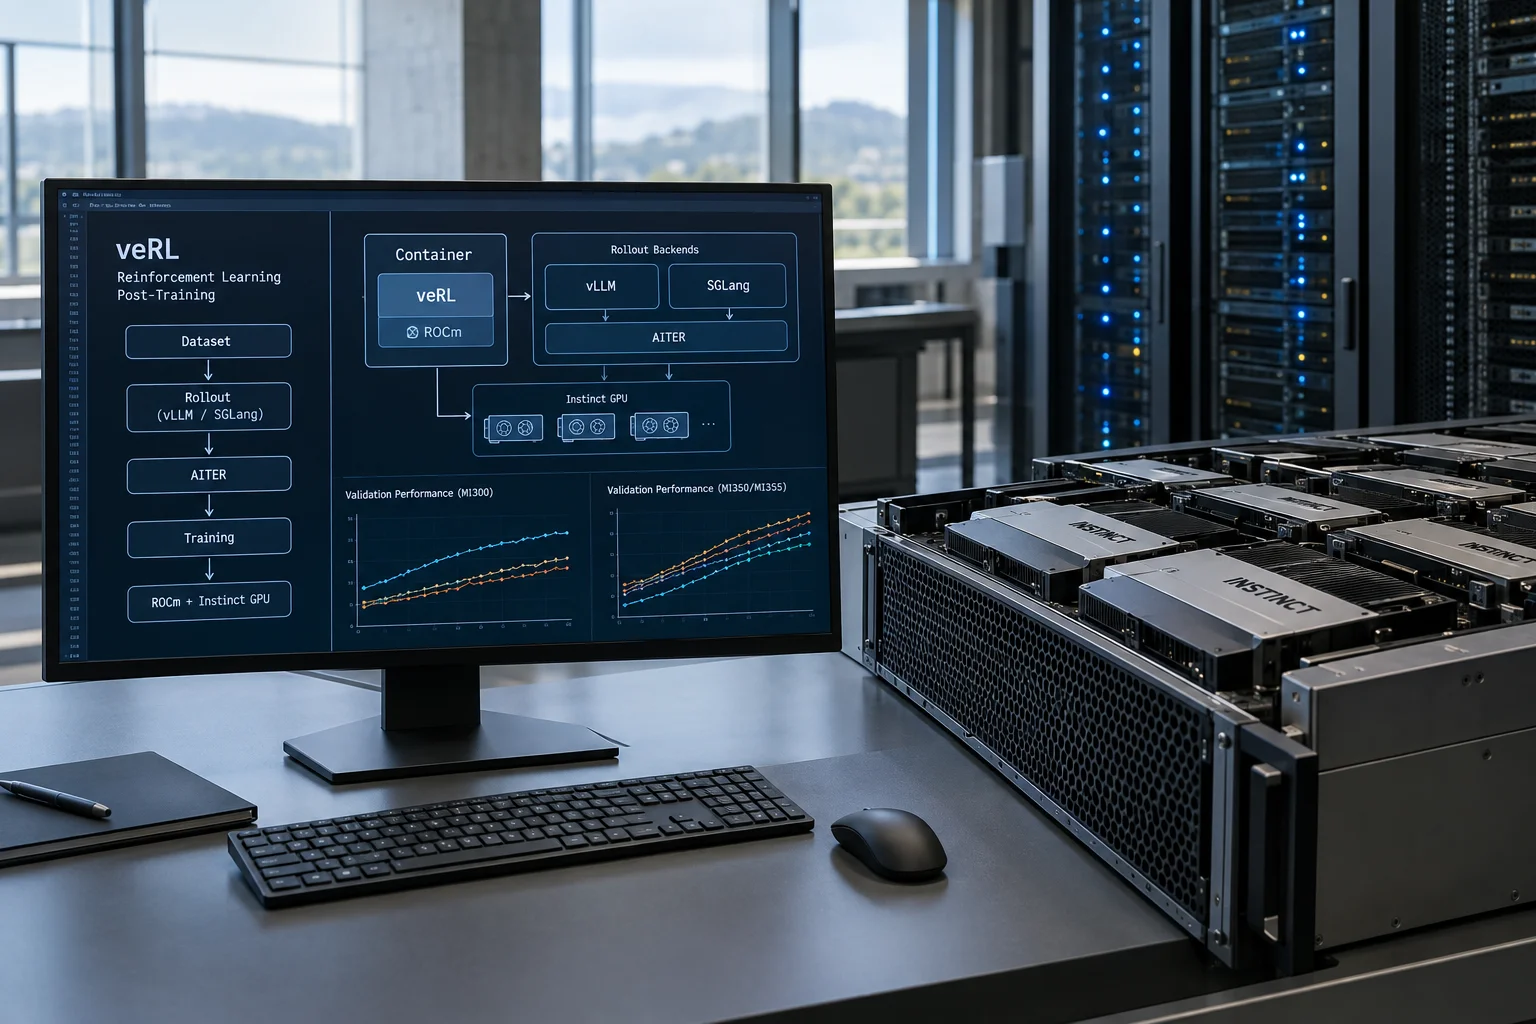
AMD vo firemnom blogu z 8. septembra 2026 opisuje podporu frameworku veRL pre RL post-training na ROCm a GPU Instinct. Novinkou je pripravený kontajner, podpora rollout backendov vLLM a SGLang s AITER a séria výrobcom nameraných validačných behov na MI300 a MI350/MI355. Ide o odborný rozbor primárneho zdroja výrobcu, nie o nezávislé potvrdenie výkonu ani „production-ready“ tvrdení.
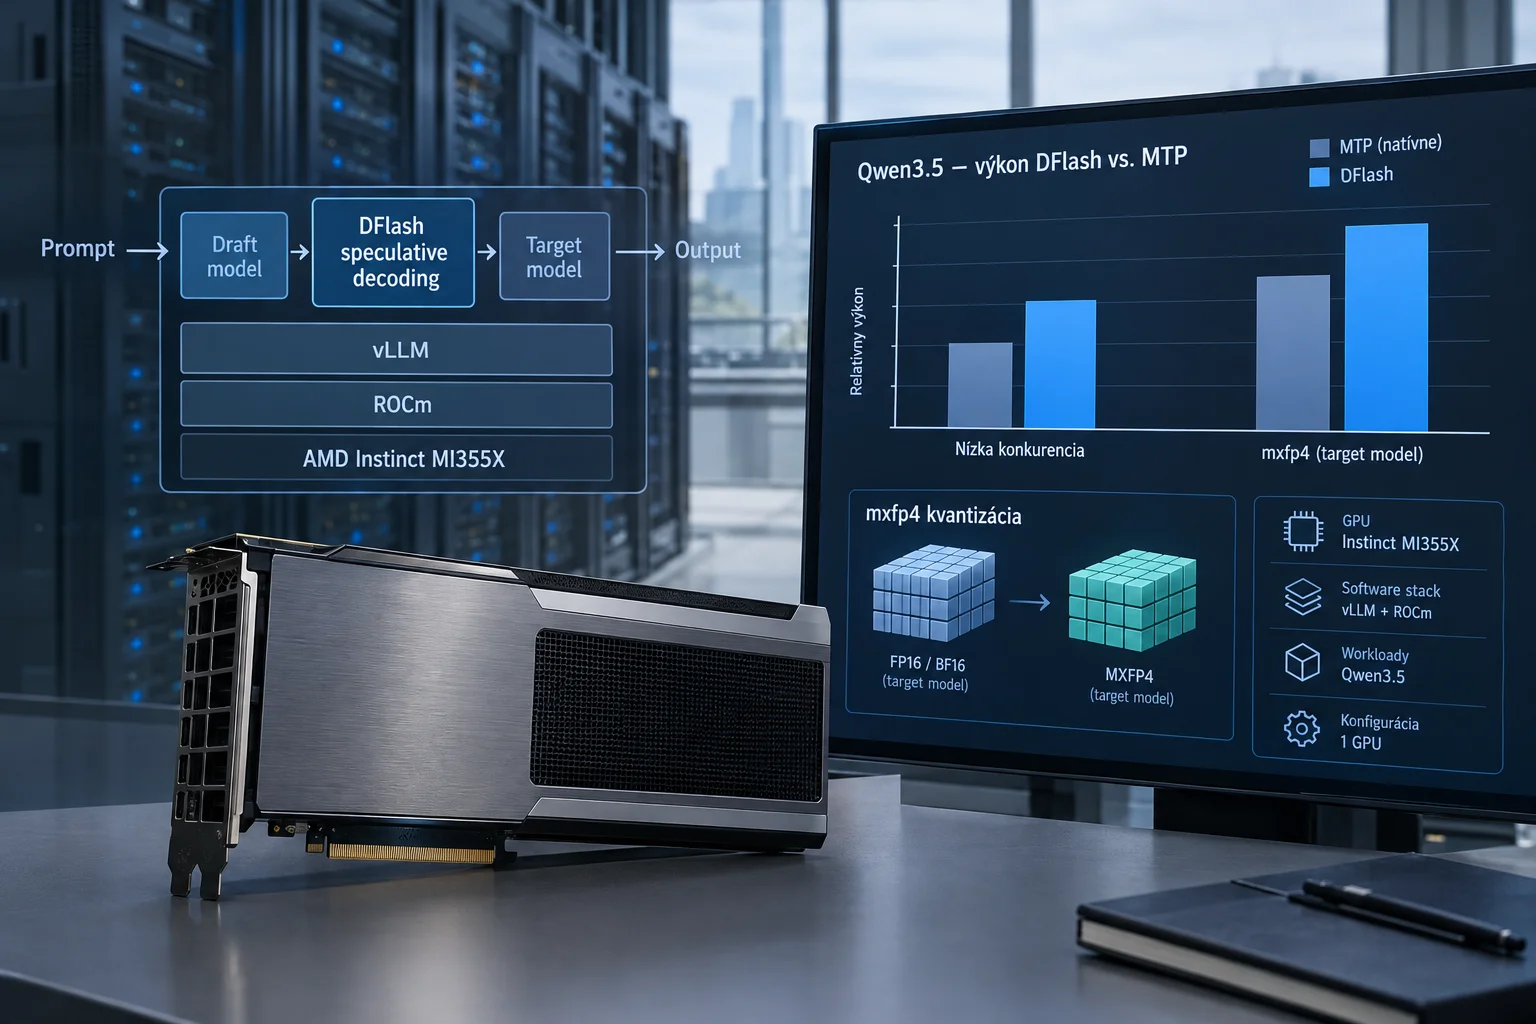
AMD opísalo DFlash vo vLLM na MI355X: na Qwen3.5 porovnáva vyšší výkon než MTP a ďalší zisk s mxfp4
AMD vo firemnom technickom blogu z 16. septembra 2026 popisuje nasadenie DFlash speculative decoding vo vLLM na ROCm pre GPU Instinct MI355X. Podľa benchmarkov výrobcu na modeloch Qwen3.5 DFlash pri nízkej konkurencii prekonáva natívne MTP a pri mxfp4 kvantizácii target modelu sa výkon ďalej zvyšuje, no bez nezávislého overenia a len pre uvedený softvérový stack, workloady a jednu GPU konfiguráciu.
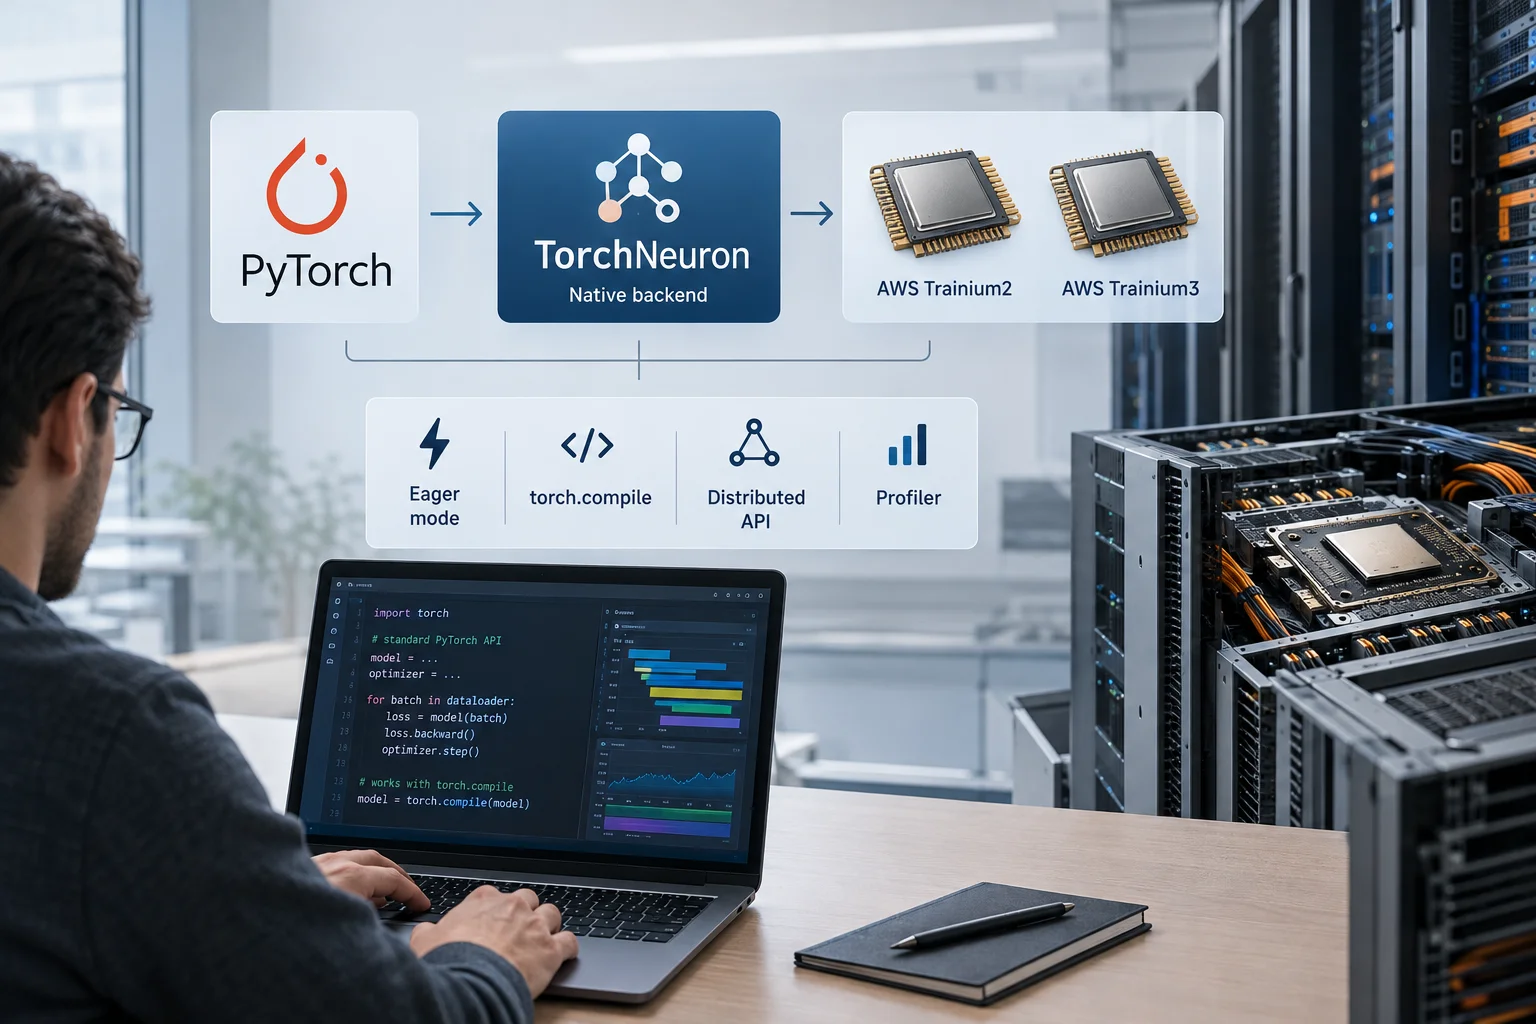
PyTorch uviedol TorchNeuron pre AWS Trainium ako natívny backend cez štandardné PyTorch API
PyTorch ekosystém oznámil TorchNeuron, open source natívny backend pre AWS Trainium2 a Trainium3. Praktická zmena pre tímy je v tom, že tréning aj inferencia majú ísť cez bežné PyTorch API vrátane eager režimu, torch.compile, distributed API a profileru, no prvé vydanie má aj jasne priznané limity.