PyTorch uviedol TorchNeuron pre AWS Trainium ako natívny backend cez štandardné PyTorch API
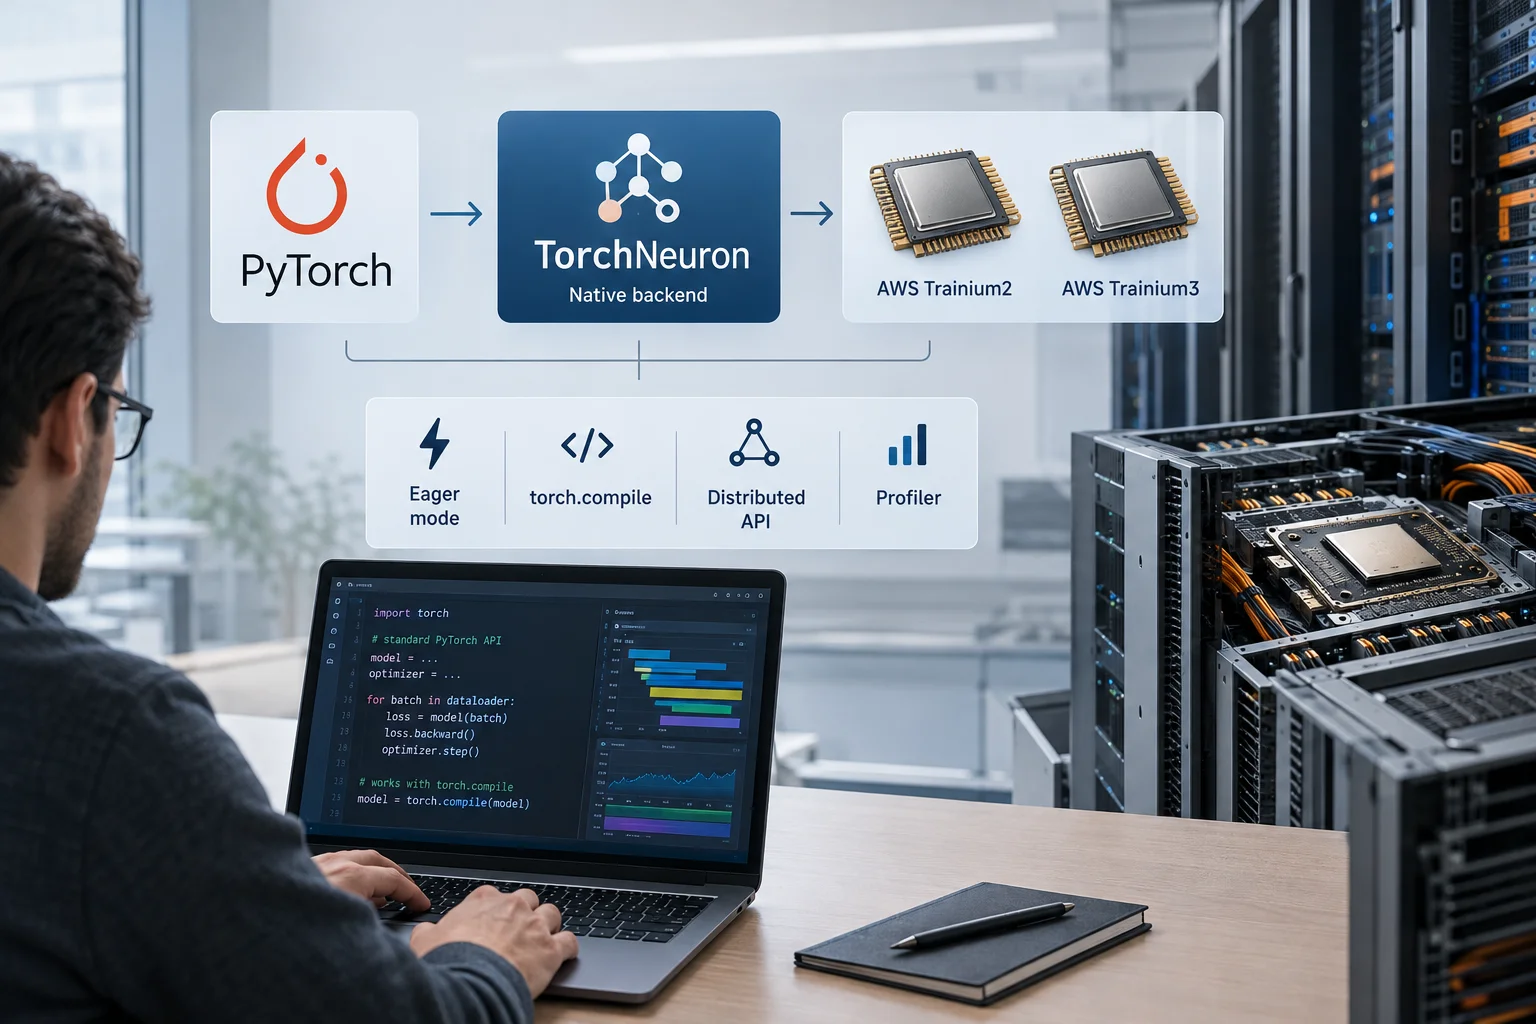
PyTorch ekosystém oznámil TorchNeuron, open source natívny backend pre AWS Trainium2 a Trainium3. Praktická zmena pre tímy je v tom, že tréning aj inferencia majú ísť cez bežné PyTorch API vrátane eager režimu, torch.compile, distributed API a profileru, no prvé vydanie má aj jasne priznané limity.
Hlavné poznatky
- TorchNeuron je podľa PyTorch/AWS open source natívny backend pre AWS Trainium2 a Trainium3 s verejnou betou od 2026-10-20.
- Najpraktickejšia zmena je integrácia cez štandardné PyTorch API vrátane `.to('neuron')`, `torch.compile`, `torch.distributed` a `torch.profiler`.
- Dodané zdroje zároveň priznávajú obmedzenia prvej verzie, takže tvrdenia o jednoduchom porte a úsporách nemožno brať ako univerzálne overený výsledok.
Čo sa mení pre PyTorch workflow na Trainium
Na konferencii PyTorch Conference North America 2026 PyTorch Foundation zaradila TorchNeuron medzi hlavné technické novinky ekosystému. Podľa detailného technického oznámenia ide o open source natívny PyTorch backend pre AWS Trainium, konkrétne pre Trainium2 a Trainium3, s verejnou betou od 20. októbra 2026 a licenciou Apache 2.0. Praktický význam tejto zmeny je v tom, že Trainium sa má v kóde správať ako štandardné PyTorch zariadenie neuron, namiesto oddeleného vendor-špecifického programovacieho modelu.
Pre vývojára je najviditeľnejšia zmena v rozhraní: model možno presunúť na zariadenie cez .to('neuron') a pre kompilovaný beh sa používa torch.compile(..., backend="neuron"), prípadne nastavenie predvoleného backendu. Dokument zároveň tvrdí, že moderný kód písaný proti device-agnostickému API torch.accelerator môže bežať bez úprav. To však neznamená automaticky rovnaký výkon pri každom modeli: konferenčný súhrn výslovne upozorňuje, že špičkový výkon môže vyžadovať ďalšie zmeny v tvaroch tenzorov, shardingu a operáciách.
Ako backend funguje a kam sa pripája v stacku
Mechanizmus integrácie je v podkladoch opísaný pomerne presne. TorchNeuron registruje Trainium cez PyTorch extension point PrivateUse1 a používa torch.accelerator, takže vyššie vrstvy PyTorch API majú fungovať bez zmeny rozhrania. Backend podporuje eager execution aj torch.compile. Eager režim je určený najmä na výskum a ladenie; dokument navyše uvádza experimentálny adaptive eager mode, ktorý má znižovať režijné náklady spúšťania operácií a približovať sa výkonu kompilovaného grafu bez zmeny kódu.
Pre stabilný výkon má slúžiť torch.compile, kde sa model zachytí do grafu, následne sa cez TorchDynamo a AOTAutograd pripraví dopredná aj spätná časť výpočtu a neuron backend ich zníži cez Torch-MLIR do StableHLO, z ktorého Neuron compiler vytvorí spustiteľný formát NEFF pre hardvér. Pre tímy, ktoré riešia škálovanie, je dôležité aj to, že text uvádza natívnu podporu pre torch.distributed, DTensor, DeviceMesh, kolektívne operácie, streamy a eventy. Profilovanie zostáva v známom torch.profiler, rozšírenom o NeuronConfig, a výstup možno prezerať v Neuron Exploreri.
Kde je prínos a kde sú dnešné hranice
Najsilnejšia doložená hodnota TorchNeuronu nie je v benchmarku, ale v integračnom modeli: ak tím už používa PyTorch, môže skúsiť presun tréningu alebo inferencie na Trainium s menším počtom zásahov do modelového kódu a do nástrojov okolo neho. Podklady uvádzajú aj prepojenie s TorchTitanom a pluginmi pre vLLM či vLLM Omni, takže cieľom nie je iba samotné spustenie modelu, ale zachovanie širšieho workflow pre tréning, serving a ladenie.
Zároveň ide o verejnú betu a dokument otvorene pomenúva hranice prvého vydania. Podpora TorchAO a FP8 je v čase oznámenia iba v private beta. V testoch existujú medzery v operator coverage a medzi explicitne nepodporovanými oblasťami sú sparse tensory a sparse operácie, NestedTensor, forward-mode autograd, dynamic a symbolic shapes či niektoré kvantizačné a attention scenáre. Aj preto treba výroky o jednoduchom porte a o výkonových či nákladových prínosoch čítať ako tvrdenia dodávateľa a partnerov, nie ako nezávisle overený priemer pre bežné nasadenie.
Pre čitateľa, ktorý rieši architektúru AI infraštruktúry, je teda novinka konkrétna: PyTorch dostáva natívny backend pre ďalší akcelerátorový cieľ, pričom najdôležitejším praktickým parametrom nie je iba dostupnosť čipu, ale to, že sa má začleniť do existujúceho PyTorch workflow cez štandardné API a nástroje — s jasne priznanými limitmi prvej verejnej bety.
Technický kontext
Stav overenia: Spracované podľa zdroja; redakcia postup nereprodukovala.
Verzie: Zdroj neuvádza konkrétne verzie.
Dátum pôvodného zdroja: 19. októbra 2026
Podmienky použitia: Znalosť PyTorch workflow, `torch.compile`, distribuovaného tréningu a základov akcelerátorových backendov.
Obmedzenia: Text je založený na oficiálnom technickom oznámení a konferenčnom súhrne. Neobsahuje nezávislé benchmarky ani reprodukovaný test redakcie; podporené sú iba mechanizmy, dostupnosť verejnej bety, licenčný stav a explicitne uvedené limity.
Zdroje
Súvisiace
Ďalšie články k téme
PyTorch pridáva FlyDSL na AMD MI350: kde sa backend vyberá a kedy zrýchli existujúce API
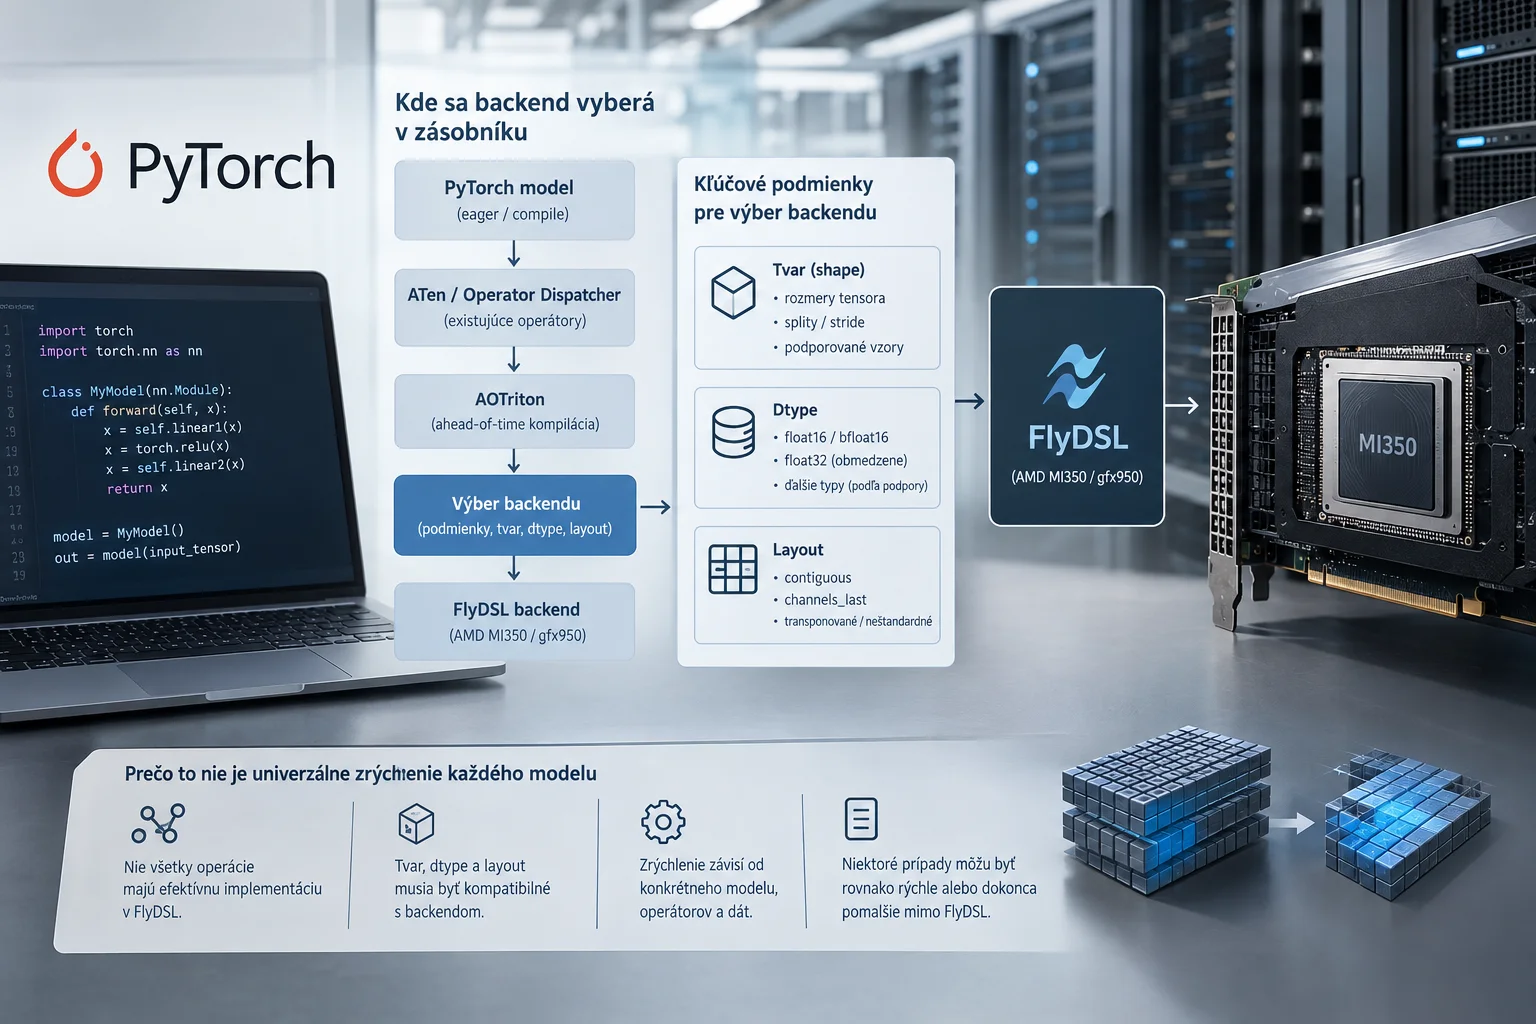
PyTorch podľa oficiálneho technického blogu sprístupňuje na AMD MI350/gfx950 backend FlyDSL cez existujúce operátory a AOTriton. Dôležité nie je len tvrdenie o zrýchlení, ale aj to, kde sa backend v zásobníku vyberá, aké má podmienky tvaru, dtype a layoutu a prečo to nie je univerzálne zrýchlenie každého modelu.
ExecuTorch prináša modely PyTorch priamo na mikrokontroléry Cortex-M
Nový backend využíva CMSIS-NN a kompiláciu pre konkrétny čip. Ukážka detekcie osoby zároveň vysvetľuje rozdiel medzi časom inferencie a rýchlosťou celej kamery.
AMD sprístupnilo veRL na ROCm pre Instinct GPU a ukázalo firemné merania na MI300 a MI350/MI355
AMD vo firemnom blogu z 8. septembra 2026 opisuje podporu frameworku veRL pre RL post-training na ROCm a GPU Instinct. Novinkou je pripravený kontajner, podpora rollout backendov vLLM a SGLang s AITER a séria výrobcom nameraných validačných behov na MI300 a MI350/MI355. Ide o odborný rozbor primárneho zdroja výrobcu, nie o nezávislé potvrdenie výkonu ani „production-ready“ tvrdení.
Zephon udrží poradie tréningových dát aj po zmene počtu GPU
Dátový loader pre TorchTitan rieši skrytý problém experimentov: iné rozdelenie výpočtu môže modelu predložiť iné dáta.